- Narzędzia sztucznej inteligencji
- Sztuczna inteligencja
Wyjaśnienie EmbeddingGemma 2: wyszukiwanie multimodalne i RAG
EmbeddingGemma 2 firmy Google przenosi tekst, kod, obrazy, dźwięk i wideo do wyszukiwania lokalnego. Oto, co się zmieniło, gdzie pasuje w RAG i co przetestować przed zmianą.
Wyobraź sobie, że szukasz w folderze projektu „schematu wyjaśniającego nasz proces wdrażania”. Odpowiedź może znajdować się na slajdzie, zrzucie ekranu lub chwili nagranych warsztatów, a nie w ładnie zatytułowanym dokumencie. System wyszukiwania wykorzystujący wyłącznie tekst musi wyodrębnić lub opisać ten materiał, zanim będzie mógł go znaleźć.
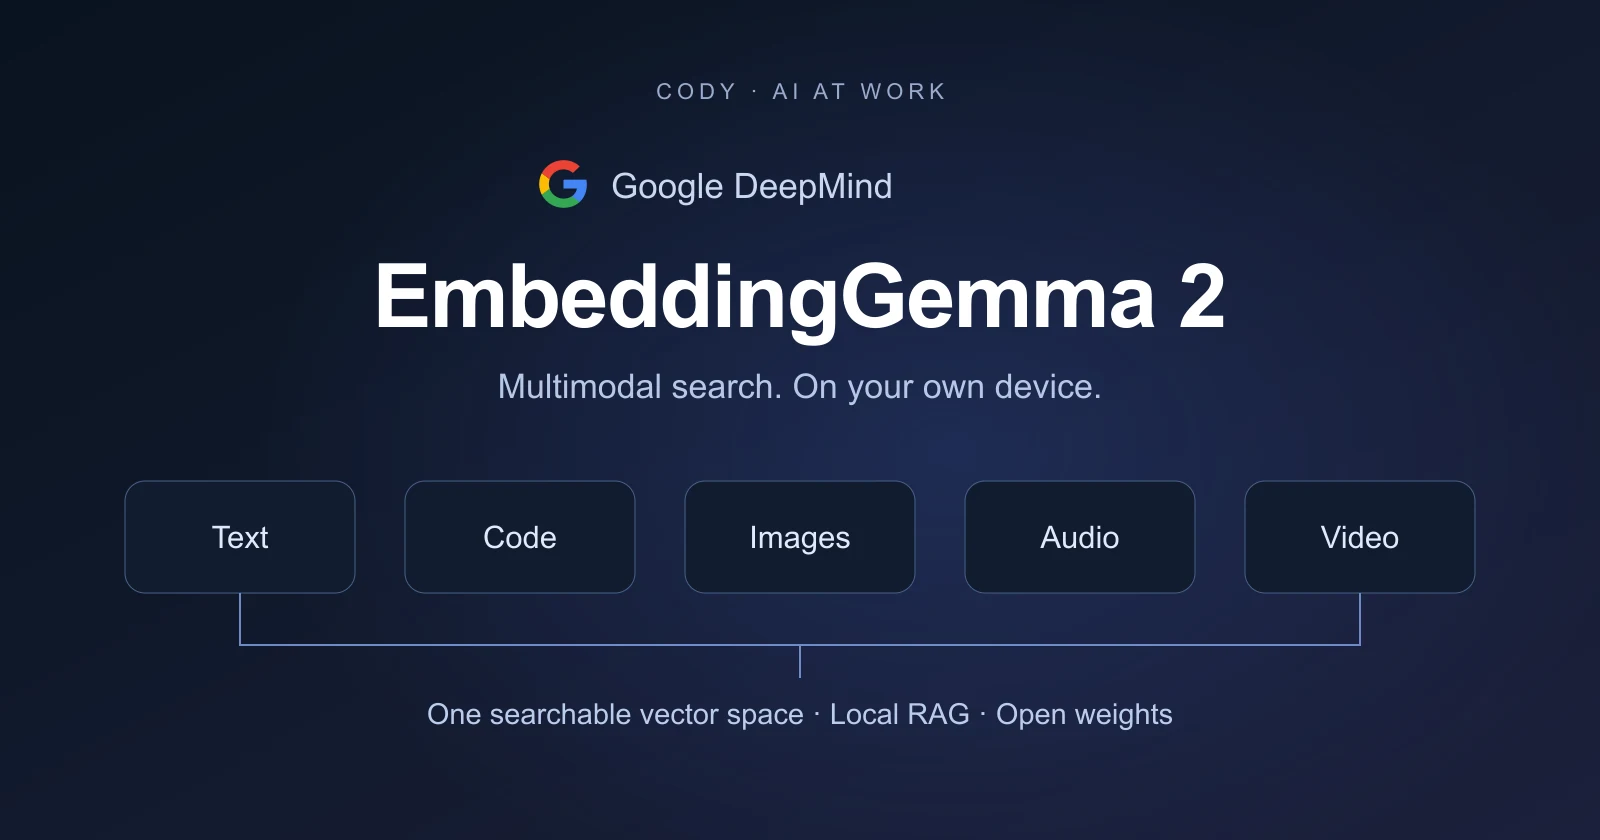
EmbeddingGemma 2 to nowy model Google o otwartej wadze, który rozwiązuje ten problem z wyszukiwaniem. Wydany 6 października 2026 r. reprezentuje tekst, kod, obrazy, dźwięk i wideo we współdzielonej przestrzeni wyszukiwania, z naciskiem na działanie na własnym sprzęcie. To jest komponent wyszukiwania, a nie kolejny chatbot. Ogłoszenie Google o uruchomieniu wyznacza lokalny, multimodalny kierunek.
Nasze zdanie: interesujące nie jest to, że każda firma powinna wymienić swoje obecne elementy osadzone. Chodzi o to, że prywatne wyszukiwanie mediów i lokalni asystenci AI mają teraz kolejny praktyczny element konstrukcyjny. To, czy usprawni to Twój system, zależy od tego, co chcesz odzyskać, gdzie musi działać i ile inżynierii chcesz posiadać.
Specyfikacje i łącza porównawcze można znaleźć w naszym profilu modelu EmbeddingGemma 2. Tutaj wyjaśnimy, co się zmieniło, gdzie to pasuje w RAG i jak to ocenić, nie gubiąc się w terminologii modelu.
Co to jest EmbeddingGemma 2, w prostym języku angielskim?
Osadzanie to numeryczna reprezentacja treści. Oprogramowanie wyszukujące porównuje te reprezentacje, aby znaleźć elementy, które są ze sobą w znaczący sposób powiązane, nawet jeśli ich sformułowania różnią się. Nie czytasz wektora; używasz go, aby znaleźć to, co naprawdę chcesz przeczytać, obejrzeć lub usłyszeć.
EmbeddingGemma 2 rozszerza tę ideę na media. Pytanie wpisane słownie może prowadzić do obrazu lub nagrania, a nie tylko do kolejnego fragmentu tekstu. Jego oficjalny punkt kontrolny Google zawiera komponent tekstowy oraz opcjonalne kodery wizyjne i audio. Możesz załadować części, których potrzebuje Twoja aplikacja, zamiast zawsze uruchamiać pełną konfigurację multimodalną.
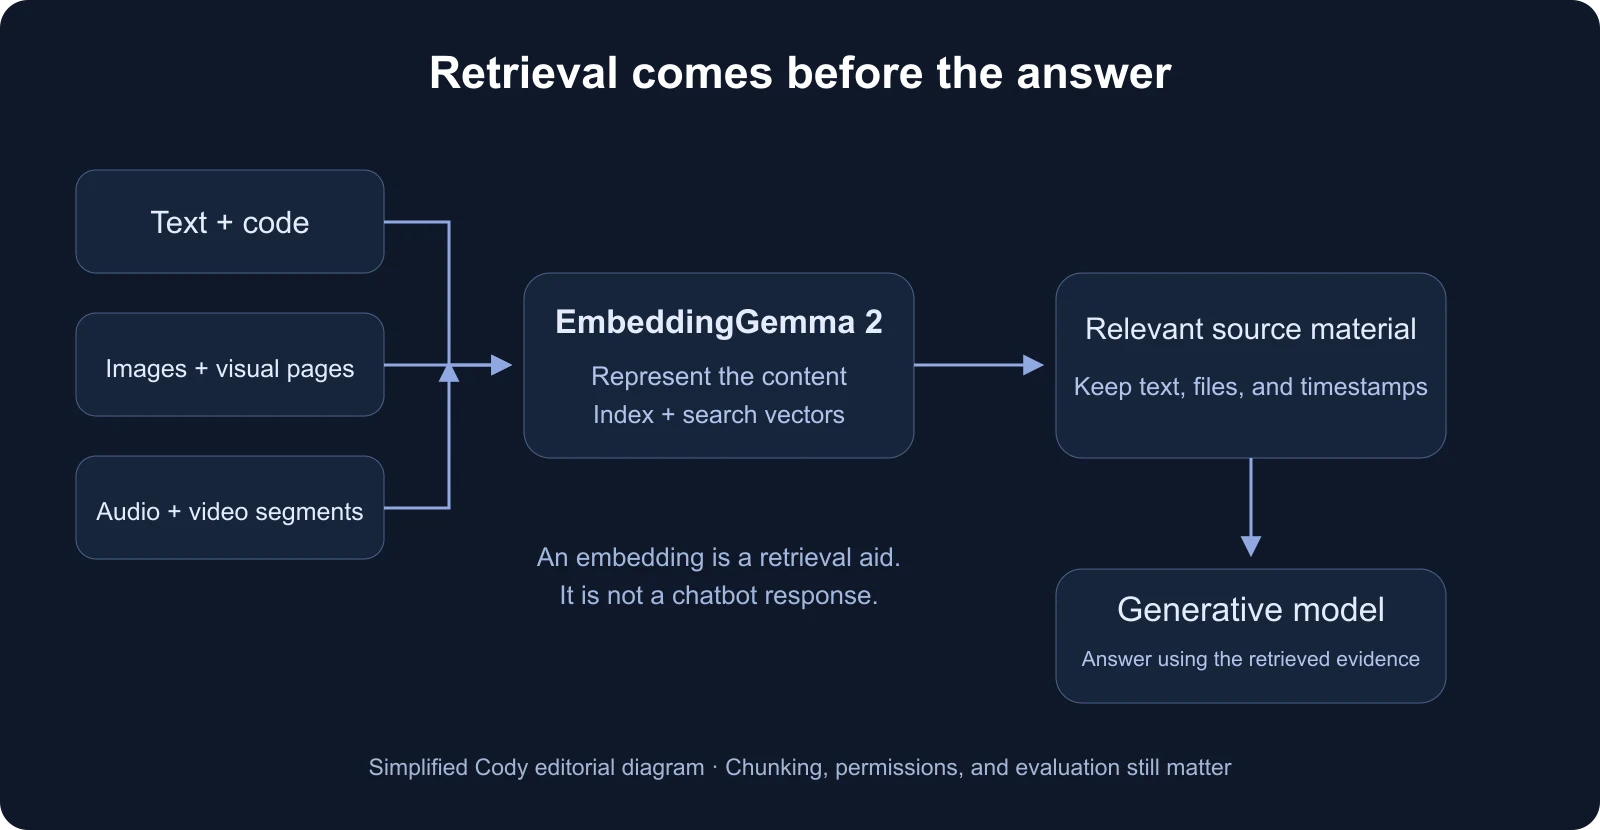
Pomyśl o tym jak o bibliotekarzu, a nie o autorze. Pomaga zidentyfikować przydatny materiał źródłowy. Oddzielny model generatywny może następnie przekształcić ten materiał w odpowiedź, a aplikacja nadal musi obsługiwać uprawnienia dostępu, cytaty i oryginalne pliki.
Ta separacja ma znaczenie. Przekonująca odpowiedź chatbota może ukryć słaby system wyszukiwania. Poprawa wyszukiwania zapewnia lepszy model odpowiedzi; nie sprawia to automatycznie, że każda odpowiedź jest poprawna.
EmbeddingGemma 2 vs EmbeddingGemma 1: co się zmieniło?
Oryginalny EmbeddingGemma był już kompaktowym, wielojęzycznym modelem do osadzania tekstu, przeznaczonym do użytku lokalnego. Wersja 2 nie jest początkiem historii wyszukiwania Google na urządzeniach. Głównym rozszerzeniem jest obsługa multimediów, a także lepsze wyniki wyszukiwania kodów. Google'a przegląd wersji odróżnia oba pokolenia.
| Co się liczy | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| Główne wejścia | Tekst | Tekst, kod, obrazy, dźwięk i wideo |
| Architektura | Oparty na Gemma 3 | Oparty na Gemma 4 |
| Opublikowany rozmiar | Parametry 308M | 270M dla tekstu/kodu; 740M ze wszystkimi enkoderami |
| Budżet kontekstowy | 2048 tokenów | 8192 tokenów udostępnionych w tekście i mediach |
| Rozmiary wektorowe | 768, z mniejszymi obsługiwanymi rozmiarami | Wymiary 768, 512, 256 lub 128 |
| Licencja na ciężary | Warunki Gemmy | Apache 2.0 |
Specyfikacje i licencja wersji 2 są udokumentowane w Google karta modelu. Warto zwrócić uwagę na mniejszą konfigurację zawierającą wyłącznie tekst: dodanie możliwości obsługi multimediów nie oznacza, że każda aplikacja musi obsługiwać pełny model.
W przypadku istniejącej bazy wiedzy tekstowej jest to powód do oceny, a nie zlecenie automatycznej migracji. Jeśli wersja 1 już niezawodnie znajduje właściwe fragmenty, nowe kodery obrazu i dźwięku mogą rozwiązać problem, którego Ty nie masz. Zespół poszukujący kodu, instrukcji wizualnych lub nagrań ma bardziej oczywisty powód, aby wypróbować wersję 2.
Dlaczego ma to znaczenie dla RAG i wiedzy prywatnej
Generowanie wspomagane wyszukiwaniem, czyli RAG, oznacza znalezienie odpowiedniego materiału źródłowego przed poproszeniem modelu AI o odpowiedź. Jakość tego pierwszego kroku kształtuje wszystko, co następuje.
Znanym przykładem jest wewnętrzny asystent wsparcia. Pisemne uwagi dotyczące rozwiązywania problemów mogą wyjaśnić usterkę, ale technik może również potrzebować zdjęcia z adnotacjami przedstawiającymi prawidłowe złącze. Multimodalna warstwa wyszukiwania może pomóc w połączeniu tych elementów. Jest to hipotetyczny przypadek użycia, a nie twierdzenie, że model ten przeszedł ocenę wsparcia o krytycznym znaczeniu dla bezpieczeństwa.
Najpierw rozważymy trzy rodzaje pilota:
- Prywatna biblioteka multimediów: umożliwia wyszukiwanie przydatnych zrzutów ekranu, zdjęć produktów lub instrukcji wizualnych w zwykłym języku.
- Lokalny asystent programisty: pobiera odpowiedni kod bez wysyłania całego repozytorium do usługi osadzania.
- Archiwum nagrań z możliwością przeszukiwania: zwraca odpowiedni segment i jego znacznik czasu, zamiast zmuszać kogoś do przeglądania całego nagrania.
W każdym przypadku wyszukiwanie powinno odnosić się do dowodów. Zachowaj odniesienie do pliku, sekcję dokumentu, zakres dostępu i sygnaturę czasową multimediów obok wektora. Podobnie wyglądający wynik nie wystarczy, jeśli użytkownik nie może go otworzyć ani zrozumieć, dlaczego został zwrócony.
Nie zastępuje także przygotowania dokumentów. Znalezienie strony wizualnej i wyodrębnienie tabeli o jakości arkusza kalkulacyjnego to różne zadania. Jeśli Twoim problemem jest zepsuta kolejność czytania plików PDF, brakujące nagłówki lub niewiarygodne wyodrębnianie tabeli, zacznij od warstwy przetwarzania. Nasz Przewodnik po Doclingu i Wyjaśnienie Cohere Parse zakryć tę stronę rurociągu.
Co faktycznie pokazują testy porównawcze Google
Opublikowane wyniki opowiadają bardziej konkretną historię niż „lepiej we wszystkim”. W pełnej precyzji, 768-wymiarowej ocenie na karcie modelu Google, wielojęzyczny wynik MTEB wzrósł z 61,15 do 61,36. Wynik kodu MTEB wzrósł z 68,76 do 78,68, co stanowi względny wzrost o około 14% w porównaniu z tą konkretną oceną. To są wyniki zgłoszone przez Google, a nie nasze własne testy. Tabele testów porównawczych zawierają nazwy wersji ewaluacyjnych i metryk.
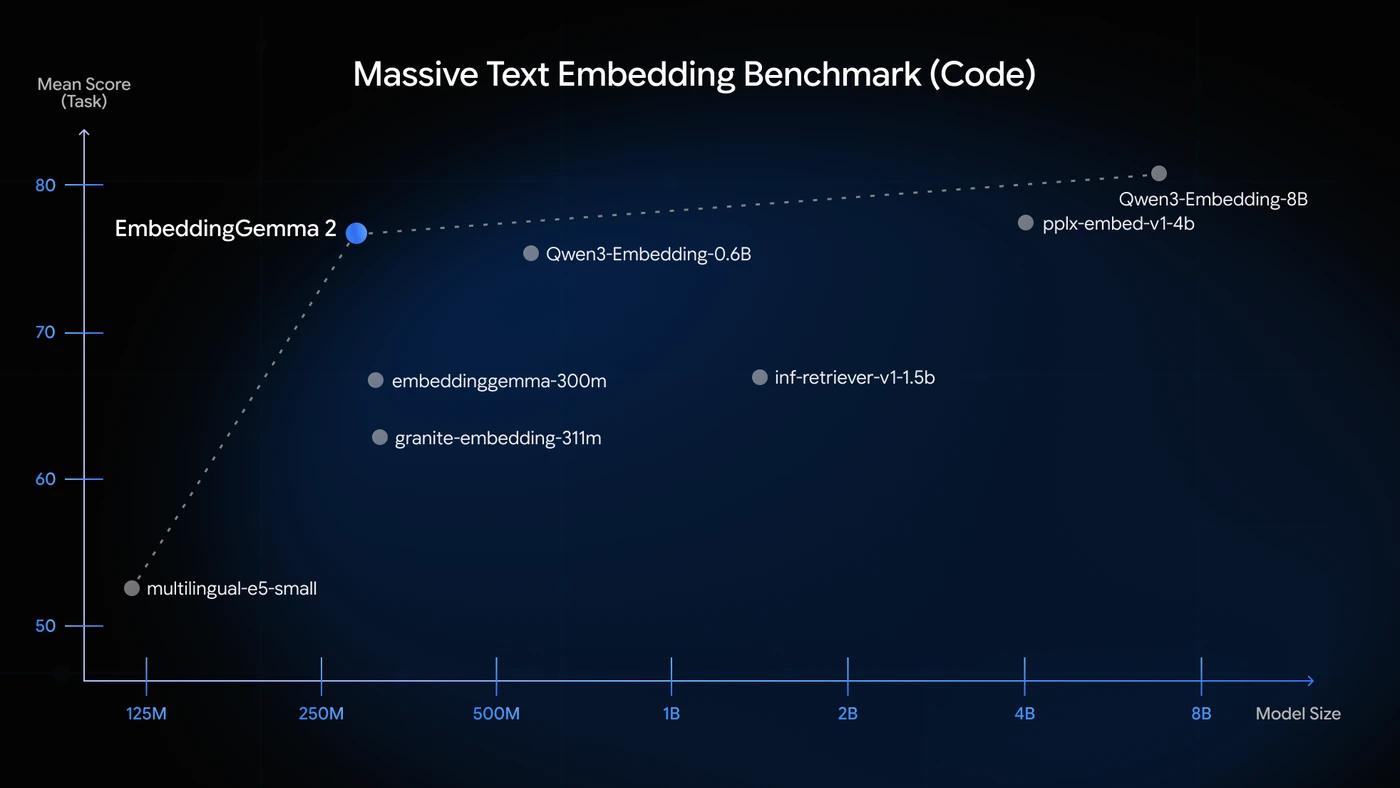
Z naszych odczytów wynika, że nagłówek jest szeroki i zapewnia lepsze wyszukiwanie kodu, przy mniej więcej zachowanej wydajności tekstu wielojęzycznego. Jest to bardziej przydatne niż traktowanie wartości procentowej z jednego punktu odniesienia jako obiecanej poprawy każdego zapytania wyszukiwanego przez firmę.
Właściwym pytaniem uzupełniającym jest: czy pobiera twój odpowiednie źródła? Model może osiągać dobre wyniki w zadaniach publicznych, a mimo to mieć problemy ze skrótami, nietypowymi diagramami, plikami w różnych językach lub kiepskimi nagraniami. Mały zestaw ewaluacyjny składający się z prawdziwych pytań i oczekiwanych dowodów jest bardziej praktyczny niż uniwersalna etykieta zwycięzcy.
Lokalny nie oznacza darmowy – lub automatycznie prywatny
Otwarte wagi zmieniają strukturę kosztów. W tej wersji nie kupujesz stałej stawki tokena z hostowanego przez Google osadzania API. Jesteś odpowiedzialny za obliczenia, pamięć, czas indeksowania, wdrożenie i konserwację. Wersja Apache 2.0 umożliwia inną ścieżkę wdrożenia; nie usuwa kosztów operacyjnych.
Może to być atrakcyjne, gdy treść musi znajdować się w pobliżu użytkownika lub działać bez połączenia sieciowego. Google'a Przewodnik po AI Edge demonstruje wyszukiwanie lokalnych multimediów i pobieranie wideo na urządzeniach konsumenckich. Pomiary pamięci i opóźnień są powiązane z konkretnymi urządzeniami, konfiguracjami i obciążeniami — nie jest to gwarancja dla każdego laptopa lub telefonu.
W przypadku pilota zmierzylibyśmy całe doświadczenie: czas tworzenia pierwszego indeksu, szybkość zwracania zapytań po indeksowaniu, maksymalną ilość pamięci podczas przetwarzania, wpływ baterii i co się dzieje, gdy zmieniają się pliki. Szybkie zapytanie to nie to samo, co szybki import początkowy.
Prywatność jest także właściwością aplikacji. Wnioskowanie o osadzaniu lokalnym może uniemożliwić materiał źródłowy osadzanie zdalne API. Jednak kopie zapasowe w chmurze, dane telemetryczne, zdalna baza danych wektorowych lub hostowany model odbierania mogą nadal przenosić dane gdzie indziej. Zamapuj pełną ścieżkę danych przed wywołaniem systemu jako „w pełni lokalnego”.
Podobnie wektory nie są systemem kontroli dostępu. Zachowaj uprawnienia źródła i filtruj wyniki dla osoby zadającej pytanie. Plik prywatny nie powinien stać się wykrywalny tylko dlatego, że jego wektor ma ten sam indeks co materiał publiczny.
Mniejsze wektory: przydatne oszczędności przy prawdziwym kompromisie
Model obsługuje skracanie osadzania, technikę zwaną Matryoshka Representation Learning. Google'a przewodnik programisty wyjaśnia obsługiwane rozmiary i potrzebę ponownej normalizacji wektora po obcięciu.
Praktyczny pomysł jest prosty: przechowywanie mniejszej liczby liczb na element może zmniejszyć duży indeks. Zmniejszenie wektora z 768 do 128 wymiarów powoduje sześciokrotne zmniejszenie surowego ładunku wektorowego, gdy format liczb pozostaje taki sam. Nie sprawia to, że cała aplikacja lub baza danych jest sześciokrotnie tańsza; oryginalne pliki, metadane i narzut na indeks wyszukiwania nadal istnieją.
Nawet najmniejsze ustawienie nie oznacza darmowego podniesienia jakości. Wyniki Google pokazują bardziej znaczący spadek multimodalny przy 128 wymiarach niż przy 256 czy 512. Rozpoczęliśmy pilotażowe wyszukiwanie multimediów od rozmiaru natywnego, ustaliliśmy linię bazową wyszukiwania, a następnie testowaliśmy mniejsze wektory w oparciu o te same pytania. Zapytania i indeksowane elementy muszą używać zgodnych wymiarów.
Jest to dobra optymalizacja do wykonania po udowodnieniu przydatności. Zapisywanie pamięci w indeksie, który zwraca nieprawidłowe nagranie, nie jest wielkim sukcesem.
EmbeddingGemma 2 kontra Gemini Embedding 2, OpenAI i Cohere
Nie są to zamienne modele dostawy. Pierwszą decyzją jest często to, czy chcesz samodzielnie uruchomić osadzanie, czy skorzystać z usługi zarządzanej. Publiczne testy porównawcze nie wyznaczają sprawiedliwego zwycięzcy w każdym środowisku wykonawczym, korpusie i modalności.
Gemini Embedding 2: zarządzane pobieranie multimodalne
Gemini Embedding 2 to hostowana przez Google opcja osadzania multimodalnego. Aktualny przewodnik API obsługuje tekst, obrazy, dźwięk, wideo i pliki PDF, z domyślnym wyjściem o 3072 wymiarach i konfigurowalnymi mniejszymi wyjściami. Dokumentacja Google dotycząca osadzania Gemini stanowi odniesienie do zachowania API.
Nasz pogląd: rozważ rozwiązanie Gemini, gdy priorytetem jest zarządzana infrastruktura; rozważ EmbeddingGemma, gdy centralne znaczenie ma obsługa lokalna lub kontrola nad wdrożeniem. Kompromis nie polega po prostu na „dużych wektorach kontra małych wektorach”. Ty wybierasz, gdzie ma miejsce przetwarzanie i kto nim zarządza. Zobacz porównanie EmbeddingGemma 2 vs Gemini Embedding 2.
OpenAI text-embedding-3-large: API zorientowany na tekst
OpenAI text-embedding-3-large to hostowany model osadzania tekstu, a nie natywny zamiennik osadzania obrazu, dźwięku lub wideo. OpenAI dokumentuje domyślny wynik 3072 wymiarów i sposób żądania mniejszej liczby wymiarów. Obecnie podana standardowa cena API wynosi 0,13 USD za milion tokenów wejściowych; oznacza to użycie API, a nie subskrypcję ChatGPT. Przewodnik osadzania OpenAI i Ceny API wyjaśnić zakres.
W przypadku dobrze przygotowanego korpusu tekstowego prostszym wyborem może okazać się zarządzana usługa tekstowa. W przypadku natywnego pobierania multimediów lub indeksowania offline rozwiązujesz inny problem. Nasz Strona porównawcza OpenAI oddziela te możliwości od cen.
Cohere Embed 4: kolejna istniejąca opcja multimodalna
W ofercie Cohere, Osadź 4 obsługuje tekst, obrazy i mieszaną zawartość dokumentów. Dzięki temu jest to trafne porównanie w przypadku wyszukiwania korporacyjnego, zwłaszcza gdy dokumenty źródłowe zawierają zarówno informacje pisemne, jak i wizualne. Aktualna dokumentacja osadzania Cohere wymienia rodzinę modeli i możliwości.
Porównalibyśmy rzeczywiste obciążenie dokumentami, wymagania dotyczące wdrożenia i opcje zaopatrzenia, nie zakładając, że wszystkie modele „multimodalne” przetwarzają te same pliki w ten sam sposób. Opublikowane fakty można znaleźć w artykule EmbeddingGemma 2 vs Cohere Embed 4.
Jak tego spróbować, nie zamieniając tego w projekt badawczy
Zacznij od pytania, na które ludzie już mają trudności z udzieleniem odpowiedzi. Wybierz ograniczoną kolekcję — jedno repozytorium kodu, folder instrukcji wizualnych lub mały zestaw nagrań. Unikaj indeksowania wszystkiego, zanim dowiesz się, jak wygląda sukces.
W ramach wizualnego wprowadzenia przykłady AI Edge Gallery firmy Google przedstawiają Instant Media Search i Video Moments Finder. To samo ogłoszenie AI Edge opisuje eksperymentalny towarzysz spotkań lokalnych dla komputerów Mac. Opisuje także nadchodzącą integrację ML Kit z Androidem; nie zakładaj, że ogłoszona przyszła integracja jest już dostępna.
Dla programistów dokumentacja Transformers wyjaśnia komponenty modelu i przetwarzanie multimediów. Wyszukiwanie wideo wykorzystuje próbkowane klatki, więc krótkie zdarzenie pomiędzy próbkami może zostać pominięte. Kontekst jest współdzielony pomiędzy danymi wejściowymi żądania; dłuższe nagrania i zbiory dokumentów nadal wymagają rozsądnej segmentacji.
Zapisz dwa szczegóły wdrożenia na liście kontrolnej. Najpierw postępuj zgodnie z udokumentowanymi zapytaniami i dokumentuj monity o zadania, zamiast traktować wszystkie dane wejściowe w identyczny sposób. Po drugie, użyj obsługiwanej precyzji numerycznej: wskazówki Google dotyczące punktów kontrolnych zalecają bfloat16 lub float32 i ostrzegają przed float16. Są to szczegóły przeznaczone dla osoby tworzącej pilotaż, a nie decyzje, które powinien podjąć użytkownik końcowy. Oficjalne instrukcje punktu kontrolnego obejmują oba.
Następnie przetestuj więcej niż proste wyszukiwania. Uwzględnij elementy bliskie dopasowania, które nie powinny być zwracane, brakujące informacje, pytania w różnych językach i pliki, do których użytkownik nie ma dostępu. Sprawdź, czy w pierwszych kilku wynikach pojawia się właściwe źródło, i sprawdź dowody, zamiast oceniać tylko ostateczną odpowiedź.
W przypadku migracji z innego modelu zalecamy utworzenie osobnego indeksu kandydującego i ponowne osadzenie korpusu testowego. Dopasowane długości wektorów nie zapewniają kompatybilności pomiędzy różnymi modelami. Przed zastąpieniem indeksu roboczego porównaj dwa systemy w tej samej kolekcji źródeł.
Wniosek na wynos: szerszy zestaw narzędzi do wyszukiwania, a nie uniwersalny zamiennik
EmbeddingGemma 2 jest najciekawszy tam, gdzie użyteczna wiedza jest rozpowszechniana w mediach i gdzie lokalne przetwarzanie ma jasny cel. Rozszerza to, co może przeszukiwać otwarta warstwa wyszukiwania, jednocześnie umożliwiając aplikacjom ładowanie tylko tych koderów, których potrzebują.
Naszą rekomendacją jest potraktowanie go jako ukierunkowanego pilotażu: udowodnienie, że znajduje właściwe dowody, zweryfikowanie ścieżki danych i zmierzenie rzeczywistego kosztu urządzenia. Jeśli rozwiąże to te problemy, rozmiar modelu i ustawienia wektorów staną się przydatnymi wyborami inżynieryjnymi. Jeśli tak nie jest, mocny nagłówek testu porównawczego nie jest wystarczającym powodem do zmiany.
Przeglądaj osadzanie biblioteki modeli znaleźć alternatywy lub skorzystać z Profil EmbeddingGemma 2 dla jego źródeł, notatek dotyczących wdrożenia i ukierunkowanych porównań. To jest edukacyjna recenzja wersji Google, a nie ogłoszenie, że Cody zapewnia wnioskowanie EmbeddingGemma.
Często zadawane pytania
Czy EmbeddingGemma 2 jest chatbotem?
Nie. Tworzy wektory osadzające, których oprogramowanie używa do wyszukiwania, porównywania, klasyfikacji lub grupowania. Jeśli aplikacja ma napisać odpowiedź, potrzebny jest odrębny model generatywny.
Czy EmbeddingGemma 2 jest darmowy?
Google publikuje wagi pod Apache 2.0. Nie oznacza to jednak, że moc obliczeniowa, pamięć masowa i hosting są bezpłatne. W dokumentacji wydania nie ma jednej stałej szybkości tokena hostowanego API.
Co się zmieniło w stosunku do EmbeddingGemma 1?
Wersja 2 dodaje natywne pobieranie obrazu, dźwięku i wideo wraz z tekstem i kodem, rozszerza budżet kontekstowy i oferuje modułowe kodery. Oceny Google pokazują lepszy wynik kodu i prawie niezmienioną wydajność tekstu wielojęzycznego.
Czy EmbeddingGemma 2 może działać w trybie offline?
Wnioskowanie lokalne może obsługiwać wyszukiwanie w trybie offline, gdy na urządzeniu znajdzie się wymagane oprogramowanie, wagi i zindeksowana zawartość. Kompletna aplikacja jest w trybie offline tylko wtedy, gdy inne jej komponenty nie wymagają usług zdalnych.
Czy EmbeddingGemma 2 jest lepszy niż Gemini Embedding 2?
Nie ma tu ustalonego uniwersalnego zwycięzcy. EmbeddingGemma 2 zapewnia otwarte wagi do wdrożenia lokalnego lub samodzielnego, podczas gdy Gemini Embedding 2 to zarządzany API. Porównaj jakość pobierania, obsługę multimediów, koszty i wymagania dotyczące wdrażania na własnych danych.
Czy zastępuje parser dokumentów lub bazę danych wektorowych?
Nie. Reprezentuje treść do wyszukiwania. Analizowanie, dzielenie na fragmenty, uprawnienia do źródła, indeksowanie wektorów i generowanie odpowiedzi pozostają odrębnymi obowiązkami w systemie RAG.