- herramientas de inteligencia artificial
- Inteligencia artificial
EmbeddingGemma 2 Explicado: Búsqueda multimodal y RAG
EmbeddingGemma 2 de Google incorpora texto, código, imágenes, audio y vídeo a la búsqueda local. Esto es lo que cambió, dónde encaja en RAG y qué probar antes de cambiar.
Imagínese buscar en una carpeta de proyecto "el diagrama que explica nuestro proceso de incorporación". La respuesta podría estar en una diapositiva, una captura de pantalla o un momento de un taller grabado, no en un documento con un título elegante. Un sistema de búsqueda de sólo texto tiene que extraer o describir ese material antes de poder encontrarlo.
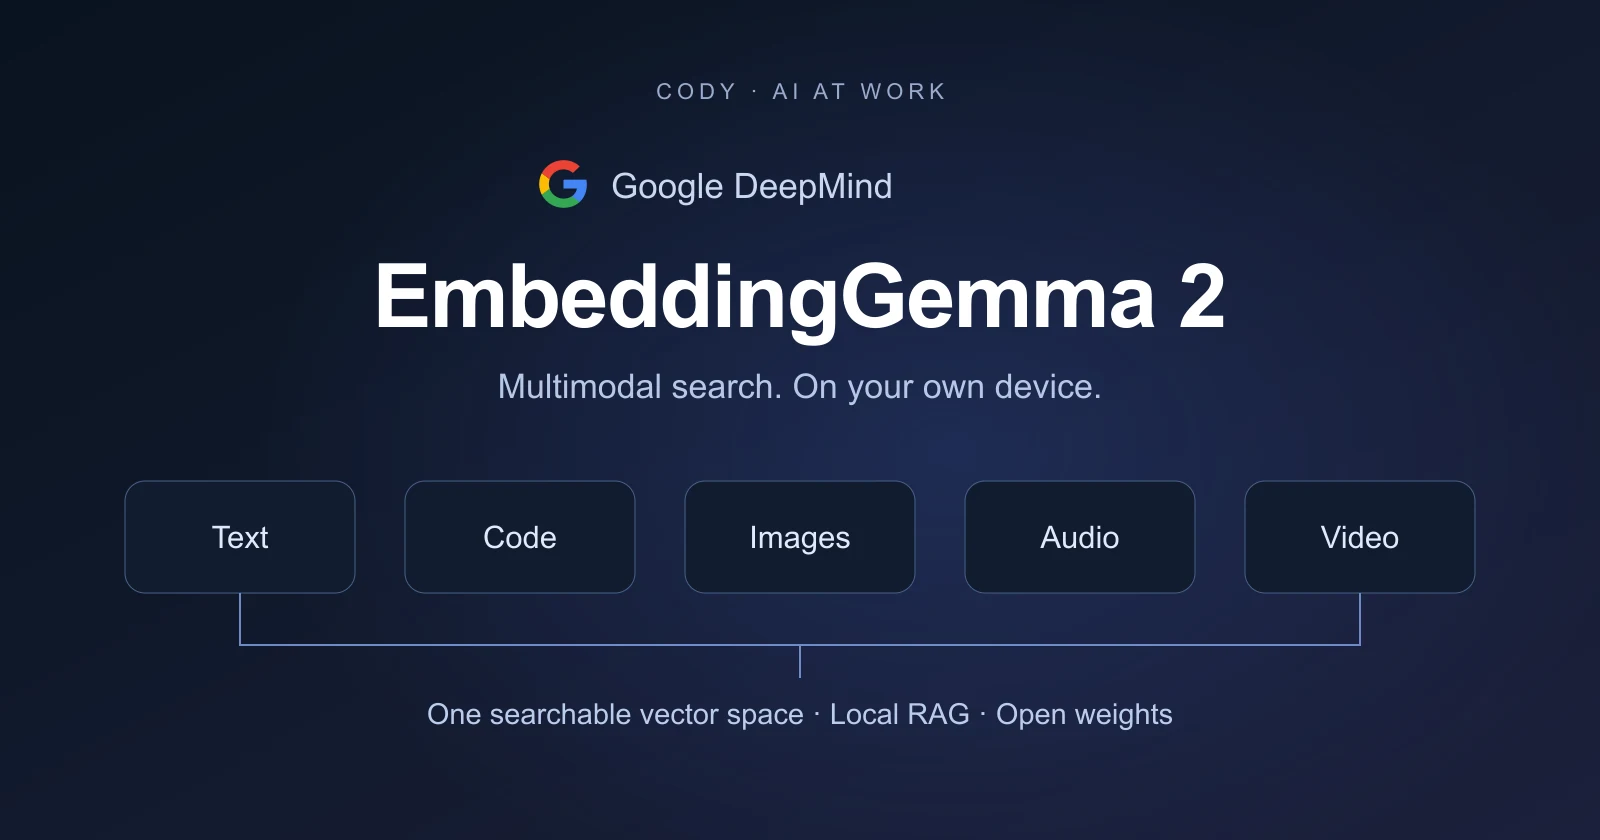
EmbeddingGemma 2 es el nuevo modelo de peso abierto de Google para ese problema de recuperación. Lanzado el 6 de octubre de 2026, representa texto, código, imágenes, audio y video en un espacio de búsqueda compartido, con énfasis en ejecutarse en su propio hardware. Este es un componente de búsqueda, no otro chatbot. El anuncio de lanzamiento de Google establece la dirección local y multimodal.
Nuestra opinión: lo interesante no es que todas las empresas deban reemplazar sus integraciones actuales. Es que la búsqueda de medios privados y los asistentes locales de IA ahora tienen otro componente práctico. Que mejore su sistema depende de lo que necesita recuperar, dónde debe ejecutarse y cuánta ingeniería desea poseer.
Para conocer las especificaciones y los enlaces de comparación, consulte nuestro perfil de modelo EmbeddingGemma 2. Aquí explicaremos qué cambió, dónde encaja en RAG y cómo evaluarlo sin perdernos en la terminología del modelo.
¿Qué es EmbeddingGemma 2, en lenguaje sencillo?
Una incrustación es una representación numérica del contenido. El software de búsqueda compara esas representaciones para encontrar elementos que estén significativamente relacionados, incluso cuando su redacción difiere. No lees el vector; lo usas para encontrar lo que realmente quieres leer, ver o escuchar.
EmbeddingGemma 2 extiende esa idea a todos los medios. Una pregunta escrita con palabras puede conducir a una imagen o una grabación, en lugar de simplemente otro pasaje de texto. su punto de control oficial de Google Incluye un componente de texto y codificadores de audio y visión opcionales. Puede cargar las partes que su aplicación necesita en lugar de ejecutar siempre la configuración multimodal completa.
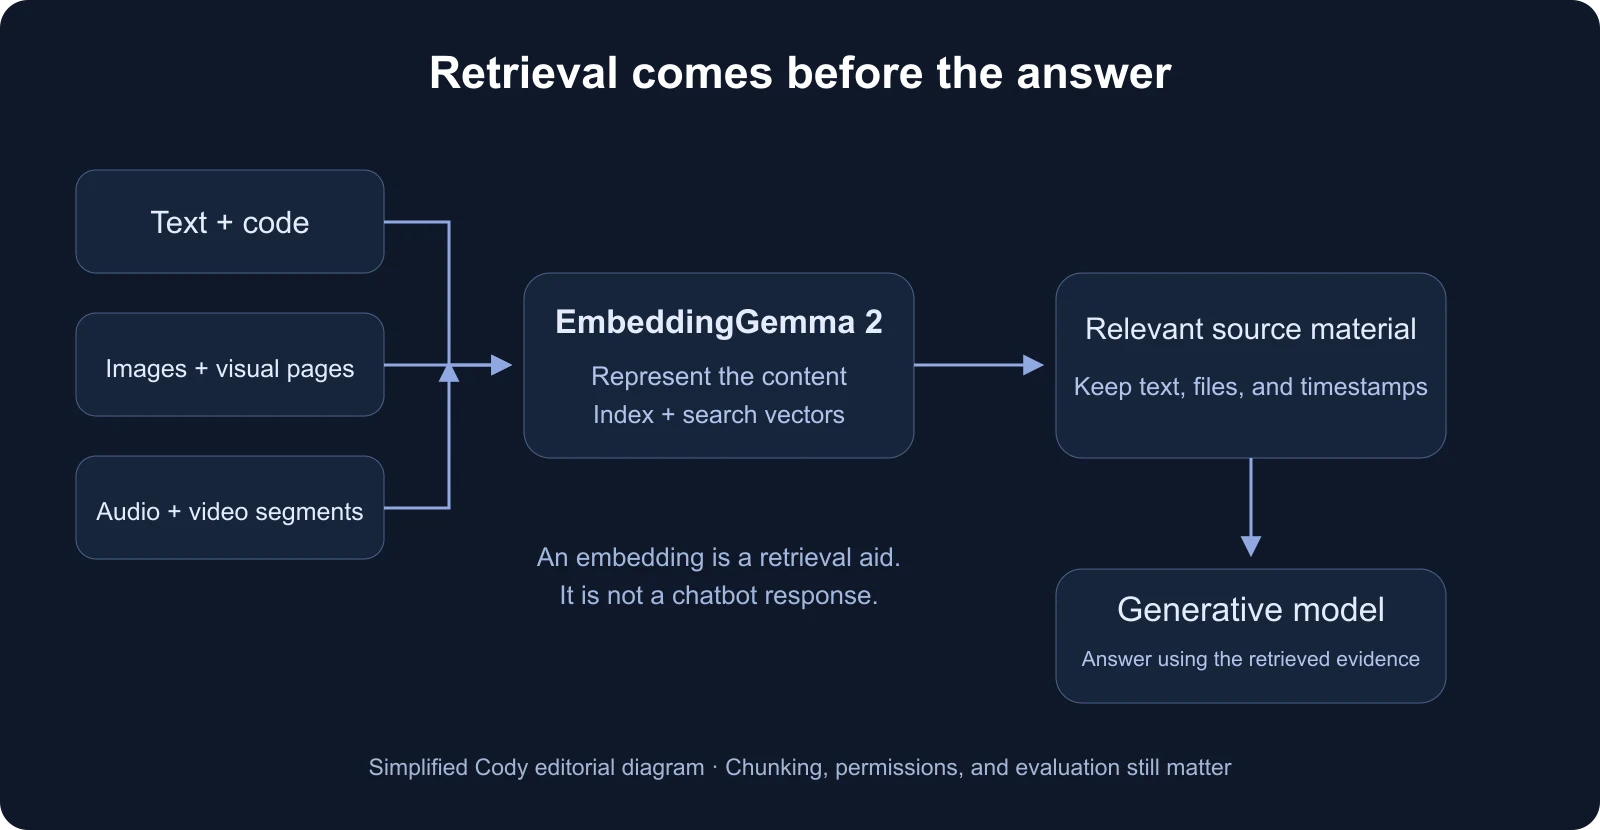
Piense en ello como el bibliotecario, no como el autor. Ayuda a identificar material fuente útil. Luego, un modelo generativo separado puede convertir ese material en una respuesta, y la aplicación aún tiene que manejar los permisos de acceso, las citas y los archivos originales.
Esa separación importa. Una respuesta convincente de un chatbot puede ocultar un sistema de búsqueda débil. Mejorar la recuperación le da al modelo de respuesta una mejor evidencia; no hace que todas las respuestas sean correctas automáticamente.
EmbeddingGemma 2 vs EmbeddingGemma 1: ¿qué cambió?
El EmbeddingGemma original ya era un modelo compacto de incrustación de texto multilingüe diseñado para uso local. La versión 2 no es el comienzo de la historia de búsqueda en dispositivos de Google. La principal expansión es el soporte de los medios, junto con un resultado de recuperación de código más sólido. de google descripción general de la versión distingue a las dos generaciones.
| lo que importa | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| Entradas principales | Texto | Texto, código, imágenes, audio y vídeo. |
| Arquitectura | Basado en Gemma 3 | Basado en Gemma 4 |
| Tamaño publicado | Parámetros de 308M | 270M para texto/código; 740M con todos los codificadores |
| Presupuesto de contexto | 2.048 fichas | 8,192 tokens compartidos en texto y medios |
| Tamaños de vectores | 768, con tamaños admitidos más pequeños | 768, 512, 256 o 128 dimensiones |
| licencia de pesas | términos de gema | Apache 2.0 |
Las especificaciones y la licencia de la versión 2 están documentadas en la página de Google. tarjeta modelo. Vale la pena destacar la configuración más pequeña de solo texto: agregar capacidad multimedia no significa que cada aplicación deba llevar el modelo completo.
Para una base de conocimiento de texto existente, esta es una razón para evaluar, no una orden de migración automática. Si la versión 1 ya encuentra los pasajes correctos de manera confiable, los nuevos codificadores de imagen y audio pueden resolver un problema que usted no tiene. Un equipo que busca código, instrucciones visuales o grabaciones tiene una razón más obvia para probar la versión 2.
Por qué es importante para RAG y el conocimiento privado
La generación de recuperación aumentada, o RAG, significa encontrar material fuente relevante antes de pedirle a un modelo de IA que responda. La calidad de ese primer paso da forma a todo lo que sigue.
Un ejemplo familiar es el de un asistente de soporte interno. Las notas escritas sobre solución de problemas pueden explicar una falla, pero un técnico también puede necesitar la fotografía comentada que muestra el conector correcto. Una capa de recuperación multimodal podría ayudar a unir esas piezas. Se trata de un caso de uso hipotético, no de una afirmación de que este modelo haya pasado una evaluación de soporte crítico para la seguridad.
Primero consideraríamos tres tipos de piloto:
- Una biblioteca multimedia privada: para encontrar capturas de pantalla útiles, fotografías de productos o instrucciones visuales en lenguaje común.
- Un asistente de desarrollador local: que recupera el código relevante sin enviar todo el repositorio a un servicio integrado.
- Un archivo de grabación con capacidad de búsqueda: devuelve un segmento relevante y su marca de tiempo, en lugar de hacer que alguien hojee una grabación completa.
En cada caso, la recuperación debe apuntar a la evidencia. Mantenga la referencia del archivo, la sección del documento, el alcance del acceso y la marca de tiempo del medio junto al vector. Un resultado similar no es suficiente si el usuario no puede abrirlo o comprender por qué se devolvió.
Tampoco reemplaza la preparación de documentos. Encontrar una página visual y extraer una tabla con calidad de hoja de cálculo son trabajos diferentes. Si su problema es un orden de lectura de PDF roto, títulos faltantes o una extracción de tablas poco confiable, comience con la capa de ingesta. Nuestro guía de docking y Explicador Cohere Parse cubrir ese lado de la tubería.
Lo que realmente muestran los puntos de referencia de Google
Los resultados publicados cuentan una historia más específica que "mejor en todo". En la evaluación de 768 dimensiones de precisión total en la tarjeta modelo de Google, la puntuación multilingüe MTEB pasa de 61,15 a 61,36. La puntuación del código MTEB pasa de 68,76 a 78,68, aproximadamente un aumento relativo del 14% en esa evaluación en particular. Estos son resultados informados por Google, no nuestras propias pruebas. Las tablas de referencia nombran las versiones y métricas de evaluación.
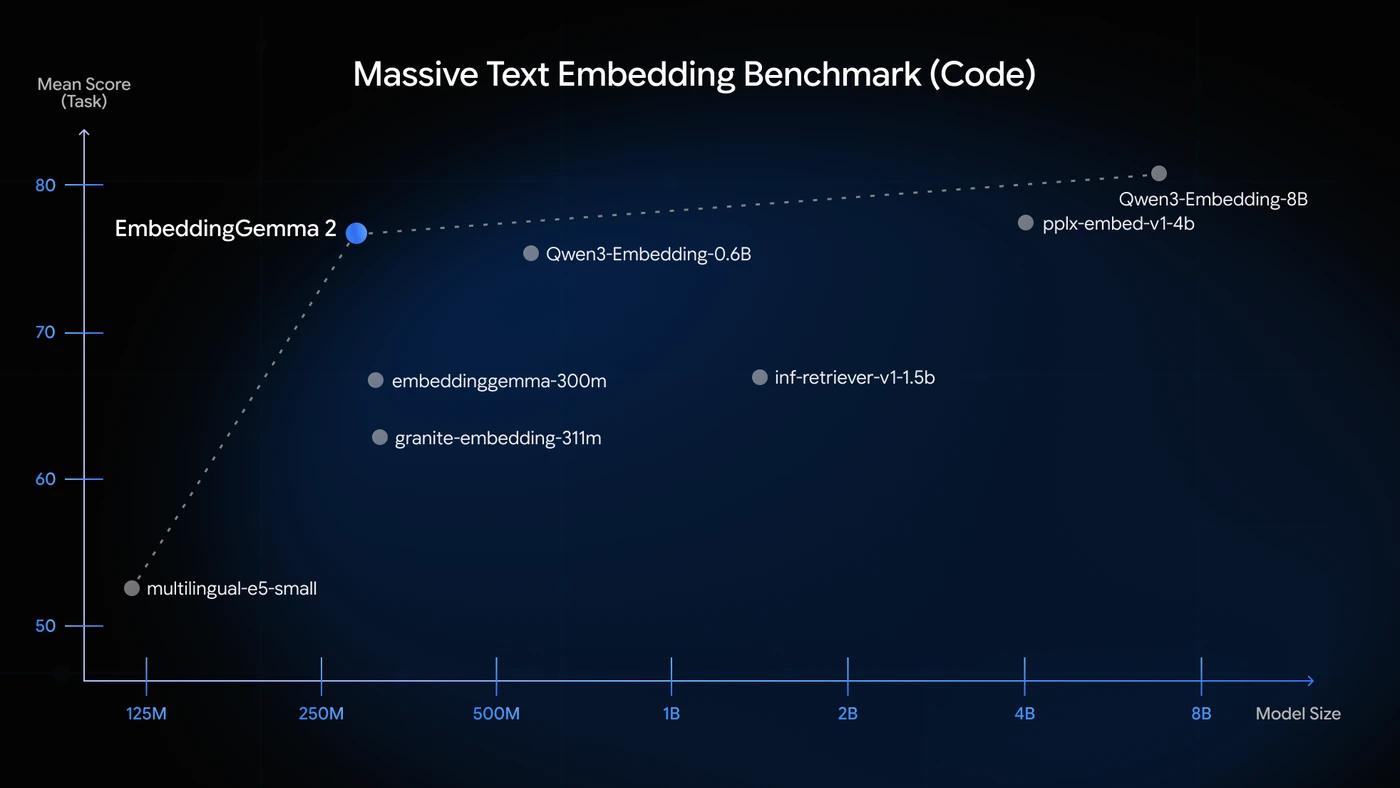
Nuestra lectura es que el título es amplio y tiene una mejor recuperación del código, con un rendimiento de texto multilingüe aproximadamente conservado. Esto es más útil que tratar un porcentaje de un punto de referencia como una mejora prometida para cada consulta de búsqueda empresarial.
La pregunta de seguimiento correcta es: ¿recupera tu fuentes relevantes? Un modelo puede obtener buenos resultados en tareas públicas y aun así tener problemas con sus abreviaturas, diagramas inusuales, archivos en varios idiomas o grabaciones deficientes. Un pequeño conjunto de evaluación de preguntas reales y evidencia esperada es más viable que una etiqueta de ganador universal.
Local no significa gratuito o automáticamente privado
Las ponderaciones abiertas cambian la estructura de costos. No está comprando una tasa de token fija de la inserción alojada de Google API para esta versión. Usted es responsable de la computación, la memoria, el tiempo de indexación, la implementación y el mantenimiento. La versión Apache 2.0 permite una ruta de implementación diferente; no elimina los costos operativos.
Esto puede resultar atractivo cuando el contenido debe permanecer cerca del usuario o funcionar sin una conexión de red. de google Guía de IA Edge demuestra la búsqueda de medios locales y la recuperación de videos en dispositivos de consumo. Sus mediciones de memoria y latencia están vinculadas a dispositivos, configuraciones y cargas de trabajo específicas, lo que no es una garantía para todas las computadoras portátiles o teléfonos.
Para una prueba piloto, mediríamos toda la experiencia: cuánto tiempo lleva crear el primer índice, qué tan rápido regresan las consultas después de la indexación, pico de memoria durante el procesamiento, impacto de la batería y qué sucede cuando los archivos cambian. No es lo mismo una consulta rápida que una importación inicial rápida.
La privacidad también es una propiedad de la aplicación. La inferencia de incrustación local puede mantener el material fuente fuera de un API de incrustación remota. Pero las copias de seguridad en la nube, la telemetría, una base de datos vectorial remota o un modelo de respuesta alojado aún pueden mover datos a otra parte. Mapee la ruta de datos completa antes de llamar a un sistema "completamente local".
De manera similar, los vectores no son un sistema de control de acceso. Conserve los permisos de origen y filtre los resultados para la persona que hace la pregunta. Un archivo privado no debería volverse detectable sólo porque su vector comparte un índice con material público.
Vectores más pequeños: ahorros útiles con una compensación real
El modelo admite acortar sus incrustaciones, una técnica llamada Matryoshka Representation Learning. de google guía para desarrolladores explica los tamaños admitidos y la necesidad de normalizar un vector nuevamente después del truncamiento.
La idea práctica es simple: almacenar menos números por elemento puede hacer que un índice grande sea más pequeño. Reducir un vector de 768 a 128 dimensiones reduce seis veces la carga útil del vector sin procesar cuando el formato del número permanece igual. No hace que toda la aplicación o base de datos sea seis veces más barata; Los archivos originales, los metadatos y la sobrecarga del índice de búsqueda todavía existen.
La configuración más pequeña tampoco es una actualización de calidad gratuita. Los resultados de Google muestran una caída multimodal más sustancial en 128 dimensiones que en 256 o 512. Comenzaríamos un piloto de búsqueda de medios en el tamaño nativo, estableceríamos la línea de base de recuperación y luego probaríamos vectores más pequeños con las mismas preguntas. Las consultas y los elementos indexados deben utilizar dimensiones compatibles.
Esta es una buena optimización para realizar después de demostrar su utilidad. Ahorrar almacenamiento en un índice que devuelve una grabación incorrecta no es una gran ventaja.
EmbeddingGemma 2 frente a Gemini Embedding 2, OpenAI y Cohere
Estos no son modelos de entrega intercambiables. La primera decisión suele ser si desea ejecutar las incorporaciones usted mismo o consumir un servicio administrado. Los puntos de referencia públicos no establecen un ganador justo en cada tiempo de ejecución, corpus y modalidad.
Gemini Embedding 2: recuperación multimodal gestionada
Gemini Embedding 2 es la opción de incrustación multimodal alojada de Google. Su guía actual API admite texto, imágenes, audio, video y archivos PDF, con una salida predeterminada de 3072 dimensiones y salidas más pequeñas configurables. La documentación de incrustación de Gemini de Google es la referencia para el comportamiento de API.
Nuestra opinión: consideremos a Gemini cuando la infraestructura gestionada sea la prioridad; considere EmbeddingGemma cuando la operación local o el control sobre la implementación sean centrales. La compensación no es simplemente “vectores grandes versus vectores pequeños”. Usted elige dónde se realiza el procesamiento y quién lo opera. Consulte la comparación entre EmbeddingGemma 2 y Gemini Embedding 2.
OpenAI text-embedding-3-large: un API centrado en texto
OpenAI text-embedding-3-large es un modelo de incrustación de texto alojado, no un reemplazo de incrustación de imagen, audio o video nativo. OpenAI documenta una salida predeterminada de 3072 dimensiones y una forma de solicitar menos dimensiones. El precio estándar de API que figura actualmente es de 0,13 dólares por millón de tokens de entrada; es decir, el uso de API, no una suscripción a ChatGPT. Guía de integración de OpenAI y Precios de API explicar el alcance.
Para un corpus de texto bien preparado, un servicio de texto administrado puede seguir siendo la opción más sencilla. Para la recuperación de medios nativos o la indexación fuera de línea, está resolviendo un problema diferente. Nuestro Página de comparación OpenAI separa esas capacidades de la fijación de precios.
Cohere Embed 4: otra opción multimodal existente
En la gama Cohere, Insertar 4 maneja texto, imágenes y contenido de documentos mixtos. Esto la convierte en una comparación relevante para la recuperación empresarial, particularmente cuando los documentos fuente contienen información tanto escrita como visual. Documentación de incorporación actual de Cohere enumera su familia de modelos y sus capacidades.
Compararíamos la carga de trabajo de documentos real, los requisitos de implementación y las opciones de adquisición, no asumiríamos que todos los modelos "multimodales" procesan los mismos archivos de la misma manera. Consulte EmbeddingGemma 2 vs Cohere Embed 4 para conocer los datos publicados.
Cómo probarlo sin convertir esto en un proyecto de investigación
Comience con una pregunta que a la gente ya le cuesta responder. Elija una colección delimitada: un repositorio de código, una carpeta de instrucciones visuales o un pequeño conjunto de grabaciones. Evite indexar todo antes de saber cómo es el éxito.
Para una introducción visual, los ejemplos AI Edge Gallery de Google demuestran Instant Media Search y Video Moments Finder. El mismo anuncio de AI Edge,, describe un complemento de reunión local experimental para Mac. También describe la integración de Android ML Kit próximamente; No asuma que una integración futura anunciada ya está disponible.
Para los desarrolladores, la documentación Transformers explica los componentes del modelo y el procesamiento de medios. La recuperación de vídeo utiliza fotogramas muestreados, por lo que se puede perder un breve evento entre muestras. El contexto se comparte entre las entradas de una solicitud; Las grabaciones y colecciones de documentos más largas aún necesitan una segmentación sensata.
Mantenga dos detalles de implementación en la lista de verificación. Primero, siga las indicaciones de la consulta documentada y de la tarea del documento en lugar de tratar cada entrada de manera idéntica. En segundo lugar, utilice la precisión numérica admitida: la guía de puntos de control de Google recomienda bfloat16 o float32 y advierte contra float16. Estos son detalles para la persona que construye el piloto, no decisiones que deba tomar el usuario final. Las instrucciones oficiales del punto de control cubren ambos.
Entonces prueba más que las búsquedas fáciles. Incluya coincidencias cercanas que no deberían devolverse, información faltante, preguntas en varios idiomas y archivos a los que el usuario no puede acceder. Compruebe si aparece la fuente correcta en los primeros resultados e inspeccione la evidencia en lugar de juzgar sólo la respuesta final.
Si está migrando desde otro modelo, nuestra recomendación es crear un índice de candidatos independiente y volver a insertar el corpus de prueba. Las longitudes de vectores coincidentes no establecen compatibilidad entre diferentes modelos. Compare los dos sistemas en la misma colección de origen antes de reemplazar un índice de trabajo.
La conclusión: un conjunto de herramientas de recuperación más amplio, no un reemplazo universal
EmbeddingGemma 2 es más interesante cuando el conocimiento útil se difunde a través de los medios y donde el procesamiento local tiene un propósito claro. Amplía lo que puede buscar una capa de recuperación de peso abierto y al mismo tiempo permite que las aplicaciones carguen solo los codificadores que necesitan.
Nuestra recomendación es tratarlo como un piloto enfocado: demostrar que encuentra la evidencia correcta, verificar la ruta de los datos y medir el costo real del dispositivo. Si resuelve esos problemas, el tamaño del modelo y la configuración del vector se convierten en opciones de ingeniería útiles. Si no es así, un título de referencia sólido no es motivo suficiente para cambiar.
Navega por el biblioteca de modelos de incrustación para alternativas, o utilice el Perfil EmbeddingGemma 2 por sus fuentes, notas de implementación y comparaciones específicas. Esta es una revisión educativa del lanzamiento de Google, no un anuncio de que Cody proporciona una inferencia EmbeddingGemma.
Preguntas frecuentes
¿EmbeddingGemma 2 es un chatbot?
No. Produce vectores de incrustación que el software utiliza para recuperación, similitud, clasificación o agrupación. Se necesita un modelo generativo separado si la aplicación debe escribir una respuesta.
¿EmbeddingGemma 2 es gratuito?
Google publica los pesos bajo Apache 2.0. Eso no significa que la computación, el almacenamiento o el alojamiento sean gratuitos. No existe una tasa de token API alojada única y fija en la documentación de la versión.
¿Qué cambió desde EmbeddingGemma 1?
La versión 2 agrega recuperación nativa de imágenes, audio y video junto con texto y código, amplía el presupuesto de contexto y ofrece codificadores modulares. Las evaluaciones de Google muestran un resultado de código más sólido y un rendimiento de texto multilingüe casi sin cambios.
¿Se puede ejecutar EmbeddingGemma 2 sin conexión?
La inferencia local puede admitir la búsqueda sin conexión una vez que el software, los pesos y el contenido indexado necesarios estén en el dispositivo. La aplicación completa está fuera de línea sólo si sus otros componentes no requieren servicios remotos.
¿Es EmbeddingGemma 2 mejor que Gemini Embedding 2?
Aquí no se establece ningún ganador universal. EmbeddingGemma 2 proporciona pesos abiertos para implementación local o autohospedada, mientras que Gemini Embedding 2 es un API administrado. Compare la calidad de recuperación, el soporte de medios, el costo y los requisitos de implementación de sus propios datos.
¿Reemplaza un analizador de documentos o una base de datos vectorial?
No. Representa contenido para búsqueda. El análisis, la fragmentación, los permisos de origen, la indexación de vectores y la generación de respuestas siguen siendo responsabilidades separadas en un sistema RAG.