- Outils d'IA
- Intelligence artificielle
EmbeddingGemma 2 expliqué : recherche multimodale et RAG
Le EmbeddingGemma 2 de Google intègre du texte, du code, des images, de l'audio et de la vidéo dans la recherche locale. Voici ce qui a changé, sa place dans RAG et ce qu'il faut tester avant de changer.
Imaginez que vous recherchez dans un dossier de projet « le diagramme qui explique notre processus d'intégration ». La réponse peut se trouver dans une diapositive, une capture d'écran ou un moment d'un atelier enregistré, et non dans un document bien intitulé. Un système de recherche textuel doit extraire ou décrire ce matériel avant de pouvoir le trouver.
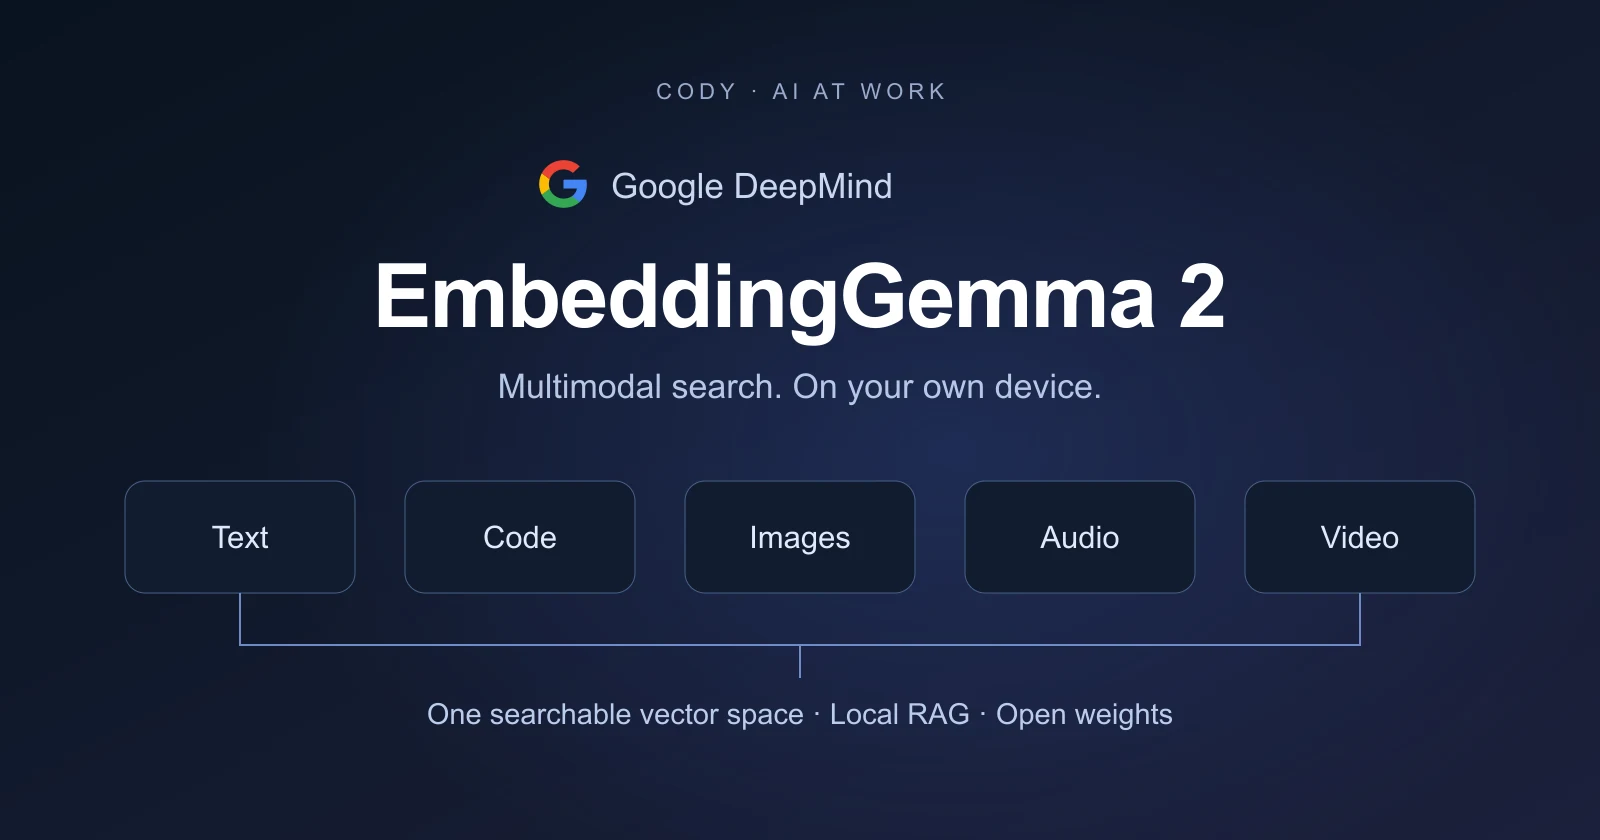
EmbeddingGemma 2 est le nouveau modèle à poids ouvert de Google pour ce problème de récupération. Sorti le 6 octobre 2026, il représente du texte, du code, des images, de l'audio et de la vidéo dans un espace de recherche partagé, en mettant l'accent sur l'exécution sur votre propre matériel. Il s'agit d'un composant de recherche, pas d'un autre chatbot. L'annonce de lancement de Google,, définit l'orientation locale et multimodale.
Notre point de vue : ce qui est intéressant n’est pas que chaque entreprise doive remplacer ses intégrations actuelles. Le fait est que la recherche dans les médias privés et les assistants locaux d’IA disposent désormais d’un autre élément de base pratique. L'amélioration de votre système dépend de ce que vous devez récupérer, de l'endroit où il doit être exécuté et de la quantité d'ingénierie que vous souhaitez posséder.
Pour les spécifications et les liens de comparaison, consultez notre profil de modèle EmbeddingGemma 2. Ici, nous expliquerons ce qui a changé, où cela se situe dans RAG et comment l'évaluer sans se perdre dans la terminologie du modèle.
Qu'est-ce que EmbeddingGemma 2, en anglais simple ?
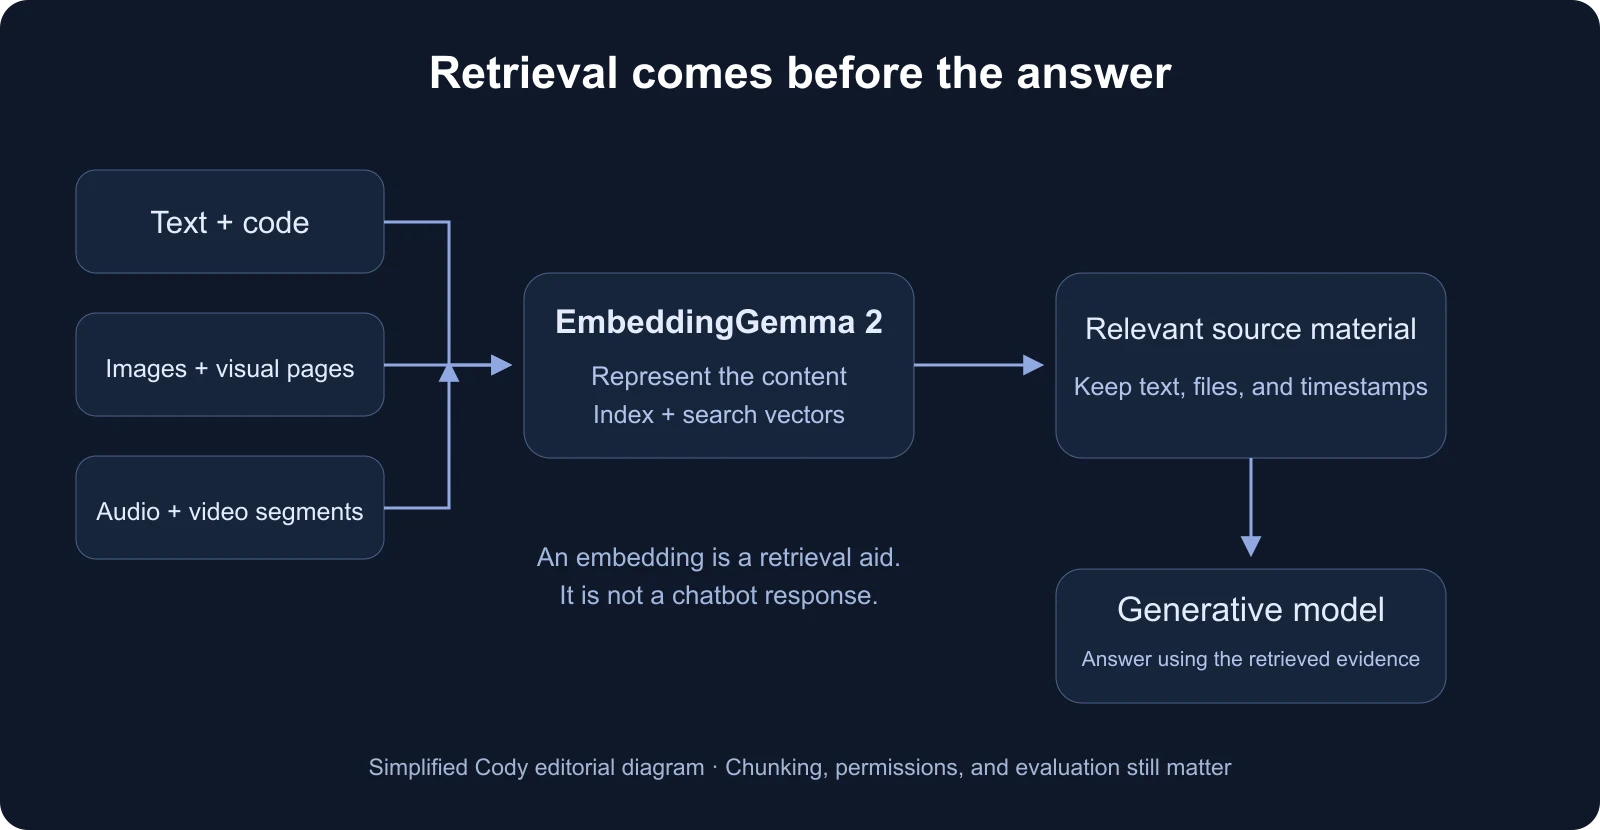
Une intégration est une représentation numérique du contenu. Les logiciels de recherche comparent ces représentations pour trouver des éléments qui sont significativement liés, même lorsque leur formulation diffère. Vous ne lisez pas le vecteur ; vous l'utilisez pour trouver ce que vous voulez réellement lire, regarder ou entendre.
EmbeddingGemma 2 étend cette idée à tous les médias. Une question saisie avec des mots peut conduire à une image ou à un enregistrement, plutôt qu’à un simple autre passage de texte. C'est point de contrôle officiel de Google comprend un composant texte et des encodeurs visuels et audio en option. Vous pouvez charger les éléments dont votre application a besoin plutôt que d'exécuter toujours la configuration multimodale complète.
Considérez-le comme le bibliothécaire, pas comme l'auteur. Il aide à identifier le matériel source utile. Un modèle génératif distinct peut alors transformer ce matériel en réponse, et l'application doit toujours gérer les autorisations d'accès, les citations et les fichiers originaux.
Cette séparation est importante. Une réponse convaincante du chatbot peut cacher un système de recherche faible. L'amélioration de la récupération donne au modèle de réponse de meilleures preuves ; cela ne rend pas automatiquement toutes les réponses correctes.
EmbeddingGemma 2 vs EmbeddingGemma 1 : qu'est-ce qui a changé ?
Le EmbeddingGemma original était déjà un modèle d'intégration de texte compact et multilingue conçu pour une utilisation locale. La version 2 n'est pas le début de l'histoire de la recherche sur les appareils de Google. La principale extension concerne la prise en charge des médias, ainsi qu'un résultat de récupération de code plus puissant. Google aperçu des versions distingue les deux générations.
| Ce qui compte | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| Principales entrées | Texte | Texte, code, images, audio et vidéo |
| Architecture | Basé sur Gemma 3 | Basé sur Gemma 4 |
| Taille publiée | 308 millions de paramètres | 270 M pour le texte/code ; 740M avec tous les encodeurs |
| Budget contextuel | 2 048 jetons | 8 192 jetons partagés via texte et médias |
| Tailles vectorielles | 768, avec des tailles prises en charge plus petites | Dimensions 768, 512, 256 ou 128 |
| Licence de poids | Termes Gemma | Apache 2.0 |
Les spécifications et la licence de la version 2 sont documentées dans le guide de Google. carte modèle. La configuration plus petite, contenant uniquement du texte, mérite d'être notée : l'ajout de fonctionnalités multimédias ne signifie pas que chaque application doit comporter le modèle complet.
Pour une base de connaissances textuelle existante, il s’agit d’une raison à évaluer et non d’un ordre de migration automatique. Si la version 1 trouve déjà les bons passages de manière fiable, de nouveaux encodeurs d'images et d'audio pourraient résoudre un problème que vous n'avez pas. Une équipe recherchant du code, des instructions visuelles ou des enregistrements a une raison plus évidente d'essayer la version 2.
Pourquoi c'est important pour RAG et les connaissances privées
La génération augmentée par récupération, ou RAG, signifie rechercher du matériel source pertinent avant de demander à un modèle d'IA de répondre. La qualité de cette première étape façonne tout ce qui suit.
Un exemple familier est celui d’un assistant de support interne. Des notes de dépannage écrites peuvent expliquer un défaut, mais un technicien peut également avoir besoin de la photo annotée montrant le bon connecteur. Une couche de récupération multimodale pourrait aider à rassembler ces éléments. Il s'agit d'un cas d'utilisation hypothétique et non d'une affirmation selon laquelle ce modèle a réussi une évaluation de support critique pour la sécurité.
Nous considérerions d’abord trois types de pilotes :
- Une médiathèque privée : trouve des captures d'écran utiles, des photos de produits ou des instructions visuelles dans un langage ordinaire.
- Un assistant développeur local : récupère le code pertinent sans envoyer l'intégralité du référentiel à un service d'intégration.
- Une archive d'enregistrement consultable : renvoie un segment pertinent et son horodatage, plutôt que de demander à quelqu'un de parcourir l'intégralité d'un enregistrement.
Dans chaque cas, la récupération doit renvoyer à des preuves. Conservez la référence du fichier, la section du document, la portée d'accès et l'horodatage du média à côté du vecteur. Un résultat similaire n’est pas suffisant si l’utilisateur ne peut pas l’ouvrir ou comprendre pourquoi il a été renvoyé.
Cela ne remplace pas non plus la préparation des documents. Trouver une page visuelle et extraire un tableau de qualité feuille de calcul sont des tâches différentes. Si votre problème est dû à un ordre de lecture incorrect du PDF, à des titres manquants ou à une extraction de tableau peu fiable, commencez par la couche d'ingestion. Notre Guide d'accueil et Explication Cohere Parse couvrir ce côté du pipeline.
Ce que montrent réellement les benchmarks de Google
Les résultats publiés racontent une histoire plus spécifique que « meilleur en tout ». Dans l'évaluation de précision en 768 dimensions de la carte modèle de Google, le score multilingue MTEB passe de 61,15 à 61,36. Le score du code MTEB passe de 68,76 à 78,68, soit une augmentation relative d'environ 14 % par rapport à cette évaluation particulière. Il s'agit des résultats rapportés par Google, et non de nos propres tests. Les tableaux de référence nomment les versions et les métriques d'évaluation.
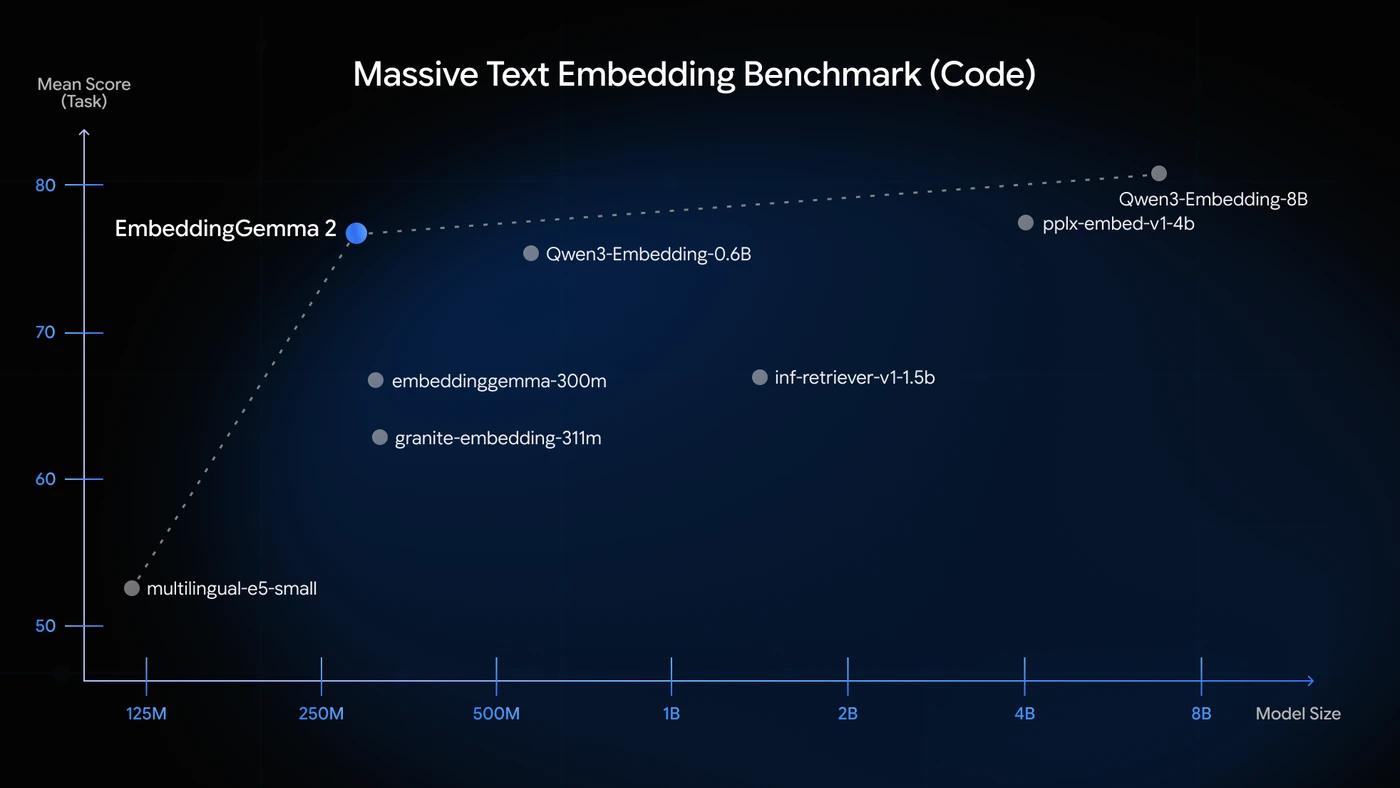
Notre lecture est que le titre est large et offre une meilleure récupération du code, avec des performances de texte multilingues à peu près préservées. C'est plus utile que de traiter un pourcentage d'un point de référence comme une promesse d'amélioration de chaque requête de recherche d'entreprise.
La bonne question de suivi est : récupère-t-il votre sources pertinentes ? Un modèle peut obtenir de bons résultats dans les tâches publiques tout en ayant du mal avec vos abréviations, vos diagrammes inhabituels, vos fichiers en langues mixtes ou vos enregistrements médiocres. Un petit ensemble d’évaluation de questions réelles et de preuves attendues est plus exploitable qu’un label de gagnant universel.
Local ne signifie pas gratuit ou automatiquement privé
Les poids ouverts modifient la structure des coûts. Vous n'achetez pas de taux de jeton fixe auprès de l'intégration hébergée de Google API pour cette version. Vous êtes responsable du calcul, de la mémoire, du temps d'indexation, du déploiement et de la maintenance. La version Apache 2.0 permet un chemin de déploiement différent ; cela ne supprime pas les coûts de fonctionnement.
Cela peut être intéressant lorsque le contenu doit rester à proximité de l'utilisateur ou fonctionner sans connexion réseau. Google Guide IA Edge démontre la recherche de médias locaux et la récupération de vidéos sur les appareils grand public. Ses mesures de mémoire et de latence sont liées à des appareils, configurations et charges de travail spécifiques, ce qui ne constitue pas une garantie pour chaque ordinateur portable ou téléphone.
Pour un pilote, nous mesurerions l'ensemble de l'expérience : le temps nécessaire à la création du premier index, la rapidité avec laquelle les requêtes reviennent après l'indexation, le pic de mémoire pendant le traitement, l'impact sur la batterie et ce qui se passe lorsque les fichiers sont modifiés. Une requête rapide n’est pas la même chose qu’une importation initiale rapide.
La confidentialité est également une propriété de l'application. L'inférence d'intégration locale peut garder le matériel source hors d'une intégration distante API. Mais les sauvegardes cloud, la télémétrie, une base de données vectorielles distante ou un modèle de réponse hébergé peuvent toujours déplacer les données ailleurs. Mappez le chemin complet des données avant d’appeler un système « entièrement local ».
De même, les vecteurs ne sont pas un système de contrôle d’accès. Conservez les autorisations de la source et filtrez les résultats pour la personne qui pose la question. Un fichier privé ne devrait pas devenir détectable simplement parce que son vecteur partage un index avec du matériel public.
Des vecteurs plus petits : des économies utiles avec un réel compromis
Le modèle prend en charge le raccourcissement de ses intégrations, une technique appelée Matryoshka Representation Learning. Google guide du développeur explique les tailles prises en charge et la nécessité de normaliser à nouveau un vecteur après la troncature.
L’idée pratique est simple : stocker moins de nombres par élément peut réduire la taille d’un index important. La réduction d'un vecteur de 768 à 128 dimensions divise par six la charge utile brute du vecteur lorsque le format numérique reste le même. Cela ne rend pas l’ensemble de l’application ou de la base de données six fois moins cher ; les fichiers originaux, les métadonnées et la surcharge d'index de recherche existent toujours.
Le plus petit paramètre ne constitue pas non plus une mise à niveau gratuite de la qualité. Les résultats de Google montrent une baisse multimodale plus importante à 128 dimensions qu'à 256 ou 512. Nous commencerions un projet pilote de recherche multimédia à la taille native, établirions la base de référence de récupération, puis testerions des vecteurs plus petits par rapport aux mêmes questions. Les requêtes et les éléments indexés doivent utiliser des dimensions compatibles.
C'est une bonne optimisation à faire après avoir prouvé son utilité. Économiser de l'espace de stockage sur un index qui renvoie le mauvais enregistrement n'est pas vraiment une victoire.
EmbeddingGemma 2 contre Gemini Embedding 2, OpenAI et Cohere
Ce ne sont pas des modèles de livraison interchangeables. La première décision est souvent de savoir si vous souhaitez exécuter vous-même des intégrations ou utiliser un service géré. Les benchmarks publics ne permettent pas d'établir un gagnant équitable pour chaque environnement d'exécution, corpus et modalité.
Gemini Embedding 2 : récupération multimodale gérée
Gemini Embedding 2 est l'option d'intégration multimodale hébergée de Google. Son guide API actuel prend en charge le texte, les images, l'audio, la vidéo et les PDF, avec une sortie par défaut de 3 072 dimensions et des sorties plus petites configurables. Documentation d'intégration Gemini de Google est la référence pour le comportement de API.
Notre point de vue : pensez à Gemini lorsque l'infrastructure gérée est la priorité ; envisagez EmbeddingGemma lorsque l’opération locale ou le contrôle du déploiement est central. Le compromis n’est pas simplement « les grands vecteurs contre les petits vecteurs ». Vous choisissez où le traitement a lieu et qui l'effectue. Voir la comparaison EmbeddingGemma 2 vs Gemini Embedding 2.
OpenAI text-embedding-3-large : un API axé sur le texte
OpenAI text-embedding-3-large est un modèle d'intégration de texte hébergé, et non un remplacement d'intégration native d'images, d'audio ou de vidéo. OpenAI documente une sortie par défaut de 3 072 dimensions et un moyen de demander moins de dimensions. Le prix standard API actuellement indiqué est de 0,13 $ par million de jetons d'entrée ; il s'agit d'une utilisation API, et non d'un abonnement ChatGPT. Guide d'intégration de OpenAI et Tarification API expliquer la portée.
Pour un corpus de texte bien préparé, un service de texte géré peut rester le choix le plus simple. Pour la récupération de médias natifs ou l'indexation hors ligne, vous résolvez un problème différent. Notre Page de comparaison OpenAI sépare ces capacités de la tarification.
Cohere Embed 4 : une autre option multimodale existante
Dans la gamme Cohere, Intégrer 4 gère le texte, les images et le contenu de documents mixtes. Cela en fait une comparaison pertinente pour la recherche en entreprise, en particulier lorsque les documents sources contiennent à la fois des informations écrites et visuelles. Documentation d'intégration actuelle de Cohere répertorie sa famille de modèles et ses capacités.
Nous comparerions la charge de travail documentaire réelle, les exigences de déploiement et les options d'approvisionnement, sans supposer que tous les modèles « multimodaux » traitent les mêmes fichiers de la même manière. Voir EmbeddingGemma 2 vs Cohere Embed 4 pour les faits publiés.
Comment l'essayer sans en faire un projet de recherche
Commencez par une question à laquelle les gens ont déjà du mal à répondre. Choisissez une collection limitée : un référentiel de code, un dossier d'instructions visuelles ou un petit ensemble d'enregistrements. Évitez de tout indexer avant de savoir à quoi ressemble le succès.
Pour une introduction visuelle, les exemples AI Edge Gallery de Google illustrent Instant Media Search et Video Moments Finder. La même annonce AI Edge,, décrit un compagnon de réunion local expérimental pour Mac. Il décrit également l'intégration Android ML Kit à venir ; ne présumez pas qu’une future intégration annoncée est déjà disponible.
Pour les développeurs, la documentation Transformers explique les composants du modèle et le traitement des médias. La récupération vidéo utilise des images échantillonnées, de sorte qu'un bref événement entre les échantillons peut être manqué. Le contexte est partagé entre les entrées d’une requête ; les enregistrements plus longs et les collections de documents nécessitent toujours une segmentation judicieuse.
Conservez deux détails de mise en œuvre sur la liste de contrôle. Tout d’abord, suivez les invites documentées de requête et de tâche de document plutôt que de traiter chaque entrée de la même manière. Deuxièmement, utilisez la précision numérique prise en charge : les conseils de point de contrôle de Google recommandent bfloat16 ou float32 et mettent en garde contre float16. Ce sont des détails qui concernent la personne qui construit le pilote, et non des décisions qu'un utilisateur final devrait être amené à prendre. Les instructions officielles du point de contrôle couvrent les deux.
Alors testez plus que les recherches faciles. Incluez les quasi-correspondances qui ne doivent pas être renvoyées, les informations manquantes, les questions dans plusieurs langues et les fichiers auxquels l'utilisateur n'est pas autorisé à accéder. Vérifiez si la bonne source apparaît dans les premiers résultats et inspectez les preuves plutôt que de juger uniquement la réponse finale.
Si vous migrez à partir d'un autre modèle, notre recommandation est de créer un index de candidats distinct et de réintégrer le corpus de test. Les longueurs de vecteurs correspondantes n’établissent pas la compatibilité entre les différents modèles. Comparez les deux systèmes sur la même collection source avant de remplacer un index de travail.
Ce qu’il faut retenir : une boîte à outils de récupération plus large, pas un remplacement universel
EmbeddingGemma 2 est particulièrement intéressant lorsque les connaissances utiles sont diffusées sur plusieurs supports et lorsque le traitement local a un objectif clair. Il étend ce qu'une couche de récupération de poids ouverte peut rechercher tout en permettant aux applications de charger uniquement les encodeurs dont elles ont besoin.
Notre recommandation est de le traiter comme un projet pilote ciblé : prouver qu’il trouve les bonnes preuves, vérifier le chemin des données et mesurer le coût réel de l’appareil. Si cela résout ces problèmes, la taille du modèle et les paramètres vectoriels deviennent des choix d'ingénierie utiles. Si ce n’est pas le cas, un titre de référence fort ne constitue pas une raison suffisante pour changer.
Parcourez le intégration d'une bibliothèque de modèles pour des alternatives, ou utilisez le Profil EmbeddingGemma 2 pour ses sources, ses notes de déploiement et ses comparaisons ciblées. Il s'agit d'une revue pédagogique de la version de Google, et non d'une annonce selon laquelle Cody fournit une inférence EmbeddingGemma.
Questions fréquemment posées
EmbeddingGemma 2 est-il un chatbot ?
Non. Il produit des vecteurs d'intégration que le logiciel utilise pour la récupération, la similarité, la classification ou le clustering. Un modèle génératif distinct est nécessaire si l'application doit rédiger une réponse.
EmbeddingGemma 2 est-il gratuit ?
Google publie les pondérations sous Apache 2.0. Cela ne rend pas le calcul, le stockage ou l’hébergement gratuits. Il n’existe pas de taux de jeton API hébergé fixe dans la documentation de la version.
Qu'est-ce qui a changé par rapport à EmbeddingGemma 1 ?
La version 2 ajoute la récupération native d'images, d'audio et de vidéo aux côtés du texte et du code, augmente le budget contextuel et propose des encodeurs modulaires. Les évaluations de Google montrent un résultat de code meilleur et des performances de texte multilingues presque inchangées.
EmbeddingGemma 2 peut-il fonctionner hors ligne ?
L'inférence locale peut prendre en charge la recherche hors ligne une fois que le logiciel, les pondérations et le contenu indexé requis sont sur l'appareil. L'application complète est hors ligne uniquement si ses autres composants ne nécessitent pas de services distants.
EmbeddingGemma 2 est-il meilleur que Gemini Embedding 2 ?
Il n’y a pas de gagnant universel établi ici. EmbeddingGemma 2 fournit des pondérations ouvertes pour un déploiement local ou auto-hébergé, tandis que Gemini Embedding 2 est un API géré. Comparez la qualité de récupération, la prise en charge des médias, le coût et les exigences de déploiement sur vos propres données.
Remplace-t-il un analyseur de documents ou une base de données vectorielles ?
Non. Il représente le contenu pour la recherche. L'analyse, le regroupement, les autorisations source, l'indexation vectorielle et la génération de réponses restent des responsabilités distinctes dans un système RAG.