- KI-Tools
- Künstliche Intelligenz
EmbeddingGemma 2 erklärt: Multimodale Suche und RAG
EmbeddingGemma 2 von Google bringt Text, Code, Bilder, Audio und Video in die lokale Suche ein. Hier erfahren Sie, was sich geändert hat, wo es in RAG passt und was Sie vor dem Wechsel testen sollten.
Stellen Sie sich vor, Sie durchsuchen einen Projektordner nach „dem Diagramm, das unseren Onboarding-Prozess erklärt“. Die Antwort könnte in einer Folie, einem Screenshot oder einem Moment in einem aufgezeichneten Workshop enthalten sein – nicht in einem ordentlich betitelten Dokument. Ein Nur-Text-Suchsystem muss dieses Material extrahieren oder beschreiben, bevor es es finden kann.
EmbeddingGemma 2 ist Googles neues Open-Weight-Modell für dieses Abrufproblem. wurde am 6. Oktober 2026 veröffentlicht und stellt Text, Code, Bilder, Audio und Video in einem gemeinsamen Suchraum dar, wobei der Schwerpunkt auf der Ausführung auf Ihrer eigenen Hardware liegt. Dies ist eine Suchkomponente, kein weiterer Chatbot. Googles Markteinführungsankündigung gibt die lokale, multimodale Richtung vor.
Unsere Meinung: Das Interessante daran ist nicht, dass jedes Unternehmen seine aktuellen Einbettungen ersetzen sollte. Denn mit der privaten Mediensuche und den lokalen KI-Assistenten gibt es nun einen weiteren praktischen Baustein. Ob es Ihr System verbessert, hängt davon ab, was Sie abrufen müssen, wo es ausgeführt werden muss und wie viel Technik Sie besitzen möchten.
Die Spezifikationen und Vergleichslinks finden Sie in unserem Modellprofil EmbeddingGemma 2. Hier erklären wir, was sich geändert hat, wo es in RAG passt und wie man es bewertet, ohne sich in der Modellterminologie zu verlieren.
Was ist EmbeddingGemma 2 im Klartext?
Eine Einbettung ist eine numerische Darstellung von Inhalten. Suchsoftware vergleicht diese Darstellungen, um Elemente zu finden, die einen sinnvollen Zusammenhang haben, auch wenn sich ihr Wortlaut unterscheidet. Sie lesen den Vektor nicht; Sie verwenden es, um das zu finden, was Sie tatsächlich lesen, ansehen oder hören möchten.
EmbeddingGemma 2 erweitert diese Idee auf alle Medien. Eine in Worten eingegebene Frage kann zu einem Bild oder einer Aufnahme führen und nicht nur zu einer weiteren Textpassage. Es ist offizieller Google-Checkpoint Enthält eine Textkomponente und optionale Bild- und Audio-Encoder. Sie können die Teile laden, die Ihre Anwendung benötigt, anstatt immer das vollständige multimodale Setup auszuführen.
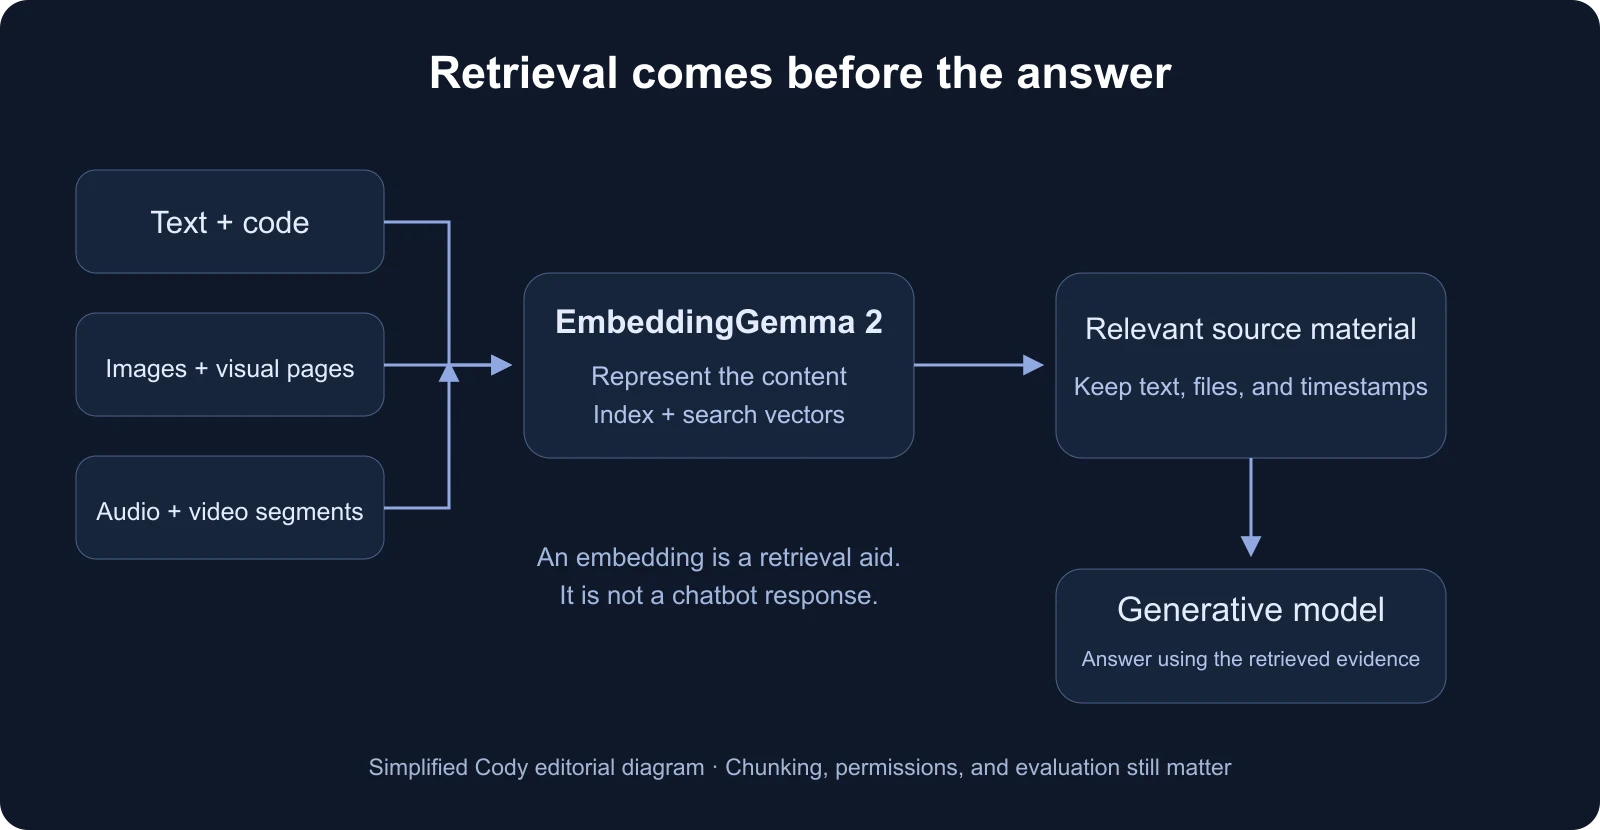
Betrachten Sie es als den Bibliothekar, nicht als den Autor. Es hilft dabei, nützliches Quellenmaterial zu identifizieren. Ein separates generatives Modell kann dieses Material dann in eine Antwort umwandeln, und die Anwendung muss weiterhin Zugriffsberechtigungen, Zitate und die Originaldateien verwalten.
Diese Trennung ist wichtig. Eine überzeugende Chatbot-Antwort kann ein schwaches Suchsystem verbergen. Durch die Verbesserung des Abrufs erhält das Antwortmodell bessere Beweise. Es macht nicht automatisch jede Antwort richtig.
EmbeddingGemma 2 vs. EmbeddingGemma 1: Was hat sich geändert?
Der ursprüngliche EmbeddingGemma war bereits ein kompaktes, mehrsprachiges Texteinbettungsmodell, das für den lokalen Gebrauch konzipiert war. Version 2 ist nicht der Anfang der Geschichte der On-Device-Suche von Google. Die Haupterweiterung ist die Medienunterstützung sowie ein stärkeres Code-Abrufergebnis. Googles -Versionsübersicht unterscheidet die beiden Generationen.
| Was zählt | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| Haupteingänge | Text | Text, Code, Bilder, Audio und Video |
| Architektur | Gemma 3-basiert | Gemma 4-basiert |
| Veröffentlichte Größe | 308M Parameter | 270 MB für Text/Code; 740M mit allen Encodern |
| Kontextbudget | 2.048 Token | 8.192 Token, die über Text und Medien geteilt werden |
| Vektorgrößen | 768, mit kleineren unterstützten Größen | 768, 512, 256 oder 128 Abmessungen |
| Lizenz für Gewichte | Gemma-Begriffe | Apache 2.0 |
Die Spezifikationen und die Lizenz der Version 2 sind in der -Modellkarte von Google dokumentiert. Bemerkenswert ist die kleinere Nur-Text-Konfiguration: Das Hinzufügen von Medienfunktionen bedeutet nicht, dass jede Anwendung das vollständige Modell enthalten muss.
Für eine bestehende Textwissensdatenbank ist dies ein Grund zur Bewertung – kein automatischer Migrationsauftrag. Wenn Version 1 bereits zuverlässig die richtigen Passagen findet, lösen neue Bild- und Audio-Encoder möglicherweise ein Problem, das Sie nicht haben. Ein Team, das nach Code, visuellen Anweisungen oder Aufzeichnungen sucht, hat einen offensichtlicheren Grund, Version 2 auszuprobieren.
Warum es für RAG und privates Wissen wichtig ist
Retrieval-Augmented Generation oder RAG bedeutet, relevantes Quellmaterial zu finden, bevor ein KI-Modell um eine Antwort gebeten wird. Die Qualität dieses ersten Schritts prägt alles, was folgt.
Ein bekanntes Beispiel ist ein interner Support-Assistent. Schriftliche Hinweise zur Fehlerbehebung können einen Fehler erklären, aber ein Techniker benötigt möglicherweise auch das kommentierte Foto, das den richtigen Stecker zeigt. Eine multimodale Retrieval-Ebene könnte dabei helfen, diese Teile zusammenzuführen. Dabei handelt es sich um einen hypothetischen Anwendungsfall und nicht um die Behauptung, dass dieses Modell eine sicherheitskritische Supportbewertung bestanden hat.
Wir würden zunächst drei Arten von Piloten betrachten:
- Eine private Medienbibliothek: mit nützlichen Screenshots, Produktfotos oder visuellen Anweisungen in normaler Sprache.
- Ein lokaler Entwicklerassistent:, der relevanten Code abruft, ohne das gesamte Repository an einen Einbettungsdienst zu senden.
- Ein durchsuchbares Aufzeichnungsarchiv: gibt ein relevantes Segment und seinen Zeitstempel zurück, anstatt jemanden dazu zu bringen, eine ganze Aufzeichnung zu überfliegen.
In jedem Fall sollte die Rückholung auf Beweise hinweisen. Behalten Sie den Dateiverweis, den Dokumentabschnitt, den Zugriffsbereich und den Medienzeitstempel neben dem Vektor bei. Ein ähnlich aussehendes Ergebnis reicht nicht aus, wenn der Benutzer es nicht öffnen oder nicht verstehen kann, warum es zurückgegeben wurde.
Es ersetzt auch nicht die Dokumentenerstellung. Das Finden einer visuellen Seite und das Extrahieren einer Tabelle in Tabellenkalkulationsqualität sind unterschiedliche Aufgaben. Wenn Ihr Problem in einer fehlerhaften PDF-Lesereihenfolge, fehlenden Überschriften oder einer unzuverlässigen Tabellenextraktion besteht, beginnen Sie mit der Aufnahmeebene. Unsere -Docling-Anleitungen und Cohere Parse-Erklärer decken diese Seite der Pipeline ab.
Was die Benchmarks von Google tatsächlich zeigen
Die veröffentlichten Ergebnisse erzählen eine spezifischere Geschichte als „in allem besser“. Bei der vollpräzisen, 768-dimensionalen Auswertung in der Modellkarte von Google bewegt sich der mehrsprachige MTEB-Score von 61,15 auf 61,36. Der Code-MTEB-Wert steigt von 68,76 auf 78,68 – etwa 14 % relativer Anstieg gegenüber dieser bestimmten Bewertung. Dabei handelt es sich um Google-gemeldete Ergebnisse, nicht um unsere eigenen Tests. Die Benchmark-Tabellen benennen die Evaluierungsversionen und Metriken.
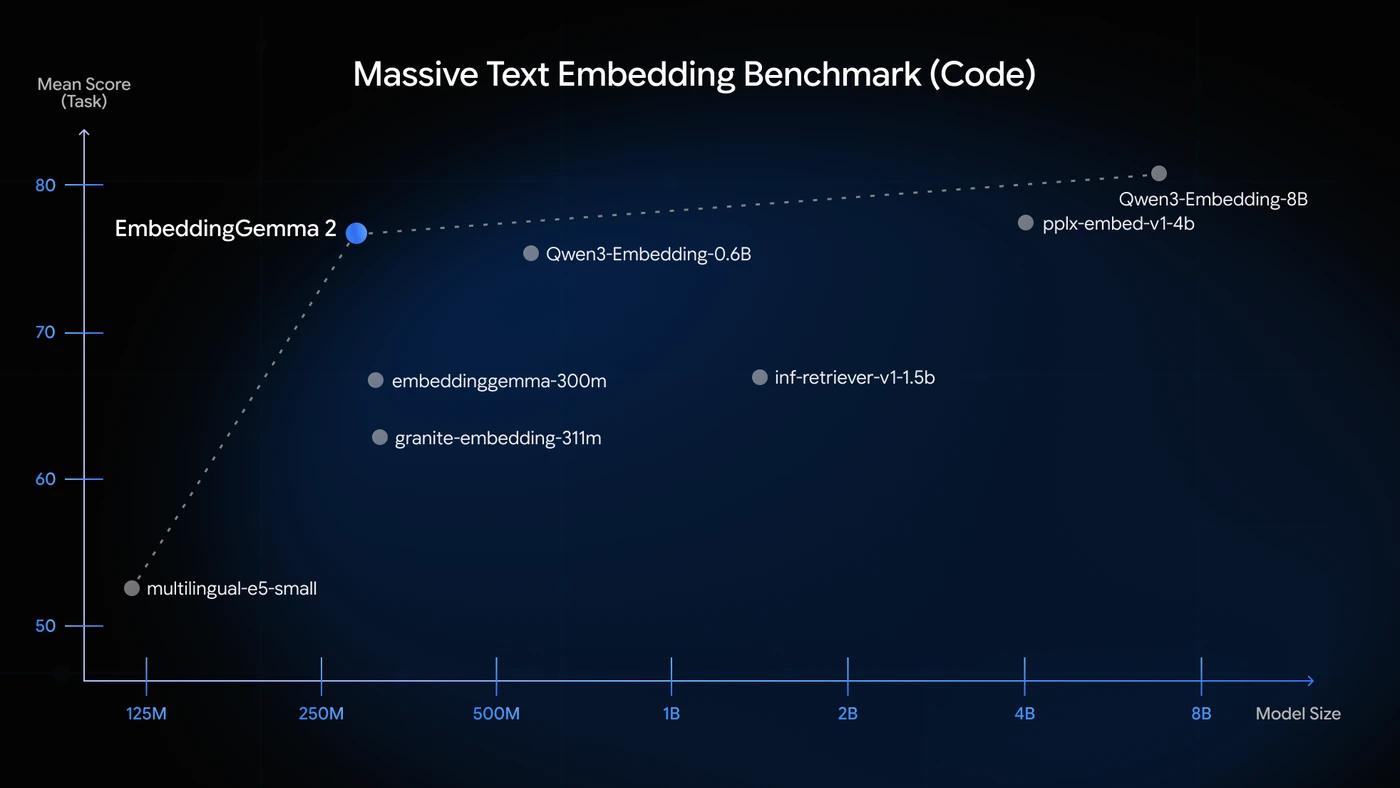
Unsere Lesart ist, dass die Überschrift breiter ist und sich besser Code abrufen lässt, wobei die Leistung mehrsprachiger Texte im Großen und Ganzen erhalten bleibt. Das ist nützlicher, als einen Prozentsatz eines Benchmarks als versprochene Verbesserung für jede geschäftliche Suchanfrage zu betrachten.
Die richtige Folgefrage lautet: Wird es abgerufen? dein relevante Quellen? Ein Model kann bei öffentlichen Aufgaben gut abschneiden und trotzdem Probleme mit Ihren Abkürzungen, ungewöhnlichen Diagrammen, gemischtsprachigen Dateien oder schlechten Aufnahmen haben. Ein kleiner Bewertungssatz aus realen Fragen und erwarteten Beweisen ist umsetzbarer als ein universelles Siegerlabel.
Lokal bedeutet nicht kostenlos – oder automatisch privat
Offene Gewichte verändern die Kostenstruktur. Sie kaufen für diese Version keinen festen Token-Tarif von Googles gehosteter Einbettung API. Sie sind für Rechenleistung, Speicher, Indizierungszeit, Bereitstellung und Wartung verantwortlich. Die Version Apache 2.0 ermöglicht einen anderen Bereitstellungspfad; Dadurch werden die Betriebskosten nicht gesenkt.
Das kann attraktiv sein, wenn Inhalte in der Nähe des Benutzers bleiben müssen oder ohne Netzwerkverbindung funktionieren müssen. Der AI Edge-Leitfaden von Google demonstriert die lokale Mediensuche und den Videoabruf auf Verbrauchergeräten. Seine Speicher- und Latenzmessungen sind an bestimmte Geräte, Konfigurationen und Arbeitslasten gebunden – keine Garantie für jeden Laptop oder jedes Telefon.
Für ein Pilotprojekt würden wir die gesamte Erfahrung messen: wie lange es dauert, den ersten Index zu erstellen, wie schnell Abfragen nach der Indizierung zurückkehren, Spitzenspeicher während der Verarbeitung, Auswirkungen auf die Batterie und was passiert, wenn sich Dateien ändern. Eine schnelle Abfrage ist nicht dasselbe wie ein schneller Erstimport.
Datenschutz ist ebenfalls eine Anwendungseigenschaft. Lokale Einbettungsinferenz kann das Quellmaterial von einer Remote-Einbettung fernhalten. Aber Cloud-Backups, Telemetrie, eine Remote-Vektordatenbank oder ein gehostetes Antwortmodell können Daten trotzdem an einen anderen Ort verschieben. Ordnen Sie den vollständigen Datenpfad zu, bevor Sie ein System als „vollständig lokal“ bezeichnen.
Ebenso sind Vektoren kein Zugangskontrollsystem. Behalten Sie die Quellberechtigungen bei und filtern Sie die Ergebnisse für die Person, die die Frage stellt. Eine private Datei sollte nicht auffindbar werden, nur weil ihr Vektor einen Index mit öffentlichem Material teilt.
Kleinere Vektoren: nützliche Einsparungen mit einem echten Kompromiss
Das Modell unterstützt die Verkürzung seiner Einbettungen, eine Technik namens Matryoshka Representation Learning. Googles -Entwicklerhandbuch erläutert die unterstützten Größen und die Notwendigkeit, einen Vektor nach der Kürzung erneut zu normalisieren.
Die praktische Idee ist einfach: Durch das Speichern weniger Zahlen pro Element kann ein großer Index kleiner werden. Durch die Reduzierung eines Vektors von 768 auf 128 Dimensionen wird die Nutzlast des Rohvektors um das Sechsfache reduziert, wenn das Zahlenformat gleich bleibt. Dadurch wird die gesamte Anwendung oder Datenbank nicht sechsmal billiger; Originaldateien, Metadaten und Suchindex-Overhead sind weiterhin vorhanden.
Auch die kleinste Einstellung ist kein kostenloses Qualitätsupgrade. Die Ergebnisse von Google zeigen einen stärkeren multimodalen Rückgang bei 128 Dimensionen als bei 256 oder 512. Wir würden ein Pilotprojekt zur Mediensuche in der nativen Größe starten, die Abrufbasislinie festlegen und dann kleinere Vektoren anhand derselben Fragen testen. Abfragen und indizierte Elemente müssen kompatible Dimensionen verwenden.
Dies ist eine gute Optimierung, die nach dem Nachweis der Nützlichkeit durchgeführt werden kann. Das Einsparen von Speicherplatz in einem Index, der die falsche Aufzeichnung zurückgibt, ist kein großer Gewinn.
EmbeddingGemma 2 vs. Gemini Embedding 2, OpenAI und Cohere
Es handelt sich hierbei nicht um austauschbare Liefermodelle. Die erste Entscheidung ist oft, ob Sie Einbettungen selbst durchführen oder einen Managed Service nutzen möchten. Öffentliche Benchmarks ermitteln nicht für jede Laufzeit, jeden Korpus und jede Modalität einen fairen Gewinner.
Gemini Embedding 2: verwalteter multimodaler Abruf
Gemini Embedding 2 ist die gehostete multimodale Einbettungsoption von Google. Sein aktueller API-Leitfaden unterstützt Text, Bilder, Audio, Video und PDFs mit einer Standardausgabe von 3.072 Dimensionen und konfigurierbaren kleineren Ausgaben. Die Gemini-Einbettungsdokumentation von Google ist die Referenz für das Verhalten von API.
Unsere Meinung: Ziehen Sie Gemini in Betracht, wenn verwaltete Infrastruktur Priorität hat; Ziehen Sie EmbeddingGemma in Betracht, wenn der lokale Betrieb oder die Kontrolle über die Bereitstellung von zentraler Bedeutung ist. Der Kompromiss besteht nicht einfach darin, „große Vektoren gegen kleine Vektoren“ zu wählen. Sie entscheiden, wo die Verarbeitung erfolgt und wer sie betreibt. Sehen Sie sich den Vergleich EmbeddingGemma 2 vs. Gemini Embedding 2 an.
OpenAI text-embedding-3-large: ein textfokussierter API
OpenAI text-embedding-3-large ist ein gehostetes Texteinbettungsmodell und kein Ersatz für die native Bild-, Audio- oder Videoeinbettung. OpenAI dokumentiert eine standardmäßige 3.072-dimensionale Ausgabe und eine Möglichkeit, weniger Dimensionen anzufordern. Der derzeit aufgeführte Standardpreis für API beträgt 0,13 US-Dollar pro Million Input-Token; Das ist eine API-Nutzung, kein ChatGPT-Abonnement. OpenAIs Einbettungsanleitung und API-Preise den Umfang erläutern.
Für ein gut vorbereitetes Textkorpus bleibt ein verwalteter Textdienst möglicherweise die einfachere Wahl. Beim nativen Medienabruf oder der Offline-Indizierung lösen Sie ein anderes Problem. Unser OpenAI-Vergleichsseite trennt diese Funktionen von der Preisgestaltung.
Cohere Embed 4: eine weitere bestehende multimodale Option
In der Produktpalette von Cohere Einbetten 4 verarbeitet Text, Bilder und gemischte Dokumentinhalte. Dies macht es zu einem relevanten Vergleich für die Unternehmensrecherche, insbesondere wenn Quelldokumente sowohl schriftliche als auch visuelle Informationen enthalten. Die aktuelle Einbettungsdokumentation von Cohere listet seine Modellfamilie und Funktionen auf.
Wir vergleichen die tatsächliche Dokumentenauslastung, die Bereitstellungsanforderungen und die Beschaffungsoptionen und gehen nicht davon aus, dass alle „multimodalen“ Modelle dieselben Dateien auf die gleiche Weise verarbeiten. Die veröffentlichten Fakten finden Sie unter EmbeddingGemma 2 vs. Cohere Embed 4.
Wie man es ausprobiert, ohne daraus ein Forschungsprojekt zu machen
Beginnen Sie mit einer Frage, die die Leute ohnehin nur schwer beantworten können. Wählen Sie eine begrenzte Sammlung – ein Code-Repository, einen Ordner mit visuellen Anweisungen oder einen kleinen Satz Aufzeichnungen. Vermeiden Sie es, alles zu indizieren, bevor Sie wissen, wie Erfolg aussieht.
Für eine visuelle Einführung zeigen die AI Edge Gallery-Beispiele von Google Instant Media Search und Video Moments Finder. Die gleiche AI Edge-Ankündigung beschreibt einen experimentellen lokalen Meeting-Begleiter für Mac. Außerdem wird die ML Kit-Android-Integration als bevorstehend beschrieben. Gehen Sie nicht davon aus, dass eine angekündigte zukünftige Integration bereits verfügbar ist.
Für Entwickler erläutert die Dokumentation Transformers die Modellkomponenten und die Medienverarbeitung. Bei der Videoabfrage werden abgetastete Frames verwendet, sodass ein kurzes Ereignis zwischen den Samples übersehen werden kann. Der Kontext wird von allen Eingaben in einer Anfrage gemeinsam genutzt. Längere Aufzeichnungen und Dokumentensammlungen bedürfen weiterhin einer sinnvollen Segmentierung.
Behalten Sie zwei Implementierungsdetails auf der Checkliste. Befolgen Sie zunächst die dokumentierten Eingabeaufforderungen für Abfragen und Dokumentaufgaben, anstatt jede Eingabe gleich zu behandeln. Zweitens verwenden Sie die unterstützte numerische Genauigkeit: Die Checkpoint-Anleitungen von Google empfehlen bfloat16 oder float32 und warnen vor float16. Hierbei handelt es sich um Details für die Person, die das Pilotprojekt erstellt, und nicht um Entscheidungen, die ein Endbenutzer treffen sollte. Die offiziellen Checkpoint-Anweisungen decken beides ab.
Dann testen Sie mehr als nur die einfachen Suchen. Schließen Sie Beinahe-Übereinstimmungen ein, die nicht zurückgegeben werden sollten, fehlende Informationen, Fragen in gemischten Sprachen und Dateien, auf die der Benutzer nicht zugreifen darf. Überprüfen Sie, ob in den ersten Ergebnissen die richtige Quelle erscheint, und überprüfen Sie die Beweise, anstatt nur die endgültige Antwort zu beurteilen.
Wenn Sie von einem anderen Modell migrieren, empfehlen wir, einen separaten Kandidatenindex zu erstellen und den Testkorpus erneut einzubetten. Übereinstimmende Vektorlängen stellen keine Kompatibilität zwischen verschiedenen Modellen her. Vergleichen Sie die beiden Systeme in derselben Quellsammlung, bevor Sie einen Arbeitsindex ersetzen.
Das Fazit: ein breiteres Retrieval-Toolkit, kein universeller Ersatz
EmbeddingGemma 2 ist dort am interessantesten, wo nützliches Wissen über alle Medien verteilt ist und die lokale Verarbeitung einen klaren Zweck hat. Es erweitert die Suchmöglichkeiten einer Open-Weight-Retrieval-Schicht und ermöglicht gleichzeitig, dass Anwendungen nur die Encoder laden, die sie benötigen.
Wir empfehlen, es als gezieltes Pilotprojekt zu behandeln: Beweisen Sie, dass es die richtigen Beweise findet, überprüfen Sie den Datenpfad und messen Sie die tatsächlichen Gerätekosten. Wenn diese Probleme gelöst werden, werden die Modellgröße und die Vektoreinstellungen zu nützlichen technischen Entscheidungen. Wenn dies nicht der Fall ist, ist eine starke Benchmark-Überschrift kein ausreichender Grund für einen Wechsel.
Durchsuchen Sie die -Einbettungsmodellbibliothek nach Alternativen oder verwenden Sie das EmbeddingGemma 2-Profil für seine Quellen, Bereitstellungshinweise und gezielten Vergleiche. Dies ist eine pädagogische Rezension der Veröffentlichung von Google und keine Ankündigung, dass Cody EmbeddingGemma-Schlussfolgerungen liefert.
Häufig gestellte Fragen
Ist EmbeddingGemma 2 ein Chatbot?
Nein. Es werden Einbettungsvektoren erzeugt, die von der Software zum Abrufen, zur Ähnlichkeit, zur Klassifizierung oder zum Clustering verwendet werden. Soll die Anwendung eine Antwort schreiben, ist ein separates generatives Modell erforderlich.
Ist EmbeddingGemma 2 kostenlos?
Google veröffentlicht die Gewichte unter Apache 2.0. Dadurch sind Rechenleistung, Speicher oder Hosting nicht kostenlos. In der Release-Dokumentation gibt es keine einzelne feste gehostete API-Token-Rate.
Was hat sich gegenüber EmbeddingGemma 1 geändert?
Version 2 fügt neben Text und Code auch native Bild-, Audio- und Videoabrufe hinzu, erweitert das Kontextbudget und bietet modulare Encoder. Die Auswertungen von Google zeigen ein stärkeres Codeergebnis und eine nahezu unveränderte mehrsprachige Textleistung.
Kann EmbeddingGemma 2 offline ausgeführt werden?
Lokale Inferenz kann die Offline-Suche unterstützen, sobald die erforderliche Software, Gewichtungen und indizierten Inhalte auf dem Gerät vorhanden sind. Die gesamte Anwendung ist nur dann offline, wenn ihre anderen Komponenten keine Remote-Dienste erfordern.
Ist EmbeddingGemma 2 besser als Gemini Embedding 2?
Es gibt hier keinen allgemeingültigen Gewinner. EmbeddingGemma 2 bietet offene Gewichtungen für die lokale oder selbstgehostete Bereitstellung, während Gemini Embedding 2 ein verwaltetes API ist. Vergleichen Sie Abrufqualität, Medienunterstützung, Kosten und Bereitstellungsanforderungen anhand Ihrer eigenen Daten.
Ersetzt es einen Dokumentenparser oder eine Vektordatenbank?
Nein. Es stellt Inhalte für die Suche dar. Parsing, Chunking, Quellberechtigungen, Vektorindizierung und Antwortgenerierung bleiben in einem RAG-System separate Verantwortlichkeiten.