- Ferramentas de IA
- Inteligência artificial
EmbeddingGemma 2 explicado: pesquisa multimodal e RAG
O EmbeddingGemma 2 do Google traz texto, código, imagens, áudio e vídeo para a pesquisa local. Aqui está o que mudou, onde se encaixa no RAG e o que testar antes de mudar.
Imagine pesquisar em uma pasta de projeto “o diagrama que explica nosso processo de integração”. A resposta pode estar em um slide, uma captura de tela ou um momento de um workshop gravado – e não em um documento bem intitulado. Um sistema de busca somente texto precisa extrair ou descrever esse material antes de poder encontrá-lo.
EmbeddingGemma 2 é o novo modelo aberto do Google para esse problema de recuperação. Lançado em 6 de outubro de 2026, representa texto, código, imagens, áudio e vídeo em um espaço de busca compartilhado, com ênfase na execução em seu próprio hardware. Este é um componente de pesquisa, não outro chatbot. O anúncio de lançamento do Google,, define a direção local e multimodal.
Nossa opinião: o interessante não é que todas as empresas devam substituir suas incorporações atuais. É que a pesquisa de mídia privada e os assistentes locais de IA agora têm outro elemento prático. A melhoria do seu sistema depende do que você precisa recuperar, onde ele deve ser executado e quanta engenharia você deseja possuir.
Para obter as especificações e links de comparação, consulte nosso perfil do modelo EmbeddingGemma 2. Aqui explicaremos o que mudou, onde se encaixa no RAG e como avaliá-lo sem se perder na terminologia do modelo.
O que é EmbeddingGemma 2, em inglês simples?
Uma incorporação é uma representação numérica do conteúdo. O software de pesquisa compara essas representações para encontrar itens que estejam significativamente relacionados, mesmo quando suas palavras são diferentes. Você não lê o vetor; você o usa para encontrar o que realmente deseja ler, assistir ou ouvir.
EmbeddingGemma 2 estende essa ideia a todas as mídias. Uma pergunta digitada em palavras pode levar a uma imagem ou gravação, e não apenas a outra passagem de texto. É ponto de verificação oficial do Google inclui um componente de texto e codificadores opcionais de visão e áudio. Você pode carregar as peças que seu aplicativo precisa em vez de sempre executar a configuração multimodal completa.
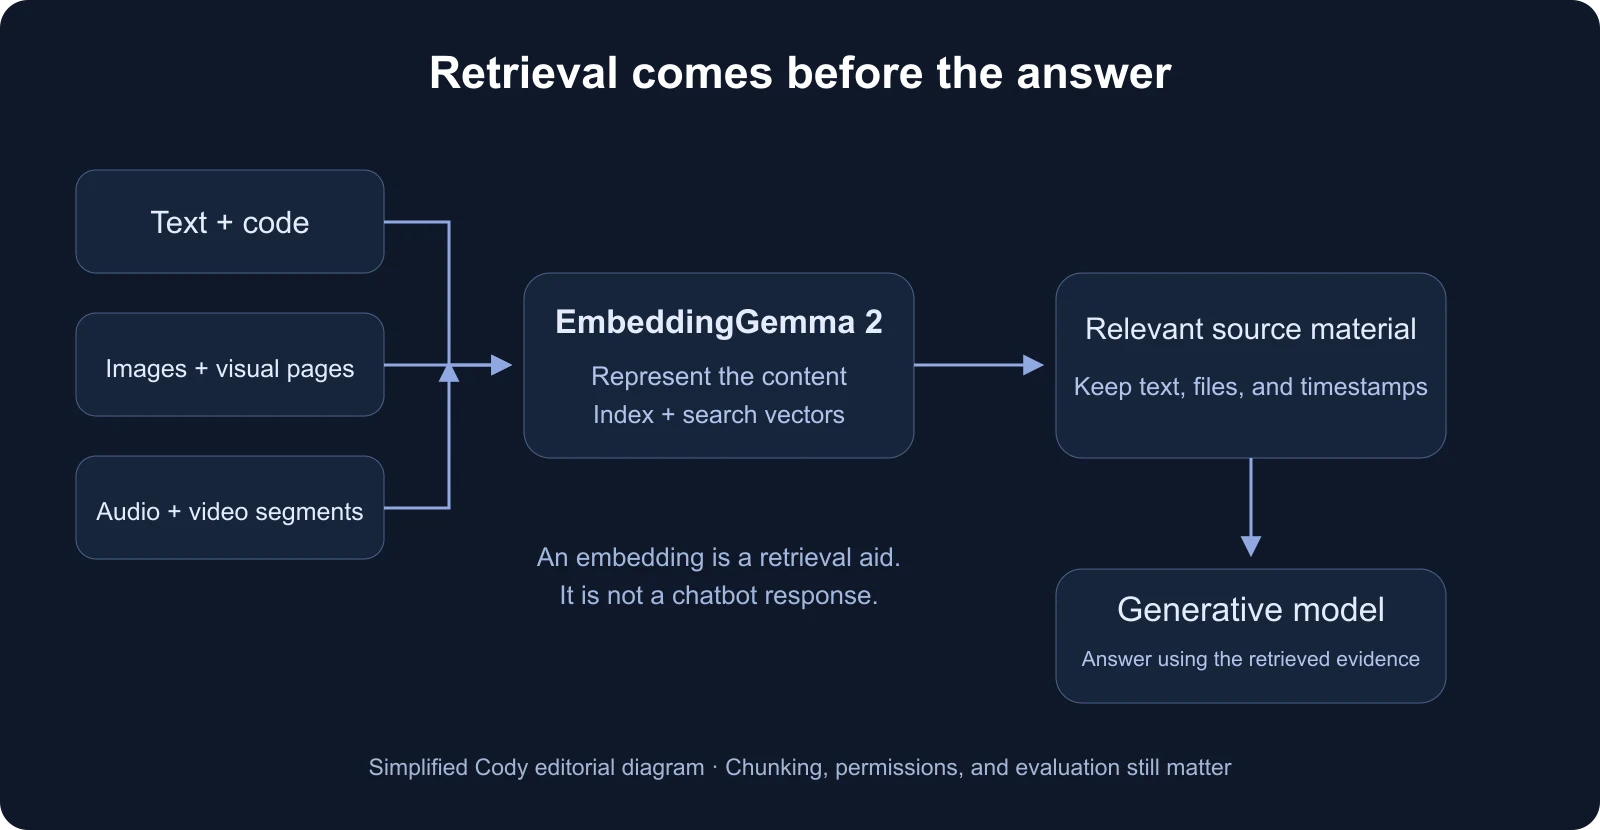
Pense nisso como o bibliotecário, não como o autor. Ajuda a identificar material de origem útil. Um modelo generativo separado pode então transformar esse material em uma resposta, e o aplicativo ainda precisa lidar com permissões de acesso, citações e arquivos originais.
Essa separação é importante. Uma resposta convincente do chatbot pode esconder um sistema de pesquisa fraco. Melhorar a recuperação dá ao modelo de resposta melhores evidências; isso não torna todas as respostas corretas automaticamente.
EmbeddingGemma 2 vs EmbeddingGemma 1: o que mudou?
O EmbeddingGemma original já era um modelo compacto e multilíngue de incorporação de texto projetado para uso local. A versão 2 não é o começo da história de pesquisa no dispositivo do Google. A principal expansão é o suporte de mídia, juntamente com um resultado de recuperação de código mais forte. do Google visão geral da versão distingue as duas gerações.
| O que importa | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| Principais insumos | Texto | Texto, código, imagens, áudio e vídeo |
| Arquitetura | Baseado em Gemma 3 | Baseado em Gemma 4 |
| Tamanho publicado | Parâmetros 308M | 270M para texto/código; 740M com todos os codificadores |
| Orçamento de contexto | 2.048 fichas | 8.192 tokens compartilhados entre texto e mídia |
| Tamanhos vetoriais | 768, com tamanhos menores suportados | Dimensões 768, 512, 256 ou 128 |
| Licença de pesos | Termos de gema | Apache 2.0 |
As especificações e a licença da versão 2 estão documentadas no Google cartão modelo. Vale a pena notar a configuração menor somente de texto: adicionar capacidade de mídia não significa que todo aplicativo deva carregar o modelo completo.
Para uma base de conhecimento de texto existente, este é um motivo para avaliar – não uma ordem de migração automática. Se a versão 1 já encontra as passagens corretas de forma confiável, novos codificadores de imagem e áudio podem resolver um problema que você não tem. Uma equipe que busca código, instruções visuais ou gravações tem um motivo mais óbvio para tentar a versão 2.
Por que é importante para RAG e conhecimento privado
A geração de recuperação aumentada, ou RAG, significa encontrar material de origem relevante antes de pedir uma resposta a um modelo de IA. A qualidade desse primeiro passo molda tudo o que se segue.
Um exemplo familiar é um assistente de suporte interno. Notas escritas de solução de problemas podem explicar uma falha, mas um técnico também pode precisar da foto anotada que mostra o conector correto. Uma camada de recuperação multimodal poderia ajudar a juntar essas peças. Este é um caso de uso hipotético, não uma afirmação de que este modelo passou por uma avaliação de suporte crítico de segurança.
Consideraríamos primeiro três tipos de piloto:
- Uma biblioteca de mídia privada: que encontra capturas de tela úteis, fotos de produtos ou instruções visuais em linguagem comum.
- Um assistente de desenvolvedor local: recuperando código relevante sem enviar o repositório inteiro para um serviço de incorporação.
- Um arquivo de gravação pesquisável: retornando um segmento relevante e seu carimbo de data/hora, em vez de fazer alguém folhear uma gravação inteira.
Em cada caso, a recuperação deve apontar para evidências. Mantenha a referência do arquivo, a seção do documento, o escopo de acesso e o carimbo de data/hora da mídia ao lado do vetor. Um resultado semelhante não é suficiente se o usuário não conseguir abri-lo ou entender por que ele foi retornado.
Também não substitui a preparação de documentos. Encontrar uma página visual e extrair uma tabela com qualidade de planilha são tarefas diferentes. Se o seu problema for uma ordem de leitura de PDF quebrada, títulos ausentes ou extração de tabela não confiável, comece com a camada de ingestão. Nosso Guia de documentação e Explicador Cohere Parse cubra esse lado do pipeline.
O que os benchmarks do Google realmente mostram
Os resultados publicados contam uma história mais específica do que “melhor em tudo”. Na avaliação de 768 dimensões de precisão total no cartão modelo do Google, a pontuação multilíngue MTEB passa de 61,15 para 61,36. A pontuação do código MTEB passa de 68,76 para 78,68 – um aumento relativo de cerca de 14% nessa avaliação específica. Estes são resultados relatados pelo Google, não nossos próprios testes. As tabelas de benchmark nomeiam as versões e métricas de avaliação.
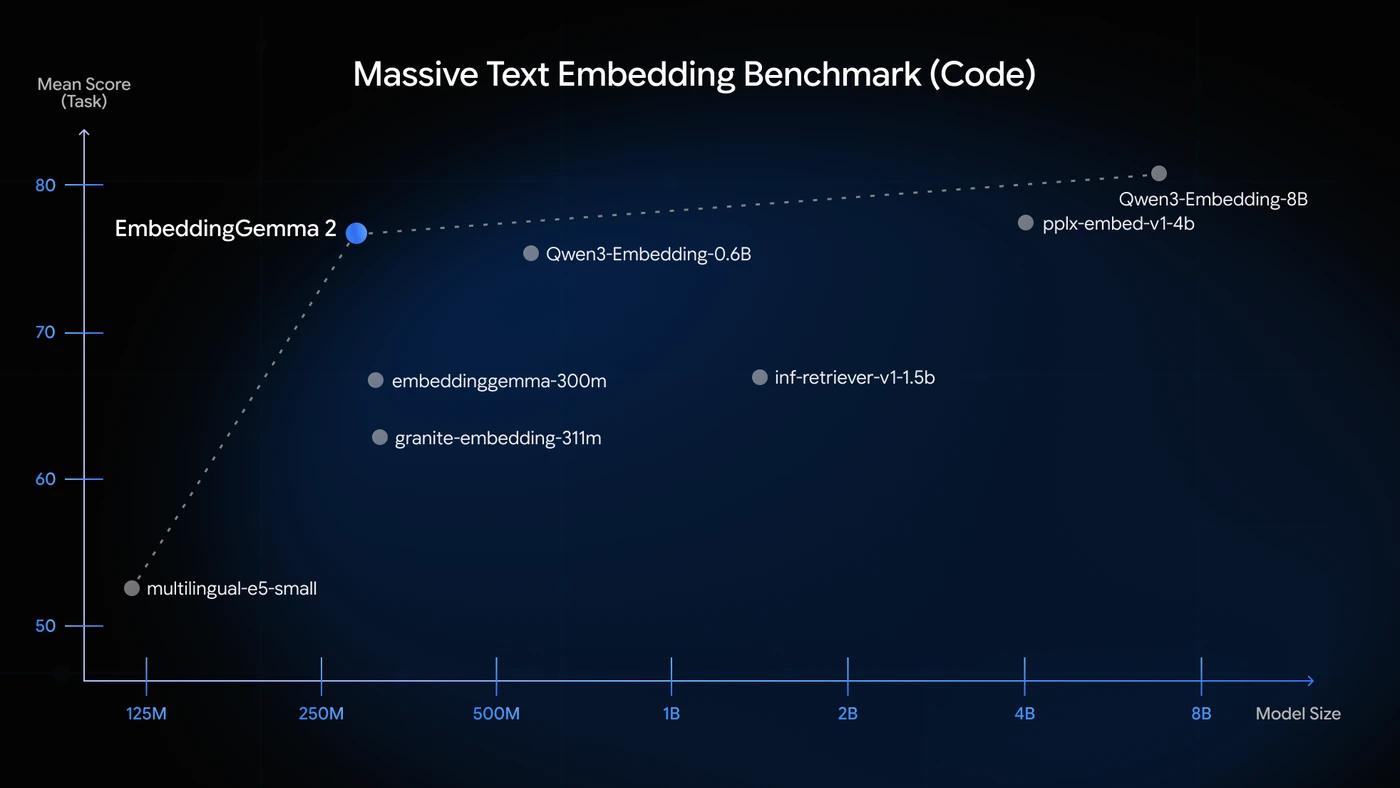
Nossa leitura é que o título é amplo e melhor recuperação de código, com desempenho de texto multilíngue aproximadamente preservado. Isso é mais útil do que tratar uma porcentagem de um benchmark como uma melhoria prometida para cada consulta de pesquisa comercial.
A pergunta de acompanhamento correta é: ele recupera seu fontes relevantes? Um modelo pode ter uma boa pontuação em tarefas públicas e ainda assim ter dificuldades com abreviações, diagramas incomuns, arquivos de idiomas mistos ou gravações de baixa qualidade. Um pequeno conjunto de avaliação de questões reais e evidências esperadas é mais prático do que um rótulo de vencedor universal.
Local não significa gratuito – ou automaticamente privado
Os pesos em aberto alteram a estrutura de custos. Você não está comprando uma taxa de token fixa da incorporação hospedada do Google API para esta versão. Você é responsável pela computação, memória, tempo de indexação, implantação e manutenção. A versão Apache 2.0 permite um caminho de implantação diferente; não elimina custos operacionais.
Isso pode ser atraente quando o conteúdo precisa ficar próximo ao usuário ou funcionar sem conexão de rede. do Google Guia AI Edge demonstra pesquisa de mídia local e recuperação de vídeo em dispositivos de consumo. Suas medições de memória e latência estão vinculadas a dispositivos, configurações e cargas de trabalho específicas, o que não é uma garantia para todos os laptops ou telefones.
Para um piloto, mediríamos toda a experiência: quanto tempo leva para construir o primeiro índice, quão rápido as consultas retornam após a indexação, pico de memória durante o processamento, impacto da bateria e o que acontece quando os arquivos são alterados. Uma consulta rápida não é a mesma coisa que uma importação inicial rápida.
A privacidade também é uma propriedade do aplicativo. A inferência de incorporação local pode manter o material de origem fora de uma incorporação remota API. Mas backups em nuvem, telemetria, um banco de dados vetorial remoto ou um modelo de resposta hospedado ainda podem mover dados para outro lugar. Mapeie o caminho completo dos dados antes de chamar um sistema de “totalmente local”.
Da mesma forma, os vetores não são um sistema de controle de acesso. Preserve as permissões de origem e filtre os resultados para a pessoa que fez a pergunta. Um arquivo privado não deve ser descoberto apenas porque seu vetor compartilha um índice com material público.
Vetores menores: economias úteis com uma compensação real
O modelo suporta o encurtamento de seus embeddings, uma técnica chamada Matryoshka Representation Learning. do Google guia do desenvolvedor explica os tamanhos suportados e a necessidade de normalizar um vetor novamente após o truncamento.
A ideia prática é simples: armazenar menos números por item pode tornar um índice grande menor. Reduzir um vetor de 768 para 128 dimensões reduz em seis vezes a carga útil do vetor bruto quando o formato do número permanece o mesmo. Isso não torna todo o aplicativo ou banco de dados seis vezes mais barato; arquivos originais, metadados e sobrecarga de índice de pesquisa ainda existem.
Nem a menor configuração é uma atualização de qualidade gratuita. Os resultados do Google mostram uma queda multimodal mais substancial em 128 dimensões do que em 256 ou 512. Começaríamos um piloto de pesquisa de mídia no tamanho nativo, estabeleceríamos a linha de base de recuperação e então testaríamos vetores menores contra as mesmas questões. As consultas e os itens indexados devem usar dimensões compatíveis.
Esta é uma boa otimização para fazer depois de provar a utilidade. Salvar armazenamento em um índice que retorna a gravação errada não é uma grande vitória.
EmbeddingGemma 2 versus Gemini Embedding 2, OpenAI e Cohere
Estes não são modelos de entrega intercambiáveis. A primeira decisão geralmente é se você deseja executar os embeddings sozinho ou consumir um serviço gerenciado. Os benchmarks públicos não estabelecem um vencedor justo em todos os tempos de execução, corpus e modalidades.
Gemini Embedding 2: recuperação multimodal gerenciada
Gemini Embedding 2 é a opção de incorporação multimodal hospedada do Google. Seu guia API atual suporta texto, imagens, áudio, vídeo e PDFs, com uma saída padrão de 3.072 dimensões e saídas menores configuráveis. A documentação de incorporação do Gemini do Google,, é a referência para o comportamento do API.
Nossa opinião: considere a Gemini quando a infraestrutura gerenciada for a prioridade; considere EmbeddingGemma quando a operação local ou o controle sobre a implantação for central. A compensação não é simplesmente “vetores grandes versus vetores pequenos”. Você está escolhendo onde o processamento acontece e quem o opera. Veja a comparação EmbeddingGemma 2 vs Gemini Embedding 2.
OpenAI text-embedding-3-large: um API com foco em texto
OpenAI text-embedding-3-large é um modelo de incorporação de texto hospedado, não uma substituição nativa de incorporação de imagem, áudio ou vídeo. OpenAI documenta uma saída padrão de 3.072 dimensões e uma maneira de solicitar menos dimensões. O preço padrão do API atualmente listado é de US$ 0,13 por milhão de tokens de entrada; isso é uso de API, não uma assinatura de ChatGPT. Guia de incorporação do OpenAI e Preços API explique o escopo.
Para um corpus de texto bem preparado, um serviço de texto gerenciado pode continuar sendo a escolha mais simples. Para recuperação de mídia nativa ou indexação offline, você está resolvendo um problema diferente. Nosso Página de comparação OpenAI separa esses recursos dos preços.
Cohere Embed 4: outra opção multimodal existente
Na programação do Cohere, Incorporar 4 lida com texto, imagens e conteúdo misto de documentos. Isso o torna uma comparação relevante para recuperação empresarial, especialmente quando os documentos de origem contêm informações escritas e visuais. Documentação de incorporação atual do Cohere lista sua família de modelos e recursos.
Compararíamos a carga de trabalho real de documentos, os requisitos de implantação e as opções de aquisição, e não assumiríamos que todos os modelos “multimodais” processam os mesmos arquivos da mesma maneira. Consulte EmbeddingGemma 2 vs Cohere Embed 4 para os fatos publicados.
Como experimentar sem transformar isso em um projeto de pesquisa
Comece com uma pergunta que as pessoas já têm dificuldade em responder. Escolha uma coleção limitada – um repositório de código, uma pasta de instruções visuais ou um pequeno conjunto de gravações. Evite indexar tudo antes de saber como é o sucesso.
Para uma introdução visual, os exemplos AI Edge Gallery do Google demonstram Instant Media Search e Video Moments Finder. O mesmo anúncio do AI Edge descreve um companheiro experimental de reunião local para Mac. Ele também descreve a integração do Android ML Kit como futura; não presuma que uma integração futura anunciada já esteja disponível.
Para desenvolvedores, a documentação Transformers explica os componentes do modelo e o processamento de mídia. A recuperação de vídeo usa quadros amostrados, portanto, um breve evento entre as amostras pode ser perdido. O contexto é compartilhado entre as entradas de uma solicitação; gravações mais longas e coleções de documentos ainda precisam de uma segmentação sensata.
Mantenha dois detalhes de implementação na lista de verificação. Primeiro, siga a consulta documentada e os prompts de tarefa do documento, em vez de tratar cada entrada de forma idêntica. Em segundo lugar, use a precisão numérica suportada: a orientação do ponto de verificação do Google recomenda bfloat16 ou float32 e alerta contra float16. Esses são detalhes para a pessoa que está construindo o piloto, e não decisões que um usuário final deveria tomar. As instruções oficiais do ponto de verificação cobrem ambos.
Então teste mais do que as pesquisas fáceis. Inclua correspondências próximas que não devem ser retornadas, informações ausentes, perguntas em idiomas mistos e arquivos que o usuário não tem permissão de acessar. Verifique se a fonte correta aparece nos primeiros resultados e inspecione as evidências em vez de julgar apenas a resposta final.
Se você estiver migrando de outro modelo, nossa recomendação é criar um índice candidato separado e incorporar novamente o corpus de teste. Os comprimentos dos vetores correspondentes não estabelecem compatibilidade entre diferentes modelos. Compare os dois sistemas na mesma coleção de origem antes de substituir um índice funcional.
Conclusão: um kit de ferramentas de recuperação mais amplo, não um substituto universal
EmbeddingGemma 2 é mais interessante onde o conhecimento útil está espalhado pela mídia e onde o processamento local tem um propósito claro. Ele expande o que uma camada de recuperação de peso aberto pode pesquisar, ao mesmo tempo que permite que os aplicativos carreguem apenas os codificadores de que precisam.
Nossa recomendação é tratá-lo como um piloto focado: provar que encontra as evidências corretas, verificar o caminho dos dados e medir o custo real do dispositivo. Se isso resolver esses problemas, o tamanho do modelo e as configurações vetoriais se tornarão escolhas úteis de engenharia. Caso contrário, um título de referência forte não é razão suficiente para mudar.
Navegue pelo incorporando biblioteca de modelos para alternativas ou use o Perfil EmbeddingGemma 2 por suas fontes, notas de implantação e comparações específicas. Esta é uma análise educacional do lançamento do Google, não um anúncio de que Cody fornece inferência EmbeddingGemma.
Perguntas frequentes
EmbeddingGemma 2 é um chatbot?
Não. Ele produz vetores incorporados que o software usa para recuperação, similaridade, classificação ou agrupamento. Um modelo generativo separado é necessário se o aplicativo escrever uma resposta.
O EmbeddingGemma 2 é gratuito?
O Google divulga os pesos em Apache 2.0. Isso não torna a computação, o armazenamento ou a hospedagem gratuitos. Não há uma única taxa de token API hospedada fixa na documentação de lançamento.
O que mudou em relação ao EmbeddingGemma 1?
A versão 2 adiciona recuperação nativa de imagem, áudio e vídeo junto com texto e código, expande o orçamento de contexto e oferece codificadores modulares. As avaliações do Google mostram um resultado de código mais forte e desempenho de texto multilíngue quase inalterado.
O EmbeddingGemma 2 pode ser executado offline?
A inferência local pode oferecer suporte à pesquisa off-line quando o software, os pesos e o conteúdo indexado necessários estiverem no dispositivo. O aplicativo completo estará off-line somente se seus outros componentes não exigirem serviços remotos.
EmbeddingGemma 2 é melhor que Gemini Embedding 2?
Não existe um vencedor universal estabelecido aqui. EmbeddingGemma 2 fornece pesos abertos para implantação local ou auto-hospedada, enquanto Gemini Embedding 2 é um API gerenciado. Compare a qualidade de recuperação, o suporte de mídia, o custo e os requisitos de implantação em seus próprios dados.
Ele substitui um analisador de documentos ou um banco de dados vetorial?
Não. Representa conteúdo para pesquisa. Análise, fragmentação, permissões de origem, indexação de vetores e geração de respostas permanecem responsabilidades separadas em um sistema RAG.