

- Narzędzia sztucznej inteligencji
- Sztuczna inteligencja
Czym jest Jev? Model System One TypeSafe AI wyjaśniony
Jev to nowy rodzaj modelu AI zaprojektowany do zwracania szybkich, typowanych decyzji zamiast prozy. Oto jak działa System One, jakie są jego koszty, gdzie znajduje zastosowanie oraz co jego wczesne dowody potwierdzają — a czego nie.
Większość modeli AI jest zaprojektowana do mówienia czegoś. Jev jest zaprojektowany do podejmowania decyzji — i zwracania odpowiedzi w formie, którą oprogramowanie może od razu wykorzystać.
Przychodzi wiadomość od klienta. Czy dotyczy fakturowania, wsparcia, czy sprzedaży? Odszukany fragment wydaje się istotny. Czy jest wystarczająco silny, aby wysłać go do modelu odpowiadającego? Agent proponuje działanie. Czy przepływ pracy powinien na to pozwolić, zablokować to, czy zapytać człowieka?
To tak naprawdę nie są zadania pisarskie. To małe osądy ukryte w oprogramowaniu. Zespoły często powierzały je modelowi językowemu ogólnego przeznaczenia, ponieważ to jest narzędzie AI, które już posiadają. Model odczytuje dane wejściowe, generuje odpowiedź jeden token naraz, a aplikacja analizuje odpowiedź z powrotem w etykietę, wynik lub wartość logiczną.
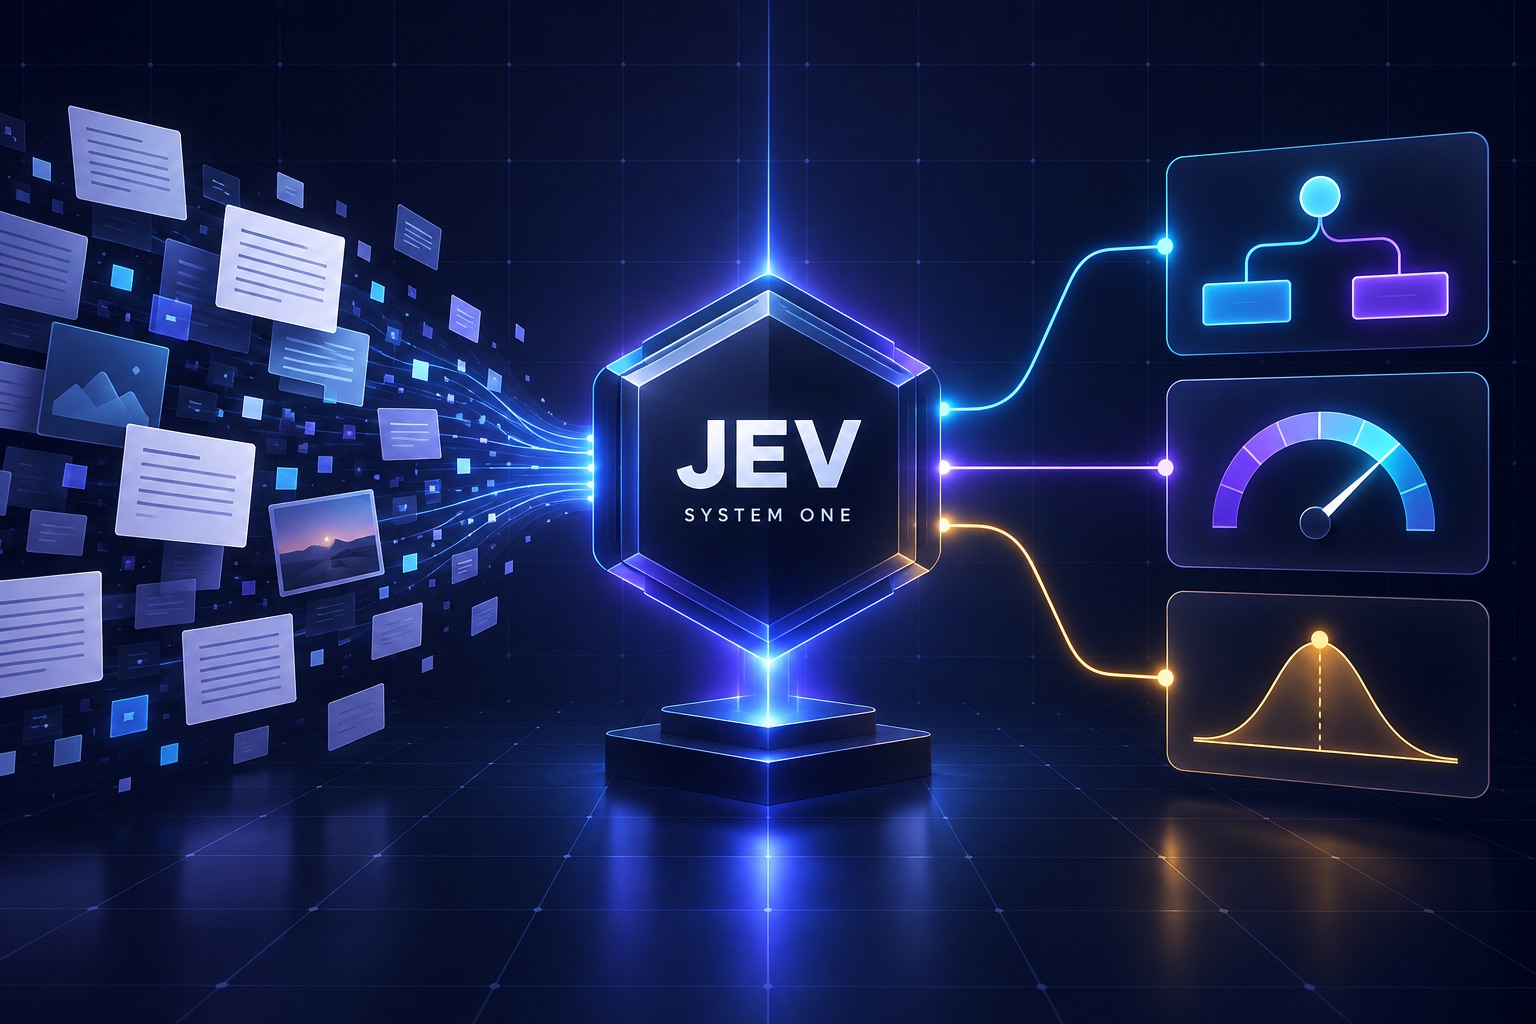
TypeSafe AI wprowadził Jev 15 września 2026 jako inny rodzaj modelu. Firma nazywa tę kategorię Modele System One: nieustrukturyzowany stan wchodzi, podczas gdy ograniczone wybory, wyniki, prawdopodobieństwa i pewność siebie wychodzą. Jev nie prowadzi rozmów, nie wyjaśnia ani nie pisze kodu. Dokonuje wąskich decyzji semantycznych.
To brzmi jak małe rozróżnienie. Może być jednak istotne. Jeśli wczesne twierdzenia Jev dotyczące szybkości, kosztów i kalibracji przetrwają szersze testy, aplikacje mogłyby przestać używać dużego modelu językowego dla każdej drobnej gałęzi w przepływie pracy. Wynik nie zastąpi LLM. Dałby LLM — i reszcie oprogramowania wokół niego — szybszą warstwę decyzji.
Ten przewodnik wyjaśnia, czym jest Jev, co oznacza „System One”, jak działają jego pytania dotyczące wyboru, wyniku i Noul, ile kosztuje, co pokazują dowody z benchmarków i gdzie jego ograniczenia mają znaczenie. Dla kompaktowych specyfikacji i źródeł pierwszej ręki, zobacz stronę modelu Jev 1.13 lub przeglądaj nową Kategoria modeli decyzyjnych AI.
Szybka odpowiedź — sprawdzono 17 września 2026
Jev 1.13 jest pierwszym modelem System One firmy TypeSafe AI. Akceptuje tekst, JSON lub tablice tekstu wraz z wcześniej zdefiniowanymi pytaniami, a następnie zwraca decyzje według typu z prawdopodobieństwami. TypeSafe wymienia go przy 0,042 USD za milion tokenów wejściowych z darmowym wyjściem i raportuje typową latencję end-to-end 70–500 milisekund dla odpowiednich zadań. Jest w wczesnym dostępie. Są to dane opublikowane przez dostawcę, a nie uniwersalne gwarancje.
| Fakt Jev | Aktualne szczegóły |
|---|---|
| Deweloper | TypeSafe AI |
| Aktualny model | Jev 1.13; ID API jev-1.13.0 |
| Premiera | 15 września 2026 |
| Co zwraca | Wybory, porządkowe wyniki, prawdopodobieństwa i sygnały pewności |
| Czego nie zwraca | Tekst otwarty, wyjaśnienia, kod, obrazy, dźwięk ani wideo |
| Pojemność wejściowa | 64 tys. tokenów na jedno żądanie; stan plus najdłuższe pytanie do 32 tys. |
| Cena | 0,042 USD za milion tokenów wejściowych; wyjście jest darmowe |
| Opublikowana prędkość | 70–500 ms od początku do końca dla zapytań w kształcie System One |
| Dostęp | Wcześniejszy dostęp do Playground i API z SDK w Python i JavaScript |
Czym jest AI Jev?
Jev to specjalistyczny model do wydawania ograniczonych ocen w oparciu o tekst lub uporządkowany stan. Zamiast nakłaniać go do „napisania obiektu JSON” i mieć nadzieję, że wygenerowana odpowiedź będzie zgodna z formatem, programista definiuje możliwe odpowiedzi przed inferencją. Jev następnie zwraca jedną z dozwolonych wartości—lub wynik bądź prawdopodobieństwo—wraz z informacją o niepewności.
Najprostszy model mentalny to bardzo zdolny klasyfikator, który potrafi rozumieć język naturalny, rozważać wiele pytań naraz i ujawniać, jak bardzo jest pewny. Taki opis jest bardziej użyteczny niż traktowanie Jev jak małego chatbota. Został zaprojektowany, aby działać w ramach aplikacji, a nie być samą aplikacją.
Wzorzec Jev
Nieustrukturyzowany stan → Jev → Wybór + wynik + prawdopodobieństwo → Kod aplikacji
Model zajmuje się oceną semantyczną. Kod nadal kontroluje reguły, progi, skutki uboczne, ścieżkę audytu i procedury awaryjne.
Załóżmy, że system wsparcia otrzymuje: „Zaktualizowałem wczoraj, ale moja karta została obciążona dwukrotnie i dodatkowa płatność nadal nie zniknęła.” Jedno żądanie Jev mogłoby zapytać, czy wiadomość dotyczy rozliczeń, jak pilna się wydaje, czy powinna zostać eskalowana oraz jak prawdopodobne jest, że zawiera wrażliwe informacje o koncie. Każde pytanie ma określony kształt wyjściowy. Aplikacja może przekierować zgłoszenie bez analizowania akapitu.
Obecny alias jev-latest resolves to jev-1.13.0. Większość czytelników nie musi zapamiętywać tego identyfikatora; ma to znaczenie głównie dla powtarzalnych testów produkcyjnych. Szersza idea to produkt: Jev jest pierwszym przedstawicielem kategorii, którą TypeSafe ma nadzieję, że poradzi sobie z wieloma drobnymi decyzjami dotyczącymi agentów, wyszukiwania, moderacji, operacji i przepływów pracy klientów.
Dlaczego nazywać ją modelem „System One”?
Nazwa pochodzi od podziału System 1 i System 2 spopularyzowanego przez psychologa Daniela Kahnemana. System 1 opisuje szybkie, intuicyjne osądy; System 2 opisuje wolniejsze, przemyślane rozumowanie. Analogii tej nie należy traktować jako stwierdzenia, że Jev myśli jak człowiek. Opisuje ona zadanie, do którego model został zoptymalizowany.
Frontier LLM taki jak GPT-6 Astra lub Claude Fable 5.1 jest zbudowany do szerokiej, twórczej pracy: badanie problemu, używanie narzędzi, pisanie kodu, wyjaśnianie kompromisów lub tworzenie dokumentu. Jev jest celowo węższy. Analizuje dostępny stan i szybko zwraca niewielką decyzję.
TypeSafe twierdzi, że architektura używa równoległy próbnik zamiast generowania odpowiedzi token po tokenie. Jego dokumentacja mówi również, że pytania w tym samym żądaniu są oceniane niezależnie i równolegle. Oznacza to, że dodanie kilku pytań dotyczących klasyfikacji lub oceny powinno mieć znacznie mniejszą karę za opóźnienie niż proszenie ogólnego LLM o ich przetwarzanie sekwencyjnie.
Firma trenowała Jev używając RLCD, skrót od Reinforcement Learning for Calibrated Decisions. Ważnym celem z perspektywy użytkownika jest kalibracja: przy wielu podobnych prognozach prawdopodobieństwo 80% powinno być poprawne w przybliżeniu w 80% przypadków. Kalibracja nie obiecuje, że pojedyncza odpowiedź jest poprawna. Sprawia, że niepewność jest bardziej użyteczna do kierowania i ustalania progów.
Choice, Score i Noul: trzy typy pytań Jev
Jev obecnie udostępnia trzy prymitywy. Razem obejmują one dużą część małych ocen ukrytych wewnątrz oprogramowania biznesowego.
Wybór pozwala na selekcję z dozwolonego zestawu
Pytanie typu Wybór daje Jev stałą listę etykiet: fakturowanie, wsparcie techniczne, sprzedaż, anulowanie lub coś innego. Odpowiedź zawiera wybraną etykietę, rozkład prawdopodobieństwa wśród dostępnych opcji oraz wartość pewności wyprowadzoną z tego rozkładu.
Jest to stosowane do klasyfikacji intencji, kierowania zgłoszeń, wyboru polityki, oznaczania treści oraz decyzji, który narzędzie lub agent powinien otrzymać zadanie. Dokumentacja TypeSafe obsługuje do 255 wyborów. W przypadku bardzo dużych zestawów etykiet zaleca się zawężenie pola, a następnie podjęcie drugiej decyzji, zamiast traktowania setek niemal identycznych wyborów jako jednego płaskiego problemu.
Skala umieszcza element na uporządkowanej skali
Pytanie typu Score definiuje uporządkowany zakres — na przykład pilność od jeden do pięciu lub jakość potencjalnego klienta od zera do dziesięciu. Jev zwraca wynik wraz z rozkładem dopuszczalnych wartości i sygnałem pewności.
Wyniki są przydatne, gdy istotna jest różnica między sąsiednimi wynikami. Wynik ryzyka równy cztery jest bliższy pięciu niż jedynce; prosty zestaw niepowiązanych etykiet nie wyraża tej kolejności. Aplikacje mogą przekształcić wynik w poziomy usług, kolejki przeglądu, progi lub priorytetyzację.
Noul szacuje prawdopodobieństwo stwierdzenia.
Pytanie Noul wymaga wartości między zerem a jeden: jak prawdopodobne jest, że ten fragment odpowie na zapytanie, jak prawdopodobne jest, że żądanie naruszy zasady, lub jak prawdopodobne jest, że ten ślad agenta wskazuje na błąd? Noul zwraca prawdopodobieństwo bezpośrednio. W odróżnieniu od Choice i Score, obecna odpowiedź Noul nie dodaje oddzielnej właściwości pewności.
Dziwna nazwa jest mniej ważna niż wzorzec. Zamiast zmuszać model do mówienia „tak” lub „nie” na arbitralnej granicy, aplikacja otrzymuje prawdopodobieństwo i sama wybiera granicę. Bezpieczna decyzja personalizacyjna może zaakceptować 0,65. Ryzykowna płatność lub działanie związane z bezpieczeństwem może wymagać 0,98 i drugiej weryfikacji.
Czy Jev naprawdę ma „zero halucynacji”?
TypeSafe używa zdecydowanego języka w kontekście halucynacji, ponieważ Jev nie może wymyślić czwartej kategorii, gdy schemat pozwala tylko na trzy, zwrócić akapit, w którym kod oczekuje liczby, ani improwizować nierozpoznane pole. To jest znacząca poprawa niezawodności. The kształt odpowiedź jest ograniczona.
To nie oznacza, że wyrok jest zawsze prawdziwy. Jev może nadal wybrać błędną etykietę, przypisać zbyt wysoką ocenę, źle zrozumieć pośrednią instrukcję lub stać się mniej niezawodny, gdy dane wejściowe są wrogie lub pełne nieistotnych materiałów. Własne TypeSafe Przewodnik po poszarpaniach Jev 1.13 dokumentuje te słabości.
Dokładny sposób, aby to powiedzieć, jest:
- Halucynacja schematu jest ograniczona. Wynik musi odpowiadać zadeklarowanemu typowi decyzji.
- Błąd semantyczny jest nadal możliwy. Prawidłowa etykieta nadal może być błędną etykietą.
- Pewność pomaga zarządzać błędem. Może to wywołać przegląd lub plan awaryjny, ale nie jest dowodem.
To rozróżnienie ma znaczenie dla każdego ustrukturyzowanego systemu AI. Tryb JSON w ogólnym LLM może gwarantować pola możliwe do sparsowania, podczas gdy wartości wewnątrz tych pól pozostają błędne. Jev zmniejsza problem dalej, specjalizując cały model wokół ograniczonych decyzji, ale zespoły produkcyjne nadal potrzebują ocen i bezpiecznych progów.
Jak szybki i tani jest Jev?
Aktualna strona modelu TypeSafe wymienia Jev 1.13 jako 42 USD za miliard tokenów wejściowych, co odpowiada 0,042 USD za milion tokenów wejściowych. Wynik jest darmowy, ponieważ Jev nie generuje długiej odpowiedzi. W takim tempie milion żądań klasyfikacji po 500 tokenów zużyłby 500 milionów tokenów wejściowych i wiązałby się z kosztem listy modeli wynoszącym około $21, przed uwzględnieniem jakichkolwiek kosztów związanych z aplikacją, przechowywaniem, siecią czy przeglądem przez człowieka.
Post powitalny raportuje 70 do 500 milisekund kompleksowo dla zadań dostosowanych do System One, i twierdzi o przyspieszeniu od 40× do 200× w porównaniu z ogólnymi modelami używanymi w swoich porównaniach. Te liczby wymagają kontekstu, jaki sam TypeSafe zapewnia:
- większość testów czasowych była przeprowadzana na laptopach na zachodnim wybrzeżu USA;
- cztery oceny przepływu pracy zostały zaprojektowane przez zespół TypeSafe;
- etykiety porównawcze pochodziły z odpowiedzi wysokiego poziomu GPT-6 Astra i Claude Fable 5.1, a nie z niezależnych, ludzkich etykiet referencyjnych; oraz
- firma twierdzi, że wczesne ceny mogą być dotowane i nie powinny być traktowane jako stałe.
Innymi słowy, dowody z wprowadzenia są obiecujące, ale nie rozstrzygające. Nagłówek maksymalny – 193,6× szybciej i 444,6× taniej – jest korzystnym wynikiem zestawu zadań prowadzonych przez dostawcę, a nie uniwersalnym współczynnikiem konwersji dla każdego wywołania LLM.
Co faktycznie pokazują wczesne oceny Jev
TypeSafe publikuje cztery oceny przepływu pracy obejmujące klasyfikację incydentów bezpieczeństwa, obserwowalność śladów agenta, przetwarzanie faktur oraz decyzje dotyczące obsługi klienta. Każdy przepływ pracy rozkłada jeden szeroki prompt na kilka typowanych pytań, a następnie porównuje dokładność, koszty i czas z ogólnym modelem bazowym.
Główny wniosek dotyczy mniej rankingu, a bardziej wzoru przepływu pracy. Jeśli zadanie kończy się kilkoma etykietami lub liczbami, model specjalistyczny może uniknąć korzystania z ogólnego LLM do tworzenia i seryjnego generowania odpowiedzi, której nigdy nie musiałby pisać. Równoległe pytania mogą również zastąpić kilka osobnych wywołań.
Istnieje jeden przydatny dowód z zewnątrz. Inżynier Malte Ubl napisał, że uruchomił Jev w stosunku do istniejącej oceny klasyfikatora, która używała Gemini 2.5 Flash-Lite; w tym jednym teście Jev nasycił ocenę jakości i działał około sześć razy szybciej. Ten raport jest zachęcające, ponieważ ocena miała miejsce przed Jev, ale nadal jest to test jednego programisty — a nie szeroka, niezależna seria testów porównawczych.
Dla szybkiego wizualnego wyjaśnienia Matija Sosic opublikował 45-sekundowe podsumowanie Jev. Steve Krouse również udostępnił demonstracja na żywo w małej skali który sprawia, że wzorzec stan-i-pytania jest łatwiejszy do odczucia niż tabela testów porównawczych.
Dowody są wystarczające, aby uzasadnić testowanie Jev. Nie są jeszcze wystarczające, aby stwierdzić, że Jev pokonuje każdy mały LLM, klasyfikator, ranker ponowny lub silnik reguł. Sprawiedliwa ocena powinna używać zamrożonych przykładów z faktycznego produktu, etykiet sprawdzonych przez ludzi, tej samej ścieżki sieci i polityki progowej wybranej przed zobaczeniem wyników.
Jev vs LLM: co jest naprawdę inne?
| Wymiar | Jev / System One | Ogólne zastosowanie LLM |
|---|---|---|
| Główne zadanie | Wybierać, punktować lub szacować prawdopodobieństwo | Generować, rozumować, wyjaśniać, kodować i używać narzędzi |
| Wyjście | Wstępnie zdefiniowane wartości typowane | Tokeny otwarte, opcjonalnie ograniczone do JSON |
| Niepewność | Rodzimie obsługiwane rozkłady prawdopodobieństwa i pewność, jeśli dostępne | Zwykle nie ujawniane jako skalibrowany sygnał aplikacyjny |
| Wiele pytań | Niezależne pytania oceniane równolegle | Często odpowiedzi w jednej wygenerowanej sekwencji lub w kilku wywołaniach |
| Najlepsze do | Decyzje semantyczne o wysokiej objętości i wąskim zakresie | Niejasne, kreatywne, wieloetapowe lub wyjaśniające zadania |
| Nie może wykonywać | Pisać prozy, kodu ani wyjaśnień | Może generować wszystkie trzy |
Właściwe porównanie to więc nie „Czy Jev może pokonać model graniczny?” Chodzi o „Dlaczego prosimy model graniczny, aby wykonał to konkretne zadanie?” A mały model ogólny taki jak GPT-5.6 Luna lub Claude Haiku 4.5 pozostaje bardziej elastyczny. Może wyodrębnić pole, przepisać wiadomość, wywołać narzędzie i wyjaśnić swoją odpowiedź w tym samym żądaniu. Jev rezygnuje z tej elastyczności w zamian za bardziej ścisłą umowę.
Jev kontra tryb wyjścia strukturalnego lub JSON
Wyjście strukturalne jest najbliższą znaną alternatywą. Programista dostarcza LLM schemat; dostawca ogranicza wygenerowaną odpowiedź tak, aby można ją było przetworzyć. Jest to doskonałe, gdy aplikacja potrzebuje bogatego obiektu z nazwami, opisami, datami lub innymi wygenerowanymi polami.
Jev lepiej pasuje do mniejszej przestrzeni wyjściowej. Odpowiedzi już istnieją; model jedynie je wybiera lub ocenia. Jest mniej wyjścia do wygenerowania, rozkład prawdopodobieństwa jest częścią produktu, a cała architektura jest zoptymalizowana pod kątem decyzji. Używaj trybu JSON, gdy potrzebujesz wygenerowanej treści w strukturze. Rozważ Jev, gdy każda prawidłowa odpowiedź jest już znana.
Jev a tradycyjny klasyfikator
Konwencjonalny klasyfikator może być niezwykle szybki i tani po przeprowadzeniu treningu. Może być najlepszym wyborem dla stabilnego problemu o dużej objętości, z wystarczającą ilością danych oznaczonych. Atutem Jev jest to, że stara się wprowadzić elastyczność języka naturalnego i konfigurację few-shot do tego rodzaju pracy, bez proszenia każdego zespołu o trenowanie i obsługiwanie osobnego modelu.
Kosztem jest kontrola. Niestandardowy klasyfikator można dostosować do wąskiej taksonomii, sprawdzić za pomocą znanych metryk i wdrożyć w środowisku prywatnym. Jev jest obecnie usługą dostępną we wczesnym dostępie. Zespoły powinny porównać nie tylko dokładność i opóźnienie, ale także lokalizację danych, potrzeby retreningu, zmiany etykiet i nakład pracy operacyjnej.
Jev vs reranker
Reranker taki jak Cohere Rerank 4 Fast przyjmuje zapytanie i kandydackie dokumenty, a następnie porządkuje te kandydatury według trafności. Jev może zapytać, czy fragment tekstu odpowiada na pytanie lub ocenić fragment według rubryki, ale nie jest automatycznie modelem do ponownego rankingu z tym samym celem treningowym i kontraktem specyficznym dla wyszukiwania.
Dla RAG narzędzia mogą się wzajemnie uzupełniać. Wyszukiwanie znajduje kandydatów, ponowne uporządkowanie ustala ich kolejność, a Jev może podjąć ograniczoną decyzję, na przykład „Czy główny dowód jest wystarczający, aby odpowiedzieć?” lub „Który temat polityki wspiera ten fragment?” Następnie większy model pisze cytowaną odpowiedź tylko wtedy, gdy warstwa decyzyjna stwierdzi, że dowód jest wystarczający.
Gdzie Jev może być przydatny
1. Kierowanie zapytań i pracą agenta
Jev może sklasyfikować nadchodzące żądanie, wybrać specjalistycznego agenta, ocenić pilność i zdecydować, czy osoba musi je przejrzeć. Ponieważ każdy wynik jest ograniczony, koordynator nie musi interpretować odpowiedzi narracyjnej przed podjęciem następnego kroku.
2. Dodawanie bramek zaufania dla agentów AI
Agent może zaproponować działanie, podczas gdy Jev osobno ocenia, czy działanie odpowiada celowi użytkownika, mieści się w polityce, czy wydaje się kompletne. Przypadki o niskiej pewności mogą powodować wstrzymanie. To nie jest pełna granica bezpieczeństwa — model nadal może być wpływany przez wrogie dane wejściowe — ale może dodać szybkie sprawdzenie semantyczne zanim kod wymusi ostateczną zasadę.
3. Ulepszanie RAG i wyszukiwania w przedsiębiorstwie
Systemy dokumentów już wykorzystują specjalistyczne warstwy: parser, taki jak Cohere Parse lub narzędzia open-source w naszym Przewodnik Docling odzyskują strukturę; embedingi wyszukują kandydatów; rerankery zmieniają ich kolejność. Jev mógłby dodać kolejną decyzję: czy dowody są wystarczające, sprzeczne, wrażliwe, przestarzałe lub odpowiednie dla konkretnej ścieżki odpowiedzi.
4. Triage, punktacja i operacje
Leady, zgłoszenia wsparcia, faktury, raporty incydentów, recenzje i ślady agenta wszystkie zawierają nieustrukturyzowany język, który ostatecznie staje się kolejką lub wynikiem. Jev został zaprojektowany do tej konwersji. Wartość jest najwyższa, gdy taksonomia zmienia się wystarczająco często, aby tworzenie własnego klasyfikatora było niewygodne, ale wyjście pozostaje na tyle ograniczone, że nie jest potrzebna proza.
5. Decyzje map-reduce nad wieloma elementami
Proces pracy może stosować to samo pytanie niezależnie do fragmentów, rekordów, wiadomości lub śladów, a następnie pozwolić kodowi agregować wyniki. To utrzymuje model skoncentrowany na lokalnych ocenach semantycznych, podczas gdy deterministyczny kod zajmuje się liczeniem, progami i ostatecznym wyborem.
Gdzie Jev nie jest odpowiednim narzędziem
TypeSafe jest niezwykle bezpośredni w kwestii nierównych krawędzi Jev. Ta przejrzystość jest użyteczna, ponieważ specjalistyczny model może wydawać się szeroko inteligentny w jednym demo, a zawieść przy sąsiednim zadaniu.
- Nie używaj go do pisania. Jev nie może tworzyć szkicu odpowiedzi, wyjaśnienia, streszczenia ani linii kodu.
- Zachowaj arytmetykę w kodzie. Dostawca dokumentuje słabości w liczeniu, obliczeniach i precyzji numerycznej.
- Zachowaj logikę dat w kodzie. Porównywanie dat i godzin to udokumentowany słaby punkt.
- Formułuj pytania dosłownie. Pośrednie lub zagnieżdżone instrukcje mogą zmniejszać niezawodność.
- Usuń nieistotny kontekst. Duże ilości niepowiązanego stanu mogą zaszkodzić decyzji, nawet jeśli mieszczą się w limicie kontekstu.
- Testuj dane przeciwnika. Wstrzykiwanie poleceń i sprzeczne instrukcje mogą nadal wpływać na model.
- Nie myl kalibracji z pewnością. Wysoka wartość pewności wymaga weryfikacji na danych produktu.
Dobrą zasadą jest pozostawienie faktów deterministycznych systemom deterministycznym. Kod powinien obliczać sumy, porównywać znaczniki czasu, sprawdzać uprawnienia, wymuszać limity i wykonywać efekty uboczne. Jev powinien zajmować się częścią, która naprawdę wymaga oceny semantycznej.
Praktyczna architektura: używaj Jev obok LLM.
Najbardziej przekonującym projektem jest kaskada, a nie zastąpienie:
- Kod wykonuje twarde sprawdzenia. Sprawdź uwierzytelnianie, limity, wymagane pola, daty i zasady liczbowe.
- Jev podejmuje wąską decyzję semantyczną. Skategoryzuj żądanie, oceniaj ryzyko lub szacuj, czy dowody są wystarczające.
- Przepływ pracy uwzględnia niepewność. Zaakceptuj pewną decyzję o niskim ryzyku, skieruj niejasną sprawę do większego modelu lub poproś o opinię osoby.
- LLM zajmuje się pracą generatywną. Napisz odpowiedź, zbadaj problem, użyj zatwierdzonych narzędzi lub wyjaśnij wynik.
- Kod jest właścicielem działania. Zaloguj decyzję i wersję źródłową, egzekwuj politykę i dokonaj ostatecznej zmiany stanu.
Ten układ może zarezerwować kosztowne rozumowanie dla przypadków, które tego potrzebują. Może też ułatwić audyt agenta: zapis decyzji zawiera pytanie, dozwolone odpowiedzi, prawdopodobieństwo, próg, wybraną trasę i wersję modelu zamiast nieprzejrzystego akapitu, który został zinterpretowany przez inny komponent.
Jak ocenić Jev przed użyciem go w produkcji
- Zacznij od istniejącej decyzji. Wybierz zadanie, które już kończy się etykietą, uporządkowanym wynikiem lub prawdopodobieństwem — a nie zadanie pisemne wciśnięte w demonstrację klasyfikacji.
- Zamroź reprezentatywny zestaw testowy. Uwzględnij łatwe przypadki, niejasne przypadki, rzadkie etykiety, długie dane wejściowe, sprzeczny język oraz przykłady adwersarialne.
- Używaj etykiet sprawdzonych przez człowieka. Konsensus LLM może uruchomić eksplorację, ale dokładność produkcji powinna być mierzone w oparciu o standard, który został zatwierdzony przez ludzi.
- Mierz kalibrację, nie tylko dokładność. Grupuj przewidywania według prawdopodobieństwa i sprawdź, czy pewność odpowiada zaobserwowanej poprawności.
- Ustaw progi według konsekwencji. Optymalizuj kompromis między fałszywymi alarmami a przeoczeniami dla rzeczywistej decyzji. Tag marketingowy i blokada płatności nie powinny dzielić tego samego progu.
- Porównaj pełny koszt zadania. Uwzględnij ponowne próby, zapasowe wywołania LLM, przeglądy ludzkie, sieci i inżynierię — nie tylko cenę tokena.
- Przypiąć wersję modelu. Use
jev-1.13.0dla powtarzalnej oceny; przejść dojev-latesttylko z testami regresji. - Loguj się bezpiecznie. Zanotować wystarczająco, aby debugować decyzję, bez przechowywania wrażliwego tekstu źródłowego dłużej niż to konieczne.
Dostęp Jev API w prostym języku angielskim
Jev jest dostępny poprzez wczesny dostęp API i Playground firmy TypeSafe. API używa POST /v1/systemone, a TypeSafe udostępnia SDK dla Pythona i JavaScriptu. Żądanie zawiera stan współdzielony oraz jedno lub więcej pytań. Odpowiedź zawiera wyniki typowane.
Obecnie opublikowane limity w trybie wczesnego dostępu to 250 000 tokenów wejściowych na sekundę i 1 200 żądań na minutę, chociaż TypeSafe informuje, że limity są dynamiczne, w miarę stabilizowania się popytu. Jedno żądanie może zawierać kilka niezależnych pytań, więc przepływ pracy może nie wymagać wywołania sieciowego dla każdej decyzji.
Programiści powinni pamiętać o dwóch aliasach. jev-latest podąża za stabilną linią produkcyjną i obecnie wskazuje na Jev 1.13. jev-preview jest przeznaczony dla najnowszego kandydata i obecnie wskazuje na tę samą wersję. Przypnij numeryczne ID, gdy zmiana w zachowaniu mogłaby wpłynąć na regulowany lub o dużym znaczeniu przepływ pracy.
Ochrona prywatności i kwestie korporacyjne
Polityka prywatności TypeSafe mówi, że dane wprowadzane przez klientów nie są wykorzystywane do trenowania ani dostrajania jej modeli. Informuje również, że usługi są hostowane w Stanach Zjednoczonych. Publiczna polityka nie obiecuje jednego stałego okresu zerowego przechowywania dla każdego żądania API; opisuje przechowywanie danych osobowych w zakresie uzasadnionym do określonych celów.
To nie jest tożsame z twierdzeniem, że Jev jest nieodpowiedni do danych przedsiębiorstw. Oznacza to, że nabywcy powinni uzyskać dokładne warunki dotyczące przetwarzania danych, przechowywania, podwykonawców, usuwania, bezpieczeństwa i regionu, które są wymagane przez ich obciążenie. Wczesny dostęp to także odpowiedni moment, aby zapytać o zobowiązania dotyczące poziomu usług, dzienniki audytowe, powiadomienia o wersjach modeli, reagowanie na incydenty i gwarancje dotyczące pojemności.
Najczęściej zadawane pytania
Czym jest Jev?
Jev jest pierwszym modelem System One firmy TypeSafe AI. Przekształca tekst lub ustrukturyzowany stan w z góry określone wybory, oceny i prawdopodobieństwa dla kodu aplikacji, zamiast generować otwartą prozę.
Czy Jev jest LLM?
TypeSafe przedstawia Jev jako nową kategorię modeli specjalistycznych, a nie jako uniwersalny LLM. Rozumie stan w języku naturalnym, ale jego zadaniem jest ograniczone podejmowanie decyzji, a nie generowanie tekstu token po tokenie.
Ile kosztuje Jev?
TypeSafe obecnie wycenia Jev 1.13 na 0,042 USD za milion wejściowych tokenów, bez opłaty za tokeny wyjściowe. Firma twierdzi, że wczesne ceny mogą być subsydiowane, więc nabywcy produkcyjni powinni sprawdzić aktualną stawkę.
Jak szybki jest Jev?
TypeSafe raportuje opóźnienie end-to-end 70–500 ms dla odpowiednich zapytań System One. To zakres podawany przez dostawcę, a nie uniwersalny SLA, a geografia, obciążenie, długość wejścia i projektowanie przepływu pracy mogą zmienić wynik.
Czym są Choice, Score i Noul?
Wybór wybiera spośród wcześniej zdefiniowanych etykiet, Score wybiera wartość na uporządkowanej skali, a Noul zwraca prawdopodobieństwo od zera do jeden. Choice i Score zwracają również rozkłady i wartość pewności; Noul zwraca samo prawdopodobieństwo.
Czy Jev halucynacjach?
Jev nie może wymyślić wyniku poza zadeklarowanym typem, co zapobiega nieprawidłowym lub otwartym odpowiedziom. Może jednak podjąć semantycznie błędną decyzję, dlatego zespoły muszą ocenić dokładność, kalibrację, zachowania przeciwników i progi.
Czy Jev może zastąpić GPT lub Claude'a?
Nie. Jev nie pisze, nie tłumaczy, nie koduje, nie przegląda ani nie obsługuje narzędzi. Może zastąpić niektóre wąskie wywołania klasyfikacji lub punktacji i kierować trudne przypadki do ogólnego modelu, takiego jak GPT czy Claude.
Czy Jev jest dobre dla RAG?
Potencjalnie, jako warstwa decyzyjna. Jev może ocenić, czy dowody są wystarczające, sklasyfikować fragmenty tekstu, ocenić istotność polityki lub kontrolować odpowiedź. Nie tworzy osadzeń, nie analizuje dokumentów, nie przeszukuje kandydatów domyślnie ani nie pisze ostatecznej odpowiedzi z cytatami.
Czy Jev jest ogólnie dostępny?
Nie. Jev jest dostępny we wczesnym dostępie poprzez Playground TypeSafe i API od 17 września 2026 r.
Źródła i metodologia
Artykuł ten był badany 17 września 2026 roku. Projekty produktów, szybkość, koszty i twierdzenia dotyczące testów porównawczych pochodzą od TypeSafe AI. uruchom artykuł, dokumentacja System One, strona modelu i cen, przewodnik pewności, szybki start, i strona oceny przepływu pracy. Ograniczenia pochodzą z przewodnika po poszarpaniu Jev 1.13 dostawcy; oświadczenia dotyczące obsługi danych pochodzą z jego polityka prywatności.
Oznaczamy wyniki dostarczane przez usługodawców jako roszczenia usługodawców. Wynik klasyfikatora Malte Ubla jest uwzględniany jako raport niezależnego praktyka, a nie jako uniwersalny punkt odniesienia. Nie uruchamialiśmy sami Jev i nie przeliczamy najwyższej prędkości ani współczynnika kosztów TypeSafe na roszczenie dotyczące niezwiązanych obciążeń. Ceny, aliasy, dostęp i wczesne ograniczenia mogą się zmieniać po publikacji.
Fundament
Jev jest interesujący, ponieważ kwestionuje nawyk, który stał się normą w oprogramowaniu AI: wysyłanie każdego zadania semantycznego do modelu stworzonego do pisania. Wiele decyzji produkcyjnych nie wymaga eseju. Potrzebują one znanej etykiety, uporządkowanego wyniku lub prawdopodobieństwa, na którym kod może operować.
Pierwsza wersja TypeSafe przedstawia ambitny argument za istnieniem tej wyspecjalizowanej warstwy. Cena jest niewielka, zgłaszane opóźnienie mierzone jest w milisekundach, kontrakt wyjściowy jest wąski, a niepewność jest dostępna dla aplikacji. Oceny po uruchomieniu i wczesne testy deweloperów sprawiają, że Jev jest wart poważnych eksperymentów.
Limity są częścią pomysłu, a nie myślą wtórną. Jev nie może wyjaśniać samego siebie, nie powinien wykonywać działań arytmetycznych ani logiki dat, nadal może błędnie klasyfikować i pozostaje podatny na słaby kontekst oraz instrukcje wrogie. Należy go umieścić pomiędzy deterministycznym kodem a ogólnego przeznaczenia LLM — nie ponad nimi.
Jeśli ta architektura sprawdzi się na rzeczywistych danych, „model System One” może stać się użyteczną kategorią. Jev nie musi zastępować GPT, Claude’a ani wytrenowanego klasyfikatora, aby mieć znaczenie. Musi jedynie obsłużyć wystarczającą liczbę drobnych decyzji wokół nich szybciej, taniej i z czystszym kontraktem.