- AI 도구
- 인공지능
EmbeddingGemma 2 설명: 다중 모드 검색 및 RAG
Google의 EmbeddingGemma 2는 텍스트, 코드, 이미지, 오디오 및 비디오를 지역 검색에 제공합니다. 변경된 사항, RAG에 맞는 위치, 전환하기 전에 테스트해야 할 사항은 다음과 같습니다.
"온보딩 프로세스를 설명하는 다이어그램"을 찾기 위해 프로젝트 폴더를 검색한다고 상상해 보세요. 답변은 깔끔한 제목의 문서가 아닌 슬라이드, 스크린샷 또는 녹화된 워크숍의 순간에 있을 수 있습니다. 텍스트 전용 검색 시스템은 해당 자료를 찾기 전에 해당 자료를 추출하거나 설명해야 합니다.
EmbeddingGemma 2는 해당 검색 문제에 대한 Google의 새로운 개방형 가중치 모델입니다. 2026년 10월 6일에 출시된 이 제품은 자체 하드웨어에서 실행하는 데 중점을 두고 공유 검색 공간에서 텍스트, 코드, 이미지, 오디오 및 비디오를 나타냅니다. 이것은 다른 챗봇이 아닌 검색 구성 요소입니다. Google의 출시 발표는 로컬, 다중 모드 방향을 제시합니다.
우리의 생각: 흥미로운 부분은 모든 비즈니스가 현재 임베딩을 교체해야 한다는 것이 아닙니다. 이제 민간 미디어 검색과 지역 AI 보조원이 또 다른 실용적인 구성 요소를 갖게 되었습니다. 시스템 개선 여부는 무엇을 검색해야 하는지, 어디에서 실행해야 하는지, 얼마나 많은 엔지니어링을 소유하고 싶은지에 따라 달라집니다.
사양 및 비교 링크는 EmbeddingGemma 2 모델 프로필를 참조하세요. 여기에서는 변경된 내용, RAG에 적합한 위치, 모델 용어를 잃지 않고 평가하는 방법에 대해 설명합니다.
EmbeddingGemma 2는 일반 영어로 무엇인가요?
임베딩은 콘텐츠를 숫자로 표현한 것입니다. 검색 소프트웨어는 해당 표현을 비교하여 표현이 다른 경우에도 의미 있게 관련된 항목을 찾습니다. 당신은 벡터를 읽지 않습니다. 실제로 읽고, 보고, 듣고 싶은 것을 찾는 데 사용합니다.
EmbeddingGemma 2는 이러한 아이디어를 미디어 전반으로 확장합니다. 단어로 입력된 질문은 텍스트의 또 다른 구절이 아닌 이미지나 녹음으로 이어질 수 있습니다. 공식 Google 체크포인트에는 텍스트 구성 요소와 선택적 비전 및 오디오 인코더가 포함되어 있습니다. 항상 전체 다중 모드 설정을 실행하는 대신 애플리케이션에 필요한 부분을 로드할 수 있습니다.
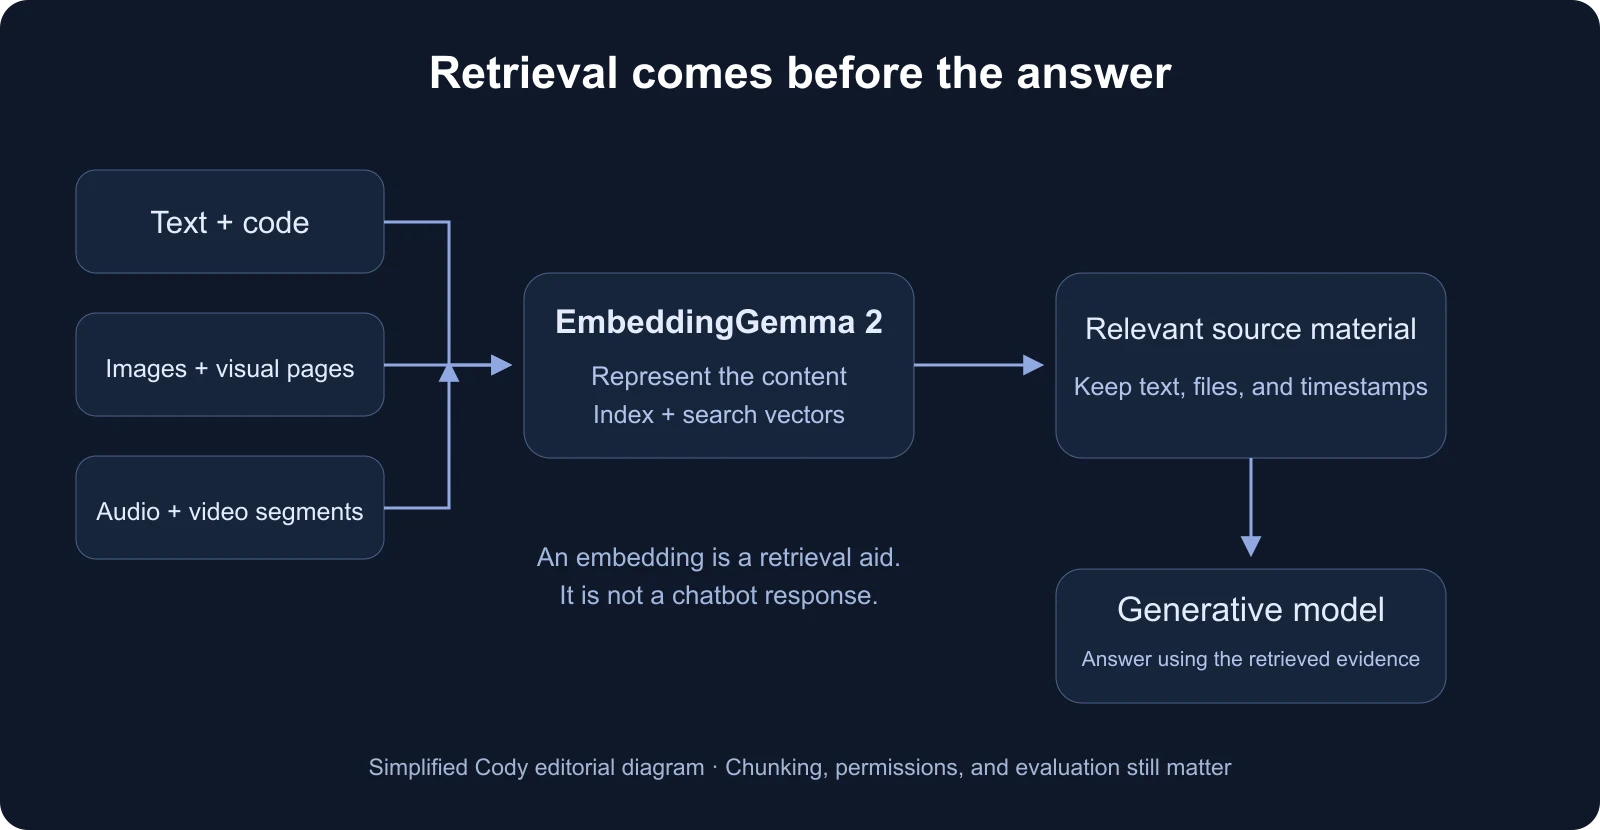
저자가 아니라 사서라고 생각하세요. 유용한 소스 자료를 식별하는 데 도움이 됩니다. 그러면 별도의 생성 모델이 해당 자료를 답변으로 바꿀 수 있으며 애플리케이션은 여전히 액세스 권한, 인용 및 원본 파일을 처리해야 합니다.
그 분리가 중요합니다. 설득력 있는 챗봇 답변은 취약한 검색 시스템을 숨길 수 있습니다. 검색을 개선하면 응답 모델에 더 나은 증거가 제공됩니다. 모든 답변이 자동으로 정확해지는 것은 아닙니다.
EmbeddingGemma 2 대 EmbeddingGemma 1: 무엇이 바뀌었나요?
원래 EmbeddingGemma는 이미 로컬 사용을 위해 설계된 소형 다국어 텍스트 임베딩 모델이었습니다. 버전 2는 Google의 기기 내 검색 스토리의 시작이 아닙니다. 주요 확장은 더 강력한 코드 검색 결과와 함께 미디어 지원입니다. Google의 버전 개요는 두 세대를 구분합니다.
| 중요한 것 | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| 주요 입력 | 텍스트 | 텍스트, 코드, 이미지, 오디오 및 비디오 |
| 건축 | Gemma 3 기반 | Gemma 4 기반 |
| 게시된 크기 | 308M 매개변수 | 텍스트/코드의 경우 270M; 모든 인코더 포함 740M |
| 컨텍스트 예산 | 토큰 2,048개 | 텍스트와 미디어 전반에 걸쳐 공유되는 8,192개의 토큰 |
| 벡터 크기 | 768, 지원되는 크기가 더 작음 | 768, 512, 256 또는 128 치수 |
| 웨이트 라이센스 | 젬마 용어 | Apache 2.0 |
버전 2 사양 및 라이센스는 Google의 모델 카드에 문서화되어 있습니다. 더 작은 텍스트 전용 구성은 주목할 가치가 있습니다. 미디어 기능을 추가한다고 해서 모든 애플리케이션이 전체 모델을 보유해야 한다는 의미는 아닙니다.
기존 텍스트 기술 자료의 경우 이는 자동 마이그레이션 순서가 아닌 평가 이유입니다. 버전 1이 이미 올바른 구절을 안정적으로 찾았다면 새로운 이미지 및 오디오 인코더가 해결하지 못한 문제를 해결할 수도 있습니다. 코드, 시각적 지침 또는 녹음을 검색하는 팀에는 버전 2를 시도해야 하는 더 분명한 이유가 있습니다.
RAG 및 개인 지식이 중요한 이유
검색 증강 생성(RAG)은 AI 모델에 답변을 요청하기 전에 관련 소스 자료를 찾는 것을 의미합니다. 첫 번째 단계의 품질이 이후의 모든 것을 형성합니다.
친숙한 예는 내부 지원 보조원입니다. 서면 문제 해결 메모를 통해 결함을 설명할 수 있지만 기술자는 올바른 커넥터를 보여주는 주석이 달린 사진이 필요할 수도 있습니다. 다중 모드 검색 레이어는 이러한 조각을 하나로 모으는 데 도움이 될 수 있습니다. 이는 가상의 사용 사례이지 이 모델이 안전에 중요한 지원 평가를 통과했다는 주장이 아닙니다.
먼저 세 가지 종류의 파일럿을 고려해 보겠습니다.
- 개인 미디어 라이브러리:는 일반적인 언어로 유용한 스크린샷, 제품 사진 또는 시각적 지침을 찾습니다.
- 로컬 개발자 보조:는 전체 저장소를 임베딩 서비스로 보내지 않고 관련 코드를 검색합니다.
- 검색 가능한 녹화 아카이브:는 전체 녹화를 훑어보는 대신 관련 세그먼트와 타임스탬프를 반환합니다.
각각의 경우에 검색은 증거를 다시 지적해야 합니다. 파일 참조, 문서 섹션, 액세스 범위, 미디어 타임스탬프를 벡터와 함께 유지하세요. 유사해 보이는 결과는 사용자가 열 수 없거나 결과가 반환된 이유를 이해할 수 없는 경우 충분하지 않습니다.
또한 문서 준비를 대체하지 않습니다. 시각적인 페이지를 찾는 것과 스프레드시트 수준의 테이블을 추출하는 것은 서로 다른 작업입니다. 문제가 PDF 읽기 순서 손상, 제목 누락 또는 신뢰할 수 없는 테이블 추출인 경우 수집 계층부터 시작하세요. 우리의 도킹 가이드 그리고 Cohere Parse 설명 파이프라인의 해당 부분을 덮습니다.
Google 벤치마크가 실제로 보여주는 것
발표된 결과는 "모든 것을 더 잘한다"는 것보다 더 구체적인 이야기를 말해줍니다. Google 모델 카드의 완전 정밀도 768차원 평가에서 다국어 MTEB 점수가 61.15에서 61.36으로 이동했습니다. 코드 MTEB 점수는 68.76에서 78.68로 이동합니다. 이는 특정 평가에 비해 상대적으로 약 14% 증가한 수치입니다. 이들은 자체 테스트가 아닌 Google에서 보고한 결과. 벤치마크 테이블 평가 버전 및 측정항목의 이름을 지정합니다.
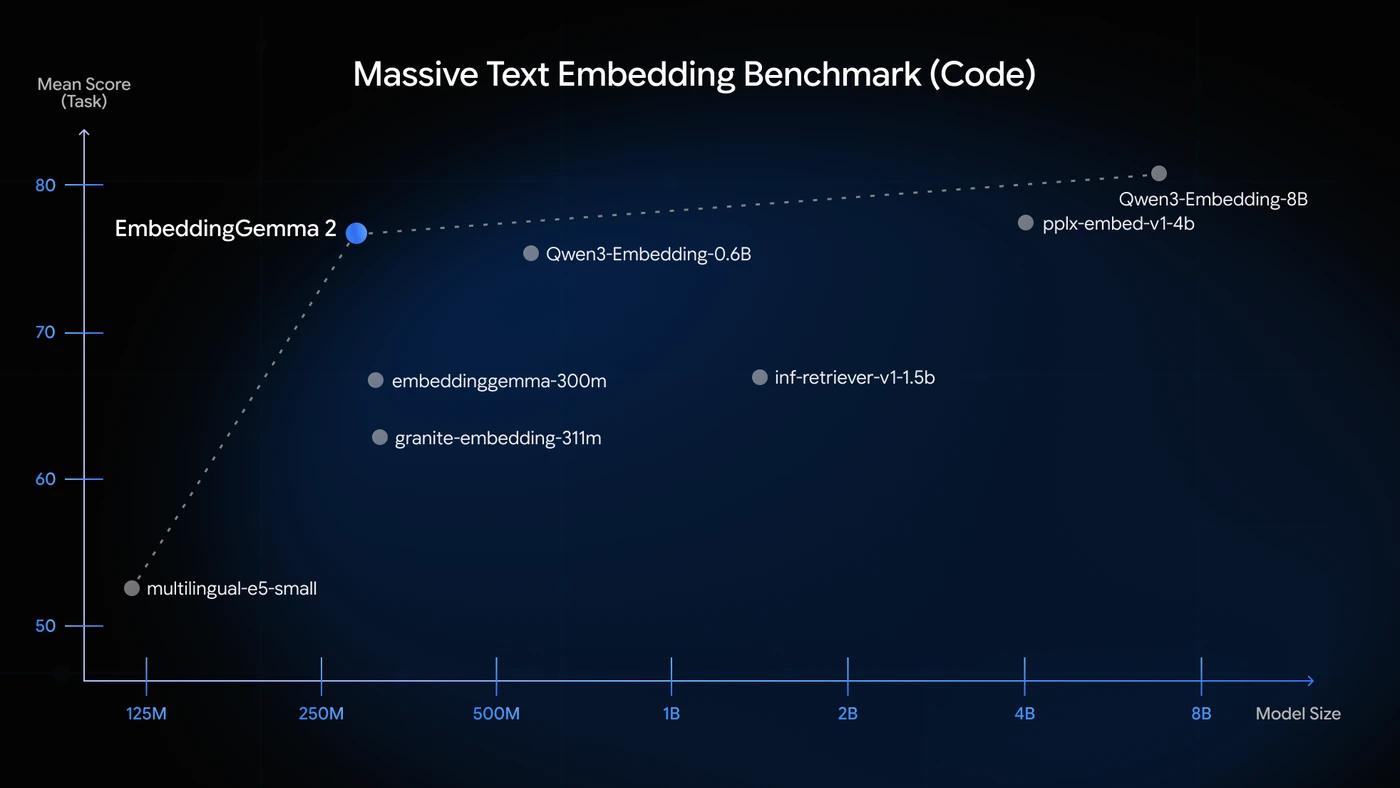
우리가 읽은 바에 따르면 헤드라인은 다국어 텍스트 성능이 대략 유지되면서 폭이 더 넓어지고 코드 검색이 향상되었습니다. 이는 한 벤치마크의 백분율을 모든 비즈니스 검색 쿼리에 대한 약속된 개선으로 간주하는 것보다 더 유용합니다.
올바른 후속 질문은 다음과 같습니다. 검색합니까? 너의 관련 소스? 모델은 공공 작업에서 좋은 점수를 받을 수 있지만 여전히 약어, 특이한 다이어그램, 혼합 언어 파일 또는 열악한 녹음으로 인해 어려움을 겪을 수 있습니다. 실제 질문과 예상 증거로 구성된 소규모 평가 세트는 보편적인 승자 라벨보다 실행 가능성이 더 높습니다.
로컬은 무료 또는 자동으로 비공개를 의미하지 않습니다.
개방형 가중치는 비용 구조를 변경합니다. 이번 릴리스에서는 Google의 호스팅 임베딩 API에서 고정 토큰 요율을 구매하지 않습니다. 컴퓨팅, 메모리, 인덱싱 시간, 배포 및 유지 관리를 담당합니다. Apache 2.0 릴리스에서는 다른 배포 경로를 허용합니다. 운영 비용이 제거되지는 않습니다.
이는 콘텐츠가 사용자 근처에 있어야 하거나 네트워크 연결 없이 작동해야 하는 경우 매력적일 수 있습니다. Google의 AI Edge 가이드는 소비자 장치에서 로컬 미디어 검색 및 비디오 검색을 보여줍니다. 메모리 및 대기 시간 측정은 특정 장치, 구성 및 작업 부하와 관련되어 있으며 모든 노트북이나 휴대폰에 대해 보장되는 것은 아닙니다.
파일럿의 경우 첫 번째 인덱스를 작성하는 데 걸리는 시간, 인덱싱 후 쿼리가 얼마나 빨리 반환되는지, 처리 중 최대 메모리, 배터리 영향, 파일 변경 시 발생하는 상황 등 전체 경험을 측정합니다. 빠른 쿼리는 빠른 초기 가져오기와 동일하지 않습니다.
개인정보 보호도 애플리케이션 속성입니다. 로컬 임베딩 추론을 통해 원본 자료가 API 원격 임베딩에 포함되지 않도록 할 수 있습니다. 그러나 클라우드 백업, 원격 측정, 원격 벡터 데이터베이스 또는 호스팅된 응답 모델은 여전히 데이터를 다른 곳으로 이동할 수 있습니다. 시스템을 "완전 로컬"이라고 부르기 전에 전체 데이터 경로를 매핑하십시오.
마찬가지로 벡터는 접근 제어 시스템이 아닙니다. 질문하는 사람을 위해 소스 권한을 유지하고 결과를 필터링하세요. 벡터가 공개 자료와 인덱스를 공유한다는 이유만으로 비공개 파일을 검색할 수 있어서는 안 됩니다.
더 작은 벡터: 실질적인 절충을 통한 유용한 절약
이 모델은 Matryoshka Representation Learning라는 기술인 임베딩 단축을 지원합니다. Google의 개발자 가이드에서는 지원되는 크기와 잘린 후 벡터를 다시 정규화해야 하는 필요성에 대해 설명합니다.
실용적인 아이디어는 간단합니다. 항목당 더 적은 숫자를 저장하면 큰 인덱스가 더 작아질 수 있습니다. 벡터를 768차원에서 128차원으로 줄이면 숫자 형식이 동일하게 유지되는 경우 원시 벡터 페이로드가 6배로 줄어듭니다. 전체 애플리케이션이나 데이터베이스를 6배 더 저렴하게 만드는 것은 아닙니다. 원본 파일, 메타데이터 및 검색 색인 오버헤드가 여전히 존재합니다.
가장 작은 설정도 무료 품질 업그레이드가 아닙니다. Google의 결과는 256 또는 512 차원보다 128 차원에서 더 실질적인 다중 모드 감소를 보여줍니다. 우리는 기본 크기에서 미디어 검색 파일럿을 시작하고 검색 기준선을 설정한 다음 동일한 질문에 대해 더 작은 벡터를 테스트했습니다. 쿼리와 색인이 생성된 항목은 호환되는 차원을 사용해야 합니다.
이는 유용성을 입증한 후에 수행하는 좋은 최적화입니다. 잘못된 기록을 반환하는 인덱스에 스토리지를 저장하는 것은 별 이득이 아닙니다.
EmbeddingGemma 2 대 Gemini Embedding 2, OpenAI 및 Cohere
이는 상호 교환 가능한 배송 모델이 아닙니다. 첫 번째 결정은 임베딩을 직접 실행할지, 아니면 관리형 서비스를 사용할지 결정하는 경우가 많습니다. 공개 벤치마크는 모든 런타임, 코퍼스 및 양식에 걸쳐 공정한 승자를 설정하지 않습니다.
Gemini Embedding 2: 관리형 다중 모드 검색
Gemini Embedding 2는 Google의 호스팅 다중 모드 임베딩 옵션입니다. 현재 API 가이드는 텍스트, 이미지, 오디오, 비디오 및 PDF를 지원하며 기본 출력은 3,072차원이고 구성 가능한 더 작은 출력도 있습니다. Google의 Gemini 내장 문서는 API 동작에 대한 참조입니다.
우리의 견해: 관리형 인프라가 최우선인 경우 Gemini를 고려하십시오. 로컬 운영 또는 배포 제어가 핵심인 경우 EmbeddingGemma를 고려하십시오. 절충점은 단순히 "큰 벡터 대 작은 벡터"가 아닙니다. 처리가 이루어지는 위치와 이를 운영하는 사람을 선택하는 것입니다. EmbeddingGemma 2 대 Gemini Embedding 2 비교를 참조하세요.
OpenAI text-embedding-3-large: 텍스트 중심 API
OpenAI text-embedding-3-large는 호스팅된 텍스트 임베딩 모델이며 기본 이미지, 오디오 또는 비디오 임베딩 대체 모델이 아닙니다. OpenAI는 기본 3,072차원 출력과 더 적은 차원을 요청하는 방법을 문서화합니다. 현재 나열된 표준 API 가격은 입력 토큰 백만 개당 0.13달러입니다. 이는 ChatGPT 구독이 아닌 API 사용입니다. OpenAI의 임베딩 가이드 및 API 가격 책정에서 범위를 설명합니다.
잘 준비된 텍스트 코퍼스의 경우 관리형 텍스트 서비스가 더 간단한 선택일 수 있습니다. 기본 미디어 검색 또는 오프라인 인덱싱의 경우 다른 문제를 해결하고 있습니다. OpenAI 비교 페이지는 이러한 기능을 가격과 분리합니다.
Cohere Embed 4: 또 다른 기존 다중 모드 옵션
Cohere 라인업에는 4 삽입 텍스트, 이미지, 혼합 문서 콘텐츠를 처리합니다. 이는 특히 원본 문서에 서면 정보와 시각적 정보가 모두 포함되어 있는 경우 엔터프라이즈 검색에 대한 적절한 비교가 됩니다. Cohere의 현재 임베딩 문서 모델 제품군과 기능을 나열합니다.
모든 "다중 모드" 모델이 동일한 파일을 동일한 방식으로 처리한다고 가정하지 않고 실제 문서 작업량, 배포 요구 사항 및 조달 옵션을 비교합니다. 게시된 사실은 EmbeddingGemma 2 및 Cohere Embed 4를 참조하세요.
이것을 연구 프로젝트로 전환하지 않고 시도하는 방법
사람들이 이미 답하기 어려워하는 질문부터 시작하세요. 하나의 코드 저장소, 시각적 지침 폴더 또는 소규모 녹음 세트 등 제한된 컬렉션을 선택하세요. 성공이 어떤 것인지 알기 전에는 모든 것을 색인화하지 마세요.
시각적 소개를 위해 Google의 AI Edge Gallery 예제에서는 Instant Media Search 및 Video Moments Finder를 보여줍니다. 동일한 AI Edge 발표는 Mac용 실험적인 로컬 회의 동반자를 설명합니다. 또한 ML Kit Android 통합이 곧 이루어질 것이라고 설명합니다. 발표된 향후 통합이 이미 가능하다고 가정하지 마십시오.
개발자를 위해 Transformers 문서는 모델 구성 요소 및 미디어 처리에 대해 설명합니다. 비디오 검색은 샘플링된 프레임을 사용하므로 샘플 사이의 간단한 이벤트를 놓칠 수 있습니다. 컨텍스트는 요청의 입력 전체에서 공유됩니다. 더 긴 녹음 및 문서 컬렉션에는 여전히 합리적인 분할이 필요합니다.
체크리스트에 두 가지 구현 세부 사항을 유지하십시오. 첫째, 모든 입력을 동일하게 처리하는 대신 문서화된 쿼리 및 문서 작업 프롬프트를 따르십시오. 둘째, 지원되는 숫자 정밀도를 사용하십시오. Google의 체크포인트 지침에서는 bfloat16 또는 float32를 권장하고 float16에 대해 경고합니다. 이는 최종 사용자가 내려야 하는 결정이 아니라 파일럿을 구축하는 사람을 위한 세부 정보입니다. 공식 검문소 지침 둘 다 덮으세요.
그런 다음 쉬운 검색 이상의 기능을 테스트해 보세요. 반환되어서는 안 되는 유사 일치 항목, 누락된 정보, 혼합 언어 질문, 사용자가 액세스할 수 없는 파일을 포함합니다. 처음 몇 개의 결과에 올바른 출처가 나타나는지 확인하고, 최종 답변만 판단하기보다는 증거를 조사하십시오.
다른 모델에서 마이그레이션하는 경우 별도의 후보 인덱스를 구축하고 테스트 코퍼스를 다시 포함하는 것이 좋습니다. 일치하는 벡터 길이는 서로 다른 모델 간의 호환성을 설정하지 않습니다. 작업 인덱스를 교체하기 전에 동일한 소스 컬렉션에 있는 두 시스템을 비교하세요.
요점: 보편적인 대체 도구가 아닌 더 넓은 검색 도구 키트
EmbeddingGemma 2는 유용한 지식이 미디어 전반에 걸쳐 확산되고 로컬 처리의 목적이 명확한 경우에 가장 흥미롭습니다. 개방형 가중치 검색 계층이 검색할 수 있는 범위를 확장하는 동시에 애플리케이션이 필요한 인코더만 로드할 수 있도록 합니다.
우리의 권장 사항은 이를 집중적인 파일럿으로 취급하는 것입니다. 즉, 올바른 증거를 찾았는지 증명하고, 데이터 경로를 확인하고, 실제 장치 비용을 측정하는 것입니다. 이러한 문제가 해결되면 모델 크기와 벡터 설정이 유용한 엔지니어링 선택이 됩니다. 그렇지 않다면 강력한 벤치마크 헤드라인만으로는 전환할 이유가 충분하지 않습니다.
내장 모델 라이브러리에서 대안을 찾아보거나 EmbeddingGemma 2 프로필를 사용하여 소스, 배포 참고 사항 및 집중 비교를 확인하세요. 이는 Cody가 EmbeddingGemma 추론을 제공한다는 발표가 아니라 Google 릴리스에 대한 교육적 리뷰입니다.
자주 묻는 질문
EmbeddingGemma 2는 챗봇인가요?
아니요. 소프트웨어가 검색, 유사성, 분류 또는 클러스터링에 사용하는 임베딩 벡터를 생성합니다. 애플리케이션이 답변을 작성해야 하는 경우 별도의 생성 모델이 필요합니다.
EmbeddingGemma 2는 무료인가요?
Google은 Apache 2.0 아래의 가중치를 해제합니다. 그렇다고 해서 컴퓨팅, 스토리지 또는 호스팅이 무료가 되는 것은 아닙니다. 릴리스 문서에는 단일 고정 호스팅 API 토큰 비율이 없습니다.
EmbeddingGemma 1에서 변경된 사항은 무엇입니까?
버전 2는 텍스트 및 코드와 함께 기본 이미지, 오디오 및 비디오 검색을 추가하고 컨텍스트 예산을 확장하며 모듈식 인코더를 제공합니다. Google의 평가에서는 더 강력한 코드 결과와 거의 변하지 않은 다국어 텍스트 성능을 보여줍니다.
EmbeddingGemma 2를 오프라인으로 실행할 수 있나요?
로컬 추론은 필요한 소프트웨어, 가중치 및 인덱싱된 콘텐츠가 장치에 있으면 오프라인 검색을 지원할 수 있습니다. 전체 애플리케이션은 다른 구성 요소에 원격 서비스가 필요하지 않은 경우에만 오프라인 상태입니다.
EmbeddingGemma 2가 Gemini Embedding 2보다 낫나요?
여기에는 보편적인 승자가 없습니다. EmbeddingGemma 2는 로컬 또는 자체 호스팅 배포를 위한 개방형 가중치를 제공하는 반면, Gemini Embedding 2는 관리형 API입니다. 자체 데이터에 대한 검색 품질, 미디어 지원, 비용 및 배포 요구 사항을 비교하십시오.
문서 파서나 벡터 데이터베이스를 대체합니까?
아니요. 검색할 콘텐츠를 나타냅니다. 구문 분석, 청크, 소스 권한, 벡터 인덱싱 및 응답 생성은 RAG 시스템에서 별도의 책임으로 유지됩니다.