- AIツール
- 人工知能
EmbeddingGemma 2 の説明: マルチモーダル検索と RAG
Google の EmbeddingGemma 2 は、テキスト、コード、画像、音声、ビデオをローカル検索に組み込みます。ここでは、変更点、RAG のどこに当てはまるか、切り替える前に何をテストする必要があるかを示します。
プロジェクト フォルダーで「オンボーディング プロセスを説明する図」を検索することを想像してください。答えは、きちんとタイトルが付けられた文書ではなく、スライド、スクリーンショット、または録画されたワークショップの瞬間の中にあるかもしれません。テキストのみの検索システムでは、その資料を見つける前に、その資料を抽出または説明する必要があります。
EmbeddingGemma 2 は、検索問題に対する Google の新しいオープンウェイト モデルです。 2026 年 10 月 6 日にリリースされ、独自のハードウェアでの実行に重点を置き、共有検索スペース内のテキスト、コード、画像、オーディオ、およびビデオを表現します。これは検索コンポーネントであり、別のチャットボットではありません。Google の発売発表は、ローカルでマルチモーダルな方向性を打ち出します。
私たちの見解: 興味深いのは、すべての企業が現在のエンベディングを置き換えるべきではないということです。それは、プライベート メディア検索とローカル AI アシスタントに、別の実用的な構成要素が追加されたということです。システムを改善するかどうかは、何を取得する必要があるか、どこで実行する必要があるか、およびどれだけのエンジニアリングを所有したいかによって決まります。
仕様と比較リンクについては、EmbeddingGemma 2 モデル プロファイルを参照してください。ここでは、何が変更されたのか、RAG のどこに当てはまるのか、モデル用語に迷わずにそれを評価する方法について説明します。
EmbeddingGemma 2 を簡単に英語で言うと何ですか?
埋め込みはコンテンツの数値表現です。検索ソフトウェアはこれらの表現を比較して、たとえ表現が異なっていても、意味のある関連性のある項目を見つけます。あなたはベクトルを読みません。実際に読みたい、見たい、聞きたいものを見つけるために使用します。
EmbeddingGemma 2 はそのアイデアをメディア全体に拡張します。言葉で入力された質問は、単なるテキストの一節ではなく、画像や録音につながる可能性があります。その公式 Google チェックポイントには、テキスト コンポーネントとオプションのビジョンおよびオーディオ エンコーダが含まれています。常に完全なマルチモーダル設定を実行するのではなく、アプリケーションに必要な部分をロードできます。
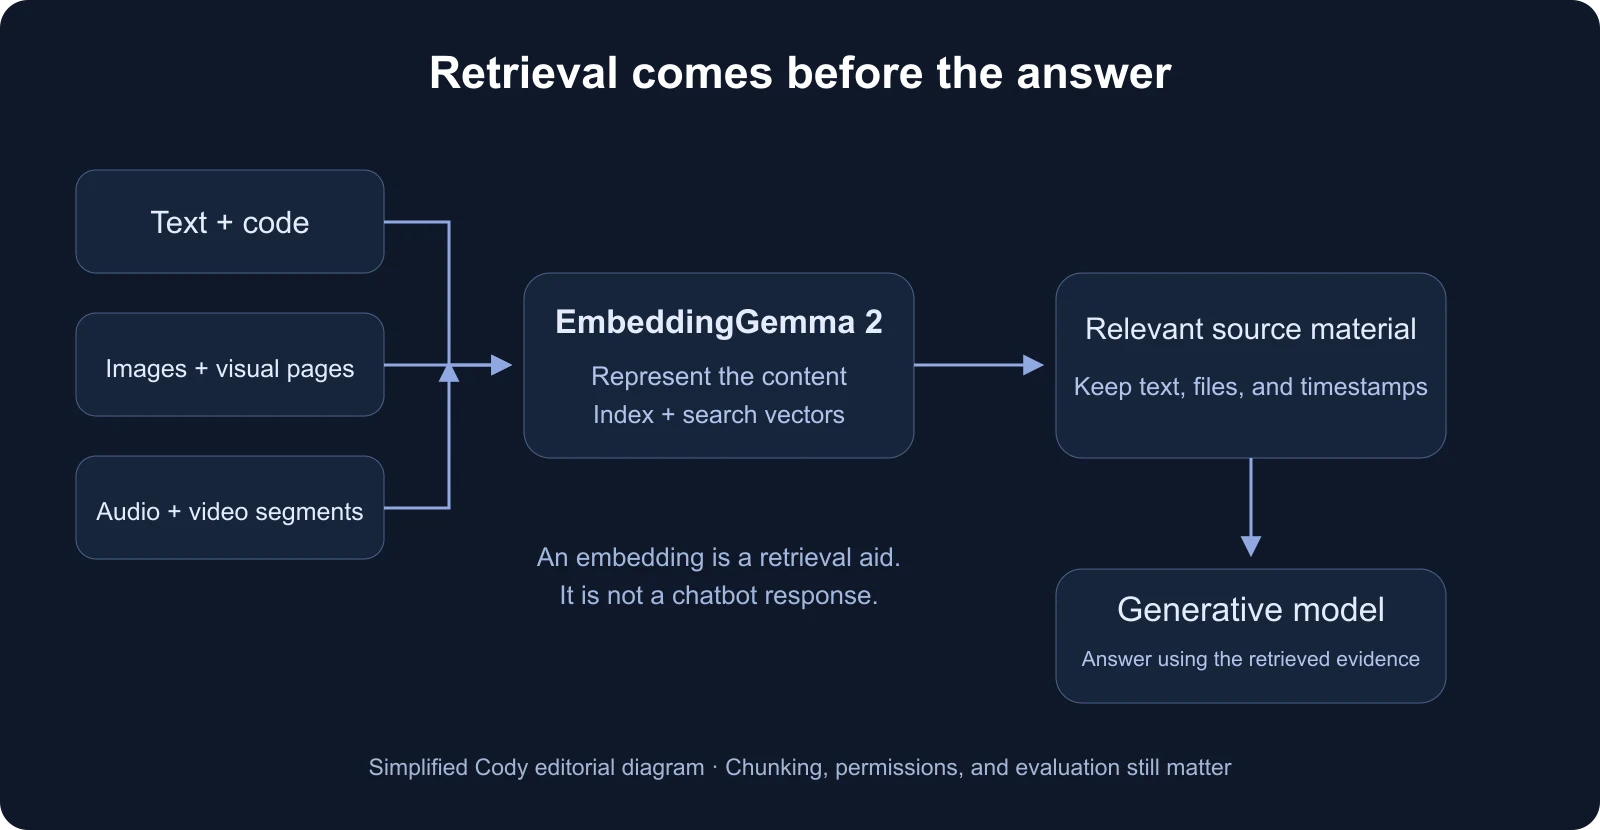
著者ではなく、図書館員として考えてください。有用な情報源を特定するのに役立ちます。その後、別の生成モデルがその資料を回答に変えることができますが、アプリケーションは依然としてアクセス許可、引用、および元のファイルを処理する必要があります。
その分離が重要です。チャットボットの説得力のある回答は、脆弱な検索システムを隠す可能性があります。検索を改善すると、応答モデルにより良い証拠が与えられます。すべての答えが自動的に正解になるわけではありません。
EmbeddingGemma 2 と EmbeddingGemma 1: 何が変わったのでしょうか?
オリジナルの EmbeddingGemma は、ローカルでの使用を目的として設計されたコンパクトな多言語テキスト埋め込みモデルでした。バージョン 2 は、Google のオンデバイス検索ストーリーの始まりではありません。主な拡張はメディアのサポートと、より強力なコード検索結果です。 Google のバージョンの概要は 2 つの世代を区別します。
| 何が重要か | EmbeddingGemma 1 | EmbeddingGemma 2 |
|---|---|---|
| 主な入力 | テキスト | テキスト、コード、画像、オーディオ、ビデオ |
| 建築 | Gemma 3ベース | Gemma 4ベース |
| 掲載サイズ | 3億8000万パラメータ | テキスト/コードの場合は 270M。 740M(すべてのエンコーダーを含む) |
| コンテキストの予算 | 2,048トークン | テキストとメディア間で共有される 8,192 個のトークン |
| ベクトルサイズ | 768、サポートされるサイズが小さい | 768、512、256、または 128 次元 |
| ウエイトライセンス | ジェンマ用語 | Apache 2.0 |
バージョン 2 の仕様とライセンスは、Google のモデル カードに文書化されています。小さいテキストのみの構成は注目に値します。メディア機能を追加しても、すべてのアプリケーションが完全なモデルを実装する必要があるわけではありません。
既存のテキスト ナレッジ ベースの場合、これは評価の理由であり、自動移行順序ではありません。バージョン 1 がすでに適切なパッセージを確実に見つけている場合は、新しい画像エンコーダーとオーディオ エンコーダーで、まだ解決されていない問題が解決される可能性があります。コード、視覚的な指示、または録音を検索しているチームには、バージョン 2 を試す明確な理由があります。
RAG と個人的な知識が重要な理由
検索拡張生成 (RAG) とは、AI モデルに回答を求める前に、関連するソース資料を見つけることを意味します。その最初のステップの質が、その後のすべてを形作ります。
身近な例としては、社内サポートアシスタントが挙げられます。書面によるトラブルシューティングのメモで障害が説明される場合もありますが、技術者は正しいコネクタを示す注釈付きの写真も必要になる場合があります。マルチモーダル検索レイヤーは、これらの部分をまとめるのに役立つ可能性があります。これは仮説的な使用例であり、このモデルが安全性を重視したサポート評価に合格したという主張ではありません。
まず、次の 3 種類のパイロットを検討します。
- プライベート メディア ライブラリ:は、役立つスクリーンショット、製品の写真、または通常の言語による視覚的な説明を検索します。
- ローカルの開発者アシスタント: リポジトリ全体を埋め込みサービスに送信せずに、関連するコードを取得します。
- 検索可能な録画アーカイブ:は、録画全体を流し読みするのではなく、関連するセグメントとそのタイムスタンプを返します。
いずれの場合も、検索では証拠を突き止める必要があります。ファイル参照、ドキュメント セクション、アクセス スコープ、およびメディア タイムスタンプをベクトルと一緒に保持します。ユーザーがそれを開けなかったり、結果が返された理由を理解できなかったりする場合、見た目が似ているだけでは十分ではありません。
また、書類の準備に代わるものでもありません。ビジュアル ページを見つけることと、スプレッドシート品質のテーブルを抽出することは別の仕事です。 PDF の読み取り順序が壊れている、見出しが欠落している、または信頼性の低いテーブル抽出が問題である場合は、取り込みレイヤーから始めてください。私たちの ドッキングガイド そして Cohere Parseの説明者 パイプラインのその側をカバーします。
Google のベンチマークが実際に示していること
公表された結果は、「すべてにおいて優れている」というよりも、より具体的なストーリーを伝えています。 Google のモデル カードの完全精度 768 次元評価では、多言語 MTEB スコアは 61.15 から 61.36 に上昇しました。コード MTEB スコアは 68.76 から 78.68 に変化し、その特定の評価では相対的に約 14% 増加しました。これらはGoogle が報告した結果であり、独自のテストではありません。ベンチマーク テーブルには、評価バージョンとメトリックの名前が付けられています。
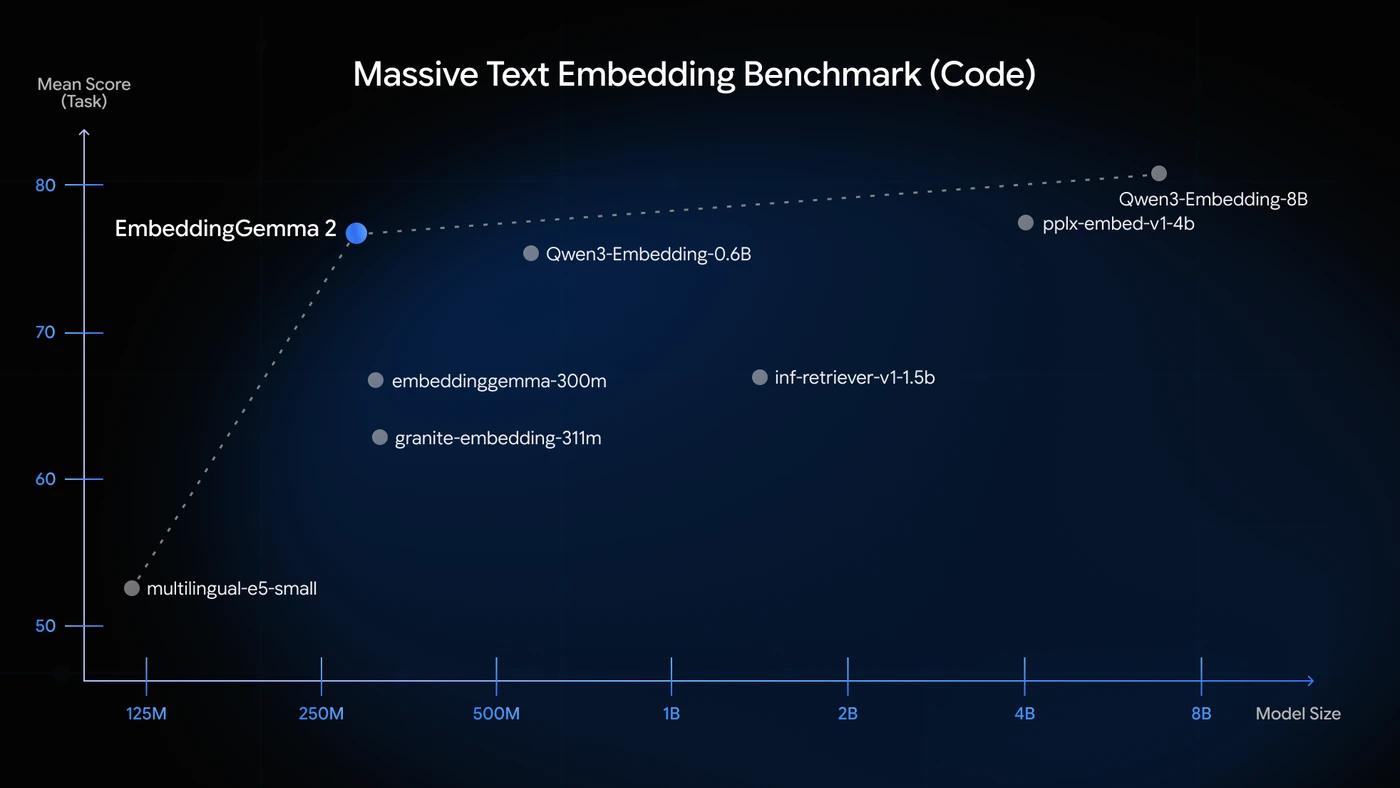
私たちの解釈では、見出しの幅が広がり、コード検索が向上し、多言語テキストのパフォーマンスがほぼ維持されていると考えられます。これは、1 つのベンチマークからのパーセンテージをすべてのビジネス検索クエリに対する約束された改善として扱うよりも便利です。
適切なフォローアップの質問は次のとおりです。取得できるかどうか あなたの 関連情報源は?モデルは、公開タスクでは良いスコアを獲得できますが、略語、珍しい図、混合言語ファイル、または不十分な録音には依然として苦労します。実際の質問と予想される証拠からなる小規模な評価セットは、普遍的な勝者のラベルよりも実用的です。
ローカルとは無料、または自動的にプライベートになることを意味するものではありません
オープンウェイトはコスト構造を変えます。このリリースでは、Google がホストする埋め込み API から固定トークン レートを購入することはありません。コンピューティング、メモリ、インデックス作成時間、デプロイメント、およびメンテナンスについてはお客様が責任を負います。 Apache 2.0 リリースでは、別の展開パスが可能になります。運用コストが削減されるわけではありません。
これは、コンテンツをユーザーの近くに置いておく必要がある場合や、ネットワーク接続なしで動作する必要がある場合に魅力的です。 Googleの AIエッジガイド は、消費者向けデバイスでのローカル メディア検索とビデオ取得を示しています。メモリと遅延の測定は特定のデバイス、構成、ワークロードに関連付けられており、すべてのラップトップや携帯電話を保証するものではありません。
パイロットでは、最初のインデックスの構築にかかる時間、インデックス作成後にクエリが返されるまでの時間、処理中のメモリのピーク、バッテリーへの影響、ファイル変更時の影響など、エクスペリエンス全体を測定します。高速なクエリは、高速な初期インポートと同じではありません。
プライバシーもアプリケーションのプロパティです。ローカル エンベディング推論により、リモート エンベディング API からソース マテリアルを守ることができます。ただし、クラウド バックアップ、テレメトリ、リモート ベクトル データベース、またはホストされた応答モデルによって、データが別の場所に移動される可能性があります。システムを「完全にローカル」と呼ぶ前に、完全なデータ パスをマッピングします。
同様に、ベクターはアクセス制御システムではありません。ソースのアクセス許可を保持し、質問者のために結果をフィルタリングします。プライベート ファイルは、そのベクトルが公開マテリアルとインデックスを共有しているという理由だけで検出可能になるべきではありません。
より小さいベクトル: 実際のトレードオフを伴う有益な節約
このモデルは、Matryoshka Representation Learning と呼ばれる手法である埋め込みの短縮をサポートしています。 Google の開発者ガイドでは、サポートされるサイズと、切り捨て後にベクトルを再度正規化する必要性について説明しています。
実際的なアイデアは単純です。項目ごとに保存する数値を少なくすると、大きなインデックスを小さくすることができます。数値形式が同じであれば、ベクトルを 768 次元から 128 次元に削減すると、生のベクトルのペイロードが 6 倍に削減されます。アプリケーションやデータベース全体が 6 倍安くなるわけではありません。元のファイル、メタデータ、検索インデックスのオーバーヘッドはまだ存在します。
また、最小の設定でも無料で品質をアップグレードできるわけではありません。 Google の結果では、256 次元や 512 次元よりも 128 次元の方がマルチモーダルな低下が顕著であることが示されています。ネイティブ サイズでメディア検索のパイロットを開始し、検索ベースラインを確立してから、同じ質問に対して小さなベクトルをテストします。クエリとインデックス付きアイテムは互換性のあるディメンションを使用する必要があります。
これは、有用性を証明した後に行うのに適した最適化です。間違った記録を返すインデックスのストレージを節約しても、あまり効果はありません。
EmbeddingGemma 2 と Gemini Embedding 2、OpenAI、および Cohere の比較
これらは互換性のある配信モデルではありません。多くの場合、最初に決定するのは、埋め込みを自分で実行するか、マネージド サービスを利用するかです。公開ベンチマークでは、すべてのランタイム、コーパス、およびモダリティにわたって公平な勝者が確立されるわけではありません。
Gemini Embedding 2: 管理されたマルチモーダル取得
Gemini Embedding 2は、Google がホストするマルチモーダル埋め込みオプションです。現在の API ガイドは、テキスト、画像、オーディオ、ビデオ、PDF をサポートしており、デフォルトの出力は 3,072 次元で、さらに小さい出力は構成可能です。Google の Gemini 埋め込みドキュメントは、API の動作のリファレンスです。
私たちの見解: 管理されたインフラストラクチャが優先される場合は、Gemini を検討してください。展開に対するローカル操作または制御が中心である場合は、EmbeddingGemma を検討してください。トレードオフは単に「大きなベクトルと小さなベクトル」だけではありません。処理がどこで行われるか、誰が処理を行うかを選択することになります。EmbeddingGemma 2 と Gemini Embedding 2 の比較を参照してください。
OpenAI text-embedding-3-large: テキスト中心の API
OpenAI text-embedding-3-largeは、ホストされたテキスト埋め込みモデルであり、ネイティブの画像、音声、またはビデオ埋め込みの置き換えではありません。 OpenAI には、デフォルトの 3,072 次元の出力と、より少ない次元を要求する方法が記載されています。現在リストされている API の標準価格は、100 万入力トークンあたり 0.13 ドルです。これは ChatGPT サブスクリプションではなく、API の使用法です。OpenAI の埋め込みガイドおよびAPI の価格設定の範囲について説明します。
十分に準備されたテキスト コーパスの場合、マネージド テキスト サービスがより簡単な選択肢となる可能性があります。ネイティブ メディアの取得やオフライン インデックス作成の場合は、別の問題を解決することになります。OpenAI 比較ページでは、これらの機能を価格とは区別しています。
Cohere Embed 4: 別の既存のマルチモーダル オプション
Cohereのラインナップでは、 埋め込み 4 テキスト、画像、および混合ドキュメント コンテンツを処理します。そのため、特にソース文書に文字情報と視覚情報の両方が含まれている場合、企業の検索に関連した比較となります。 Cohere の現在の埋め込みドキュメント に、そのモデル ファミリと機能を示します。
すべての「マルチモーダル」モデルが同じファイルを同じ方法で処理するとは想定せず、実際のドキュメントのワークロード、導入要件、調達オプションを比較します。公開された事実については、「EmbeddingGemma 2 と Cohere Embed 4」を参照してください。
研究プロジェクトにせずに試す方法
人々がすでに答えるのに苦労している質問から始めましょう。 1 つのコード リポジトリ、ビジュアル指示のフォルダー、または小規模な記録セットなど、制限されたコレクションを選択します。成功とはどのようなものかを知る前に、すべてをインデックス化することは避けてください。
視覚的に説明するには、Google の AI Edge Gallery の例で Instant Media Search と Video Moments Finder を示します。同じ AIエッジの発表 Mac 用の実験的なローカル ミーティング コンパニオンについて説明します。また、ML Kit Android 統合が近々予定されているとも説明されています。発表された将来の統合がすでに利用可能であるとは想定しないでください。
開発者向けには、Transformers ドキュメントでモデル コンポーネントとメディア処理について説明しています。ビデオの取得ではサンプリングされたフレームが使用されるため、サンプル間の短いイベントが見逃される可能性があります。コンテキストはリクエスト内の入力全体で共有されます。より長い録音やドキュメントのコレクションには、依然として賢明なセグメント化が必要です。
2 つの実装の詳細をチェックリストに記録します。まず、すべての入力を同じように扱うのではなく、文書化されたクエリと文書化されたタスクのプロンプトに従います。次に、サポートされている数値精度を使用します。Google のチェックポイント ガイダンスでは bfloat16 または float32 を推奨し、float16 に対して警告しています。これらはパイロットを構築する人のための詳細であり、エンド ユーザーが決定する必要があるものではありません。公式チェックポイント命令は両方をカバーしています。
次に、簡単な検索以外にもテストを行ってください。返すべきではないほぼ一致したもの、欠落している情報、混合言語の質問、およびユーザーがアクセスを許可されていないファイルが含まれます。最初のいくつかの結果に正しい情報源が含まれているかどうかを確認し、最終的な答えだけを判断するのではなく、証拠を調べてください。
別のモデルから移行する場合は、別の候補インデックスを構築し、テスト コーパスを再埋め込むことをお勧めします。ベクトルの長さを一致させても、異なるモデル間の互換性は確立されません。作業インデックスを置き換える前に、同じソース コレクション上の 2 つのシステムを比較してください。
要点: 汎用的な代替品ではなく、より幅広い検索ツールキット
EmbeddingGemma 2 は、有用な知識がメディア全体に広がり、ローカル処理に明確な目的がある場合に最も興味深いです。これにより、アプリケーションが必要なエンコーダーのみをロードできるようにしながら、オープンウェイト検索レイヤーが検索できる内容が拡張されます。
私たちの推奨事項は、これを集中的なパイロットとして扱うことです。つまり、適切な証拠が見つかることを証明し、データ パスを検証し、実際のデバイスのコストを測定します。これらの問題が解決される場合、モデル サイズとベクトル設定は有用なエンジニアリング上の選択肢になります。そうでない場合は、ベンチマークの見出しが強力であっても、切り替える理由としては十分ではありません。
代替案については埋め込みモデル ライブラリを参照するか、EmbeddingGemma 2 プロファイルを使用してそのソース、展開ノート、および重点比較を行ってください。これは Google のリリースの教育的なレビューであり、Cody が EmbeddingGemma 推論を提供するという発表ではありません。
よくある質問
EmbeddingGemma 2 はチャットボットですか?
いいえ。ソフトウェアが検索、類似性、分類、またはクラスタリングに使用する埋め込みベクトルを生成します。アプリケーションが応答を記述する必要がある場合は、別の生成モデルが必要です。
EmbeddingGemma 2は無料ですか?
Google は Apache 2.0 の下で重みをリリースします。だからといって、コンピューティング、ストレージ、ホスティングが無料になるわけではありません。リリース ドキュメントには、単一の固定ホスト API トークン レートはありません。
EmbeddingGemma 1 から何が変わりましたか?
バージョン 2 では、テキストやコードに加えてネイティブ画像、オーディオ、ビデオの取得が追加され、コンテキスト バジェットが拡張され、モジュラー エンコーダが提供されます。 Google の評価では、より強力なコード結果と、ほぼ変わらない多言語テキストのパフォーマンスが示されています。
EmbeddingGemma 2 はオフラインでも実行できますか?
必要なソフトウェア、重み、インデックス付きコンテンツがデバイス上にあれば、ローカル推論はオフライン検索をサポートできます。アプリケーション全体は、他のコンポーネントがリモート サービスを必要としない場合にのみオフラインになります。
EmbeddingGemma 2 は Gemini Embedding 2 より優れていますか?
ここでは普遍的な勝者が確立されていません。 EmbeddingGemma 2 はローカルまたはセルフホスト展開にオープン ウェイトを提供しますが、Gemini Embedding 2 はマネージド API です。独自のデータの取得品質、メディア サポート、コスト、展開要件を比較します。
ドキュメント パーサーやベクトル データベースに代わるものですか?
いいえ。検索用のコンテンツを表します。 RAG システムでは、解析、チャンク化、ソースのアクセス許可、ベクトルのインデックス付け、および回答の生成は引き続き個別の責任となります。