

- herramientas de inteligencia artificial
- Inteligencia artificial
¿Qué es Jev? Explicación del Modelo System One de TypeSafe AI
Jev es un nuevo tipo de modelo de IA diseñado para devolver decisiones rápidas y escritas en lugar de prosa. Aquí se explica cómo funciona System One, cuánto cuesta, dónde encaja y qué demuestra —y no demuestra— su evidencia inicial.
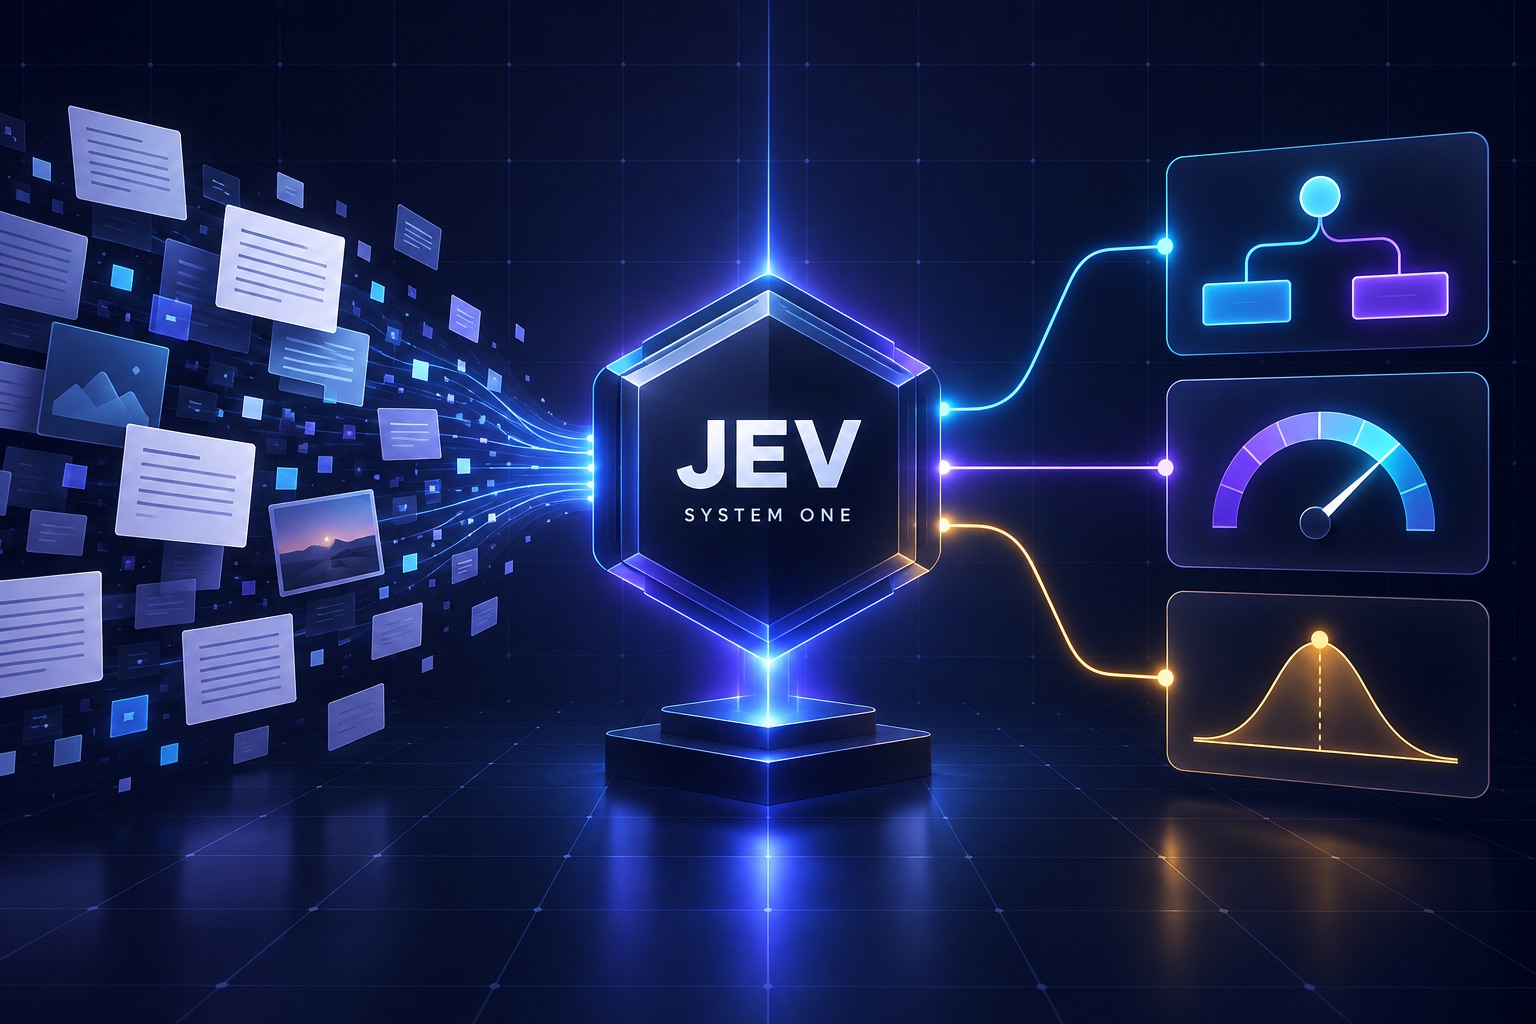
La mayoría de los modelos de IA están diseñados para decir algo. Jev está diseñado para decidir algo y devolver la respuesta en una forma que el software pueda usar de inmediato.
Llega un mensaje de un cliente. ¿Es de facturación, soporte o ventas? Un pasaje recuperado parece relevante. ¿Es lo suficientemente fuerte como para enviarlo al modelo de respuestas? Un agente propone una acción. ¿Debe el flujo de trabajo permitirla, bloquearla o preguntar a una persona?
Estos no son realmente tareas de escritura. Son pequeños juicios escondidos dentro del software. Los equipos a menudo se los dan a un modelo de lenguaje de propósito general porque esa es la herramienta de IA que ya tienen. El modelo lee la entrada, genera una respuesta un token a la vez, y la aplicación vuelve a analizar la respuesta en una etiqueta, puntuación o booleano.
TypeSafe AI presentó Jev el 15 de septiembre de 2026 como un tipo diferente de modelo. La empresa llama a la categoría Modelos System One: un estado no estructurado entra, mientras que salen elecciones limitadas, puntuaciones, probabilidades y confianza. Jev no conversa, explica ni escribe código. Toma decisiones semánticas específicas.
Eso suena como una distinción pequeña. Podría ser importante. Si las afirmaciones tempranas de velocidad, costo y calibración de Jev resisten pruebas más amplias, las aplicaciones podrían dejar de usar un modelo de lenguaje grande para cada pequeña rama en un flujo de trabajo. El resultado no reemplazaría un LLM. Proporcionaría al LLM—y al resto del software a su alrededor—una capa de decisión más rápida.
Esta guía explica qué es Jev, qué significa “System One”, cómo funcionan sus preguntas de Elección, Puntuación y Noul, cuánto cuesta, qué muestran las evidencias de referencia y dónde importan sus limitaciones. Para las especificaciones compactas y fuentes de primera mano, vea la página del modelo Jev 1.13 o explore la nueva Categoría de modelos de decisión de IA.
Respuesta rápida — verificado el 17 de septiembre de 2026
Jev 1.13 es el primer modelo System One de TypeSafe AI. Acepta texto, JSON o matrices de texto más preguntas predefinidas, luego devuelve decisiones tipadas con probabilidades. TypeSafe lo lista en 0,042 USD por millón de tokens de entrada con salida gratuita e informes que muestran la latencia típica de extremo a extremo de 70–500 milliseconds para tareas adecuadas. Está en acceso anticipado. Esas son cifras publicadas por el proveedor, no garantías universales.
| Jev fact | Detalle actual |
|---|---|
| Desarrollador | TypeSafe AI |
| Modelo actual | Jev 1.13; API ID jev-1.13.0 |
| Lanzamiento | 15 de septiembre de 2026 |
| Qué devuelve | Opciones, puntuaciones ordinales, probabilidades y señales de confianza |
| Qué no devuelve | Prosa abierta, explicaciones, código, imágenes, audio o video |
| Capacidad de entrada | 64K tokens por solicitud; estado más la pregunta más larga hasta 32K |
| Precio | $0.042 por millón de tokens de entrada; la salida es gratuita |
| Velocidad publicada | 70–500 ms de extremo a extremo para consultas en forma de System One |
| Acceso | Playground de acceso anticipado y API con SDKs de Python y JavaScript |
¿Qué es la IA Jev?
Jev es un modelo especializado para hacer juicios acotados sobre texto o estados estructurados. En lugar de indicarle que "escriba un objeto JSON" y esperar que la respuesta generada siga el formato, un desarrollador define la posible respuesta antes de la inferencia. Jev luego devuelve uno de esos valores permitidos, o una puntuación o probabilidad, junto con información sobre la incertidumbre.
El modelo mental más sencillo es un clasificador muy capaz que puede entender el lenguaje natural, considerar muchas preguntas a la vez y mostrar cuán seguro está. Esa descripción es más útil que tratar Jev como un pequeño chatbot. Está diseñado para estar dentro de una aplicación, no para ser la aplicación.
El patrón Jev
Estado no estructurado → Jev → Elección + puntuación + probabilidad → código de aplicación
El modelo maneja el juicio semántico. El código aún controla la regla, el umbral, el efecto secundario, el registro de auditoría y la alternativa.
Supongamos que un sistema de soporte recibe: "Actualicé ayer, pero me cobraron la tarjeta dos veces y el pago extra sigue sin desaparecer." Una solicitud de Jev podría preguntar si el mensaje se refiere a la facturación, cuán urgente parece, si debe escalarse y qué probabilidad hay de que contenga información sensible de la cuenta. Cada pregunta tiene una forma de salida declarada. La aplicación puede enrutar el ticket sin analizar ni un párrafo.
El alias actual jev-latest resuelve jev-1.13.0. La mayoría de los lectores no necesitan memorizar ese ID; es importante principalmente para pruebas de producción reproducibles. La idea más amplia es el producto: Jev es el primer miembro de una categoría que TypeSafe espera que maneje las muchas pequeñas decisiones relacionadas con los agentes, la búsqueda, la moderación, las operaciones y los flujos de trabajo del cliente.
¿Por qué llamarlo modelo "System One"?
El nombre se toma del marco de los Sistemas 1 y 2 popularizado por el psicólogo Daniel Kahneman. El Sistema 1 describe juicios rápidos e intuitivos; el Sistema 2 describe razonamientos más lentos y deliberados. La analogía no es una afirmación de que Jev piense como una persona. Describe la tarea para la que el modelo está optimizado.
Un LLM de frontera como GPT-6 Astra o Claude Fable 5.1 está construido para un trabajo amplio y generativo: investigar un problema, usar herramientas, escribir código, explicar compensaciones o producir un documento. Jev es intencionalmente más estrecho. Lee el estado disponible y devuelve una pequeña decisión rápidamente.
TypeSafe dice que la arquitectura usa un muestreador paralelo en lugar de generar una respuesta token por token. Su documentación también dice que las preguntas en la misma solicitud se evalúan de manera independiente y en paralelo. Eso significa que agregar varias preguntas de clasificación o puntuación debería tener una penalización de latencia mucho menor que pedir a un LLM general que las procese de manera secuencial.
La empresa entrenó a Jev usando RLCD, abreviado como Reinforcement Learning for Calibrated Decisions. El objetivo importante para el usuario es la calibración: a lo largo de muchas predicciones similares, una probabilidad del 80% debería ser correcta aproximadamente el 80% del tiempo. La calibración no garantiza que una respuesta individual sea correcta. Hace que la incertidumbre sea más útil para el enrutamiento y los umbrales.
Elección, Puntuación y Noul: los tres tipos de preguntas de Jev
Jev actualmente expone tres primitivas. Juntas cubren una gran parte de los pequeños juicios ocultos dentro del software empresarial.
La elección selecciona de un conjunto permitido
Una pregunta de elección da a Jev una lista fija de etiquetas: facturación, soporte técnico, ventas, cancelación o algo más. La respuesta incluye la etiqueta seleccionada, la distribución de probabilidad entre las opciones disponibles y un valor de confianza derivado de esa distribución.
Esto se aplica a la clasificación de intención, enrutamiento de colas, selección de políticas, etiquetado de contenido y decidir qué herramienta o agente debe recibir una tarea. Los documentos TypeSafe admiten hasta 255 opciones. Para conjuntos de etiquetas muy grandes, su propia orientación es reducir el campo y luego tomar una segunda decisión en lugar de tratar cientos de opciones casi duplicadas como un solo problema plano.
La puntuación coloca un elemento en una escala ordenada
Una pregunta de Puntuación define un rango ordenado — por ejemplo, urgencia de uno a cinco o calidad del liderazgo de cero a diez. Jev devuelve una puntuación junto con la distribución sobre los valores permitidos y una señal de confianza.
Las puntuaciones son útiles cuando la diferencia entre resultados adyacentes importa. Una puntuación de riesgo de cuatro está más cerca de cinco que de uno; un conjunto simple de etiquetas no relacionadas no expresa ese orden. Las aplicaciones pueden convertir el resultado en niveles de servicio, colas de revisión, umbrales o priorización.
Noul estima la probabilidad de una afirmación.
Una pregunta Noul solicita un valor entre cero y uno: qué tan probable es que este pasaje responda a la consulta, qué tan probable es que la solicitud viole una regla o qué tan probable es que este rastro de agente indique un fallo. Noul devuelve la probabilidad directamente. A diferencia de Choice y Score, la respuesta actual de Noul no agrega una propiedad de confianza separada.
El nombre extraño es menos importante que el patrón. En lugar de obligar a un modelo a decir “sí” o “no” en un límite arbitrario, la aplicación recibe una probabilidad y elige el límite por sí misma. Una decisión de personalización inofensiva podría aceptar 0,65. Una acción de pago o de seguridad de alto riesgo podría requerir 0,98 y una segunda verificación.
¿Realmente Jev tiene “cero alucinaciones”?
TypeSafe utiliza un lenguaje fuerte en torno a la alucinación porque Jev no puede inventar una cuarta categoría cuando el esquema permite solo tres, devolver un párrafo donde el código espera un número, o improvisar un campo no reconocido. Esa es una mejora significativa en la fiabilidad. El forma de la respuesta está limitada.
No significa que el juicio sea siempre verdadero. Jev aún puede elegir la etiqueta incorrecta, asignar una puntuación demasiado alta, malinterpretar una instrucción indirecta o volverse menos confiable cuando la entrada es adversaria o está llena de material irrelevante. El propio TypeSafe Guía de irregularidades Jev 1.13 documenta esas debilidades.
Una manera precisa de decirlo es:
- La alucinación del esquema está limitada. La salida debe ajustarse al tipo de decisión declarado.
- El error semántico sigue siendo posible. Una etiqueta válida aún puede ser la etiqueta incorrecta.
- La confianza ayuda a gestionar el error. Puede desencadenar una revisión o una alternativa, pero no es prueba.
Esta distinción importa para cada sistema de IA estructurado. El modo JSON en un LLM general puede garantizar campos analizables mientras que los valores dentro de esos campos siguen siendo incorrectos. Jev reduce aún más el problema al especializar todo el modelo en torno a decisiones limitadas, pero los equipos de producción todavía necesitan evaluaciones y umbrales seguros.
¿Qué tan rápido y económico es Jev?
La página actual del modelo de TypeSafe lista Jev 1.13 en $42 por mil millones de tokens de entrada, equivalente a $0.042 por cada millón de tokens de entrada. La salida es gratuita porque Jev no está generando una respuesta larga. A ese ritmo, un millón de solicitudes de clasificación de 500 tokens utilizarían 500 millones de tokens de entrada y tendrían un costo de lista de modelo de aproximadamente $21, antes de cualquier gasto en aplicación, almacenamiento, red o revisión humana.
El post de lanzamiento informa 70 a 500 milisegundos de extremo a extremo para tareas diseñadas para System One, y afirma velocidades 40× a 200× mayores en comparación con los modelos generales utilizados en sus comparaciones. Esos números necesitan el contexto que TypeSafe proporciona:
- la mayoría de las pruebas de tiempo se realizaron desde laptops en la Costa Oeste de EE. UU.;
- las cuatro evaluaciones de flujo de trabajo fueron diseñadas por el equipo de TypeSafe;
- las etiquetas de comparación se derivaron de las respuestas de alto pensamiento GPT-6 Astra y Claude Fable 5.1 en lugar de etiquetas de referencia humanas independientes; y
- La empresa dice que los precios iniciales pueden estar subvencionados y no deben considerarse permanentes.
En otras palabras, la evidencia del lanzamiento es prometedora, no concluyente. El titular máximo—193,6× más rápido y 444,6× más barato—es el extremo favorable de un conjunto de tareas realizadas por el proveedor, no un factor de conversión universal para cada llamada LLM.
Lo que las primeras evaluaciones de Jev realmente muestran
TypeSafe publica cuatro evaluaciones de flujo de trabajo que cubren la clasificación de incidentes de seguridad, la observabilidad del rastreo de agentes, el procesamiento de facturas y las decisiones de servicio al cliente. Cada flujo de trabajo descompone un amplio aviso en varias preguntas tipadas, y luego compara la exactitud, el costo y el tiempo con una línea base de modelo general.
El resultado central se trata menos de una tabla de posiciones que de un patrón de flujo de trabajo. Si una tarea termina en un puñado de etiquetas o números, un modelo especializado puede evitar pagar a un LLM general para componer y serializar una respuesta que nunca necesitó escribir. Las preguntas paralelas también pueden reemplazar varias llamadas separadas.
Hay una pieza útil de evidencia externa. El ingeniero Malte Ubl escribió que ejecutó Jev contra una evaluación de clasificador existente que había usado Gemini 2.5 Flash-Lite; en esa prueba, Jev saturó la evaluación de calidad y se ejecutó aproximadamente seis veces más rápido. Ese informe es alentador porque la evaluación precedió a Jev, pero sigue siendo la prueba de un solo desarrollador, no un conjunto amplio de benchmarks independientes.
Para una explicación visual rápida, Matija Sosic publicó un Resumen de Jev de 45 segundos. Steve Krouse también compartió un demostración en vivo pequeña que hace que el patrón de estado y preguntas sea más fácil de percibir que una tabla de benchmarks.
La evidencia es suficiente para justificar la prueba de Jev. Aún no es suficiente para declarar que Jev supera a todos los pequeños LLM, clasificadores, rerankers o motores de reglas. Una evaluación justa debe usar ejemplos congelados del producto real, etiquetas revisadas por humanos, la misma ruta de red y una política de umbral elegida antes de ver los resultados.
Jev vs LLMs: ¿qué es realmente diferente?
| Dimensión | Jev / System One | LLM de propósito general |
|---|---|---|
| Trabajo principal | Elegir, puntuar o estimar probabilidad | Generar, razonar, explicar, programar y usar herramientas |
| Salida | Valores tipados predefinidos | Tokens abiertos, opcionalmente restringidos a JSON |
| Incertidumbre | Distribuciones de probabilidad nativas y confianza donde se admite | Generalmente no se expone como una señal de aplicación calibrada |
| Múltiples preguntas | Preguntas independientes evaluadas en paralelo | A menudo respondidas en una secuencia generada o en varias llamadas |
| Mejor en | Decisiones semánticas estrechas y de alto volumen | Trabajo ambiguo, creativo, de varios pasos o explicativo |
| No puede | Escribir prosa, código o explicaciones | Puede generar los tres |
La comparación correcta, por lo tanto, no es “¿Puede Jev vencer a un modelo de vanguardia?” Es “¿Por qué estamos pidiendo a un modelo de vanguardia que haga este trabajo en particular?” A pequeño modelo general como GPT-5.6 Luna o Claude Haiku 4.5 permanece más flexible. Puede extraer un campo, reescribir un mensaje, llamar a una herramienta y explicar su respuesta en la misma solicitud. Jev renuncia a esa flexibilidad a cambio de un contrato más estricto.
Jev vs salida estructurada o modo JSON
La salida estructurada es la alternativa familiar más cercana. Un desarrollador le da a un LLM un esquema; el proveedor limita la respuesta generada para que pueda ser analizada. Esto es excelente cuando una aplicación necesita un objeto rico con nombres, descripciones, fechas u otros campos generados.
Jev se adapta mejor a un espacio de salida más pequeño. Las respuestas ya existen; el modelo solo las selecciona o califica. Hay menos salida que generar, la distribución de probabilidad es parte del producto, y toda la arquitectura está optimizada en torno a la decisión. Use el modo JSON cuando necesite contenido generado dentro de una estructura. Considere Jev cuando cada respuesta válida ya se conoce.
Jev vs un clasificador tradicional
Un clasificador convencional puede ser extremadamente rápido y económico después del entrenamiento. Puede ser la mejor opción para un problema estable y de alto volumen con suficientes datos etiquetados. El atractivo de Jev es que intenta aportar la flexibilidad del lenguaje natural y la configuración de pocos ejemplos a esa clase de trabajo sin pedirle a cada equipo que entrene y opere un modelo separado.
La compensación es el control. Un clasificador personalizado se puede ajustar alrededor de una taxonomía estrecha, inspeccionarse con métricas conocidas y desplegarse en un entorno privado. Jev es actualmente un servicio alojado en acceso anticipado. Los equipos deben comparar no solo la precisión y la latencia, sino también la ubicación de los datos, las necesidades de reentrenamiento, la rotación de etiquetas y el esfuerzo operativo.
Jev vs un reranker
Un reranker como Cohere Rerank 4 Fast toma una consulta y documentos candidatos, luego ordena esos candidatos por relevancia. Jev puede preguntar si un pasaje responde a una pregunta o calificar un pasaje según una rúbrica, pero no es automáticamente un modelo de reordenamiento con el mismo objetivo de entrenamiento y contrato específico de búsqueda.
Para RAG, las herramientas pueden complementarse entre sí. La recuperación encuentra candidatos, un reordenador los organiza, y Jev puede tomar una decisión limitada como “¿Es suficiente la evidencia principal para responder?” o “¿Qué tema de política respalda este pasaje?” Un modelo más grande luego escribe la respuesta citada solo cuando la capa de decisión indica que la evidencia es adecuada.
Dónde Jev podría ser útil
1. Enrutamiento de solicitudes y trabajo de agentes
Jev puede clasificar una solicitud entrante, seleccionar un agente especialista, evaluar la urgencia y decidir si una persona debe revisarla. Debido a que cada salida está limitada, el orquestador no necesita interpretar una respuesta narrativa antes de dar el siguiente paso.
2. Agregar filtros de confianza a los agentes de IA
Un agente puede proponer una acción mientras Jev juzga por separado si la acción coincide con el objetivo del usuario, se encuentra dentro de la política o parece completa. Los casos de baja confianza pueden pausarse. Esto no es un límite de seguridad completo: el modelo aún puede ser influenciado por entradas adversariales, pero puede añadir una verificación semántica rápida antes de que el código haga cumplir la regla final.
3. Mejorando RAG y la búsqueda empresarial
Los sistemas de documentos ya utilizan capas especializadas: un analizador como Cohere Parse o las herramientas de código abierto en nuestro Guía de Docling recuperan la estructura; los embeddings recuperan candidatos; los rerankers los reordenan. Jev podría añadir otra decisión: si la evidencia es suficiente, contradictoria, sensible, desactualizada o apropiada para un camino de respuesta particular.
4. Triaje, puntuación y operaciones
Clientes potenciales, tickets de soporte, facturas, informes de incidentes, reseñas y trazas de agentes contienen lenguaje no estructurado que eventualmente se convierte en una cola o en una puntuación. Jev está diseñado para esa conversión. El valor es mayor cuando la taxonomía cambia con la suficiente frecuencia como para que un clasificador personalizado resulte inconveniente, pero la salida sigue siendo limitada lo suficiente como para que la prosa no sea necesaria.
5. Decisiones map-reduce sobre muchos ítems
Un flujo de trabajo puede aplicar la misma pregunta de manera independiente a lo largo de pasajes, registros, mensajes o fragmentos de trazas, y luego permitir que el código agregue los resultados. Esto mantiene el enfoque del modelo en juicios semánticos locales mientras que el código determinista se ocupa del conteo, los umbrales y la selección final.
Dónde Jev no es la herramienta adecuada
TypeSafe es inusualmente directo sobre los bordes irregulares de Jev. Esa transparencia es útil porque un modelo especializado puede parecer ampliamente inteligente en una demostración y fallar en una tarea vecina.
- No lo uses para escribir. Jev no puede redactar una respuesta, explicación, resumen o línea de código.
- Mantén la aritmética en el código. El proveedor documenta debilidades en el conteo, cálculo y precisión numérica.
- Mantén la lógica de fechas en el código. La comparación de fechas y horas es un punto débil documentado.
- Escribe las preguntas literalmente. Las instrucciones indirectas o anidadas pueden reducir la fiabilidad.
- Elimina el contexto irrelevante. Grandes cantidades de estado no relacionado pueden perjudicar la decisión, incluso si encajan en el límite de contexto.
- Prueba entradas adversariales. La inyección de prompts y las instrucciones contradictorias aún pueden influir en el modelo.
- No confundas calibración con certeza. Un valor de alta confianza necesita validación con los propios datos del producto.
Una buena regla es dejar los hechos deterministas a los sistemas deterministas. El código debe calcular totales, comparar marcas de tiempo, verificar permisos, imponer límites y ejecutar efectos secundarios. Jev debería manejar la parte que realmente requiere juicio semántico.
Una arquitectura práctica: usar Jev junto a un LLM.
El diseño más convincente es una cascada en lugar de un reemplazo:
- El código realiza comprobaciones estrictas. Validar autenticación, límites, campos obligatorios, fechas y reglas numéricas.
- Jev toma la decisión semántica restringida. Clasificar la solicitud, evaluar riesgos o estimar si la evidencia es suficiente.
- El flujo de trabajo interpreta la incertidumbre. Aceptar una decisión confiada de bajo riesgo, derivar un caso ambiguo a un modelo más grande o pedir a una persona.
- Un LLM maneja trabajo generativo. Escribir la respuesta, investigar el problema, usar herramientas aprobadas o explicar el resultado.
- El código es el responsable de la acción. Registra la decisión y la versión de origen, aplica la política y realiza el cambio de estado final.
Este diseño puede reservar el razonamiento costoso para los casos que lo requieren. También puede facilitar la auditoría de un agente: el registro de decisiones contiene la pregunta, las respuestas permitidas, la probabilidad, el umbral, la ruta seleccionada y la versión del modelo en lugar de un párrafo opaco que otro componente interpretó.
Cómo evaluar Jev antes de usarlo en producción
- Comienza con una decisión existente. Elige una tarea que ya tenga como resultado una etiqueta, una puntuación ordenada o una probabilidad, no una tarea de escritura adaptada a una demostración de clasificación.
- Congela un conjunto de pruebas representativo. Incluye casos fáciles, casos ambiguos, etiquetas raras, entradas largas, lenguaje contradictorio y ejemplos adversariales.
- Utilice etiquetas revisadas por humanos. Un consenso de LLM puede iniciar la exploración, pero la precisión en producción debe medirse contra un estándar aprobado por personas.
- Medir la calibración, no solo la precisión. Agrupa las predicciones por probabilidad y verifica si la confianza coincide con la exactitud observada.
- Establecer umbrales por consecuencia. Optimice la compensación entre falsos positivos y falsos negativos para la decisión real. Una etiqueta de marketing y una retención de pago no deberían compartir un umbral.
- Compare el costo total de la tarea. Incluya reintentos, llamadas de respaldo LLM, revisiones humanas, redes y ingeniería, no solo el precio del token.
- Fijar la versión del modelo. Usar
jev-1.13.0para una evaluación reproducible; mover ajev-latestsolo con pruebas de regresión. - Registrar de manera segura. Registrar suficiente información para depurar la decisión sin conservar el texto fuente sensible más tiempo del necesario.
Acceso a Jev API en inglés simple
Jev está disponible a través del acceso anticipado API de TypeSafe y Playground. El API utiliza POST /v1/systemone, y TypeSafe proporciona SDKs para Python y JavaScript. Una solicitud contiene el estado compartido más una o más preguntas. La respuesta contiene los resultados tipados.
Los límites de acceso anticipado actualmente publicados son 250,000 tokens de entrada por segundo y 1,200 solicitudes por minuto, aunque TypeSafe indica que los límites son dinámicos mientras la demanda se estabiliza. Una solicitud puede contener varias preguntas independientes, por lo que un flujo de trabajo puede no necesitar una llamada de red para cada decisión.
Los desarrolladores deben tener en cuenta dos alias. jev-latest sigue la línea de producción estable y actualmente apunta a Jev 1.13. jev-preview está destinado al candidato más reciente y actualmente apunta a la misma versión. Fije el ID numérico cuando un cambio en el comportamiento pueda afectar un flujo de trabajo regulado o de alto impacto.
Consideraciones de privacidad y empresariales
La política de privacidad de TypeSafe dice que la información proporcionada por los clientes no se utiliza para entrenar ni ajustar sus modelos. También indica que los servicios se alojan en Estados Unidos. La política pública no promete un período fijo de retención cero para cada solicitud API; describe la retención de información personal según sea razonablemente necesaria para los fines indicados.
Eso no es lo mismo que decir que Jev no es adecuado para datos empresariales. Significa que los compradores deben obtener los términos exactos de procesamiento de datos, retención, subprocesadores, eliminación, seguridad y regionales que su carga de trabajo requiera. El acceso temprano también es el momento adecuado para preguntar sobre compromisos de nivel de servicio, registros de auditoría, avisos de versión de modelo, respuesta a incidentes y garantías de capacidad.
Preguntas frecuentes
¿Qué es Jev?
Jev es el primer modelo System One de TypeSafe AI. Convierte texto o estado estructurado en opciones, puntuaciones y probabilidades predefinidas para el código de la aplicación en lugar de generar prosa de manera abierta.
¿Es Jev un LLM?
TypeSafe presenta a Jev como una nueva categoría de modelo especialista en lugar de un LLM de propósito general. Entiende el estado en lenguaje natural, pero su función es la toma de decisiones limitada, no la generación de texto token por token.
¿Cuánto cuesta Jev?
TypeSafe actualmente lista a Jev 1.13 en $0.042 por millón de tokens de entrada, sin cargo por los tokens de salida. La compañía dice que los precios iniciales pueden estar subvencionados, por lo que los compradores de producción deben verificar la tarifa actual.
¿Qué tan rápido es Jev?
TypeSafe reporta una latencia de 70–500 ms de extremo a extremo para consultas adecuadas de System One. Ese es un rango reportado por el proveedor, no un SLA universal, y la geografía, la carga, la longitud de la entrada y el diseño del flujo de trabajo pueden cambiar el resultado.
¿Qué son Choice, Score y Noul?
Choice selecciona de etiquetas predefinidas, Score elige un valor en una escala ordenada, y Noul devuelve una probabilidad entre cero y uno. Choice y Score también devuelven distribuciones y un valor de confianza; Noul devuelve la probabilidad en sí.
¿Puede Jev alucinar?
Jev no puede inventar una salida fuera del tipo declarado, lo que previene respuestas mal formadas o abiertas. Aún puede tomar una decisión semánticamente incorrecta, por lo que los equipos deben evaluar la precisión, la calibración, el comportamiento adversarial y los umbrales.
¿Puede Jev reemplazar a GPT o Claude?
No. Jev no escribe, explica, programa, navega ni opera herramientas. Puede reemplazar algunas llamadas de clasificación o puntuación específicas y puede dirigir casos difíciles a un modelo general como GPT o Claude.
¿Es Jev adecuado para RAG?
Potencialmente, como una capa de decisión. Jev puede juzgar si la evidencia es suficiente, clasificar pasajes, puntuar la relevancia de la política o filtrar una respuesta. No crea incrustaciones, analiza documentos, reclasifica candidatos por defecto ni escribe la respuesta final citada.
¿Está Jev generalmente disponible?
No. Jev está en acceso anticipado a través del Playground de TypeSafe y API a partir del 17 de septiembre de 2026.
Fuentes y metodología
Este artículo fue investigado el 17 de septiembre de 2026. Las afirmaciones de diseño, velocidad, coste y benchmark del producto provienen de TypeSafe AI's lanzar artículo, documentación System One, página de modelo y precios, guía de confianza, inicio rápido, y sitio de evaluación de flujo de trabajo. Las limitaciones provienen de la guía de irregularidades Jev 1.13 del proveedor; las declaraciones sobre el manejo de datos provienen de su política de privacidad.
Etiquetamos los resultados gestionados por proveedores como afirmaciones del proveedor. El resultado del clasificador de Malte Ubl se incluye como un informe de un profesional independiente, no como un estándar universal. No ejecutamos Jev nosotros mismos, y no convertimos la mayor velocidad o el multiplicador de costo de TypeSafe en una afirmación sobre cargas de trabajo no relacionadas. Los precios, alias, accesos y límites tempranos pueden cambiar después de la publicación.
El punto clave
Jev es interesante porque cuestiona un hábito que se ha vuelto normal en el software de IA: enviar cada tarea semántica a un modelo construido para escribir. Muchas decisiones de producción no necesitan un ensayo. Necesitan una etiqueta conocida, una puntuación ordenada o una probabilidad sobre la que el código pueda actuar.
El primer lanzamiento de TypeSafe presenta un caso ambicioso para esa capa especializada. El precio es mínimo, la latencia reportada se mide en milisegundos, el contrato de salida es limitado y la incertidumbre está disponible para la aplicación. Las evaluaciones de lanzamiento y las primeras pruebas de desarrolladores hacen que Jev valga la pena para una experimentación seria.
Los límites son parte de la idea, no un pensamiento posterior. Jev no puede explicarse a sí mismo, no debería hacer aritmética ni lógica de fechas, aún puede clasificar incorrectamente y sigue siendo vulnerable a un mal contexto e instrucciones adversas. Pertenece entre el código determinista y un LLM de propósito general, no por encima de ambos.
Si esa arquitectura se mantiene con datos reales, el “modelo System One” podría convertirse en una categoría útil. Jev no necesita reemplazar a GPT, Claude o un clasificador entrenado para ser relevante. Solo necesita manejar suficientes pequeñas decisiones alrededor de ellos más rápido, más barato y con un contrato más limpio.