

- Outils d'IA
- Intelligence artificielle
Qu'est-ce que Jev ? Modèle System One de TypeSafe AI expliqué
Jev est un nouveau type de modèle d'IA conçu pour renvoyer des décisions rapides et tapées au lieu de la prose. Voici comment fonctionne System One, combien il coûte, où il se situe, et ce que ses premières preuves démontrent — et ne démontrent pas.
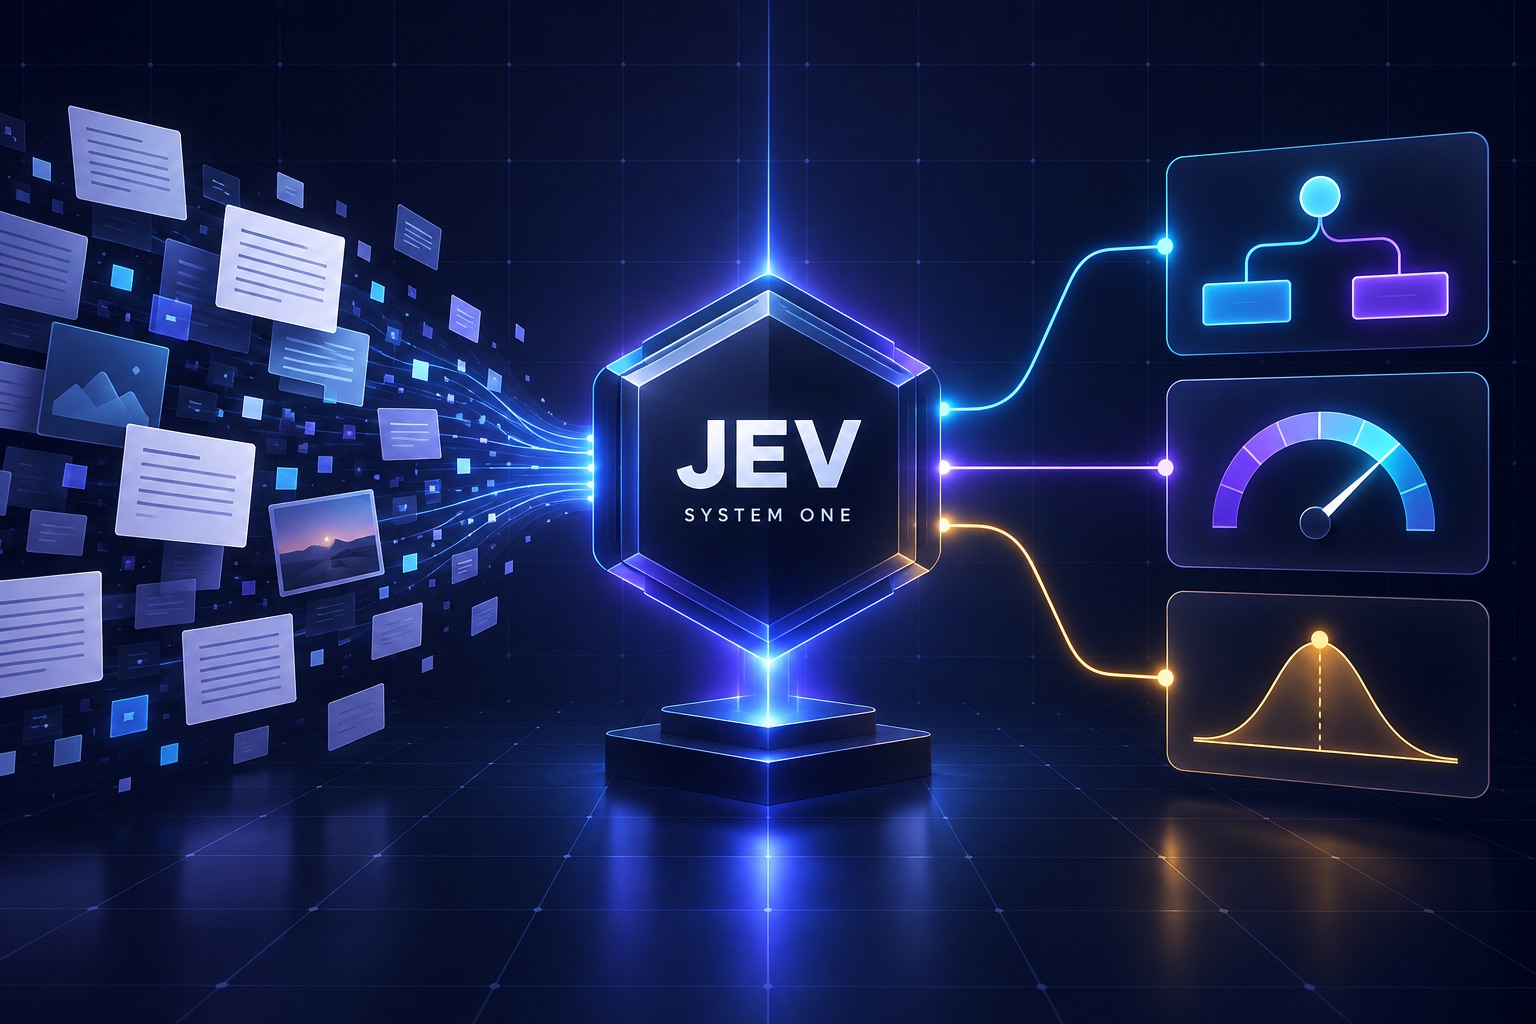
La plupart des modèles d'IA sont conçus pour dire quelque chose. Jev est conçu pour décider quelque chose — et retourner la réponse sous une forme que le logiciel peut utiliser immédiatement.
Un message client arrive. Est-ce une question de facturation, de support ou de ventes ? Un passage récupéré semble pertinent. Est-il assez solide pour être envoyé au modèle de réponse ? Un agent propose une action. Le workflow doit-il la permettre, la bloquer ou demander à une personne ?
Ce ne sont pas vraiment des tâches d'écriture. Ce sont de petits jugements enfouis dans le logiciel. Les équipes les confient souvent à un modèle de langage à usage général parce que c’est l’outil d’IA qu’elles ont déjà. Le modèle lit l’entrée, génère une réponse un jeton à la fois, et l’application analyse la réponse pour la transformer en étiquette, score ou booléen.
TypeSafe AI a introduit Jev le 15 septembre 2026 en tant que modèle différent. L’entreprise appelle la catégorie Modèles System One: un état non structuré entre, tandis que des choix limités, des scores, des probabilités et de la confiance en sortent. Jev ne discute pas, n'explique pas et n'écrit pas de code. Il prend des décisions sémantiques étroites.
Cela semble être une petite distinction. Cela peut être important. Si les affirmations initiales de Jev sur la rapidité, le coût et l'étalonnage résistent à des tests plus larges, les applications pourraient cesser d'utiliser un grand modèle de langage pour chaque petite branche d'un flux de travail. Le résultat ne remplacerait pas un LLM. Il donnerait au LLM—et au reste du logiciel autour de lui—une couche de décision plus rapide.
Ce guide explique ce qu'est Jev, ce que signifie « System One », comment fonctionnent ses questions de Choix, de Score et de Noul, combien cela coûte, ce que montrent les preuves de référence, et où ses limites sont importantes. Pour les spécifications compactes et les sources officielles, voir le page du modèle Jev 1.13 ou parcourir la nouvelle Catégorie des modèles de décision IA.
Réponse rapide — vérifié le 17 septembre 2026
Jev 1.13 est le premier modèle System One de TypeSafe AI. Il accepte du texte, JSON, ou des tableaux de texte plus des questions prédéfinies, puis retourne des décisions typées avec probabilités. TypeSafe le répertorie à 0,042 $ par million de jetons d'entrée avec sortie gratuite et rapporte une latence typique de bout en bout de 70 à 500 millisecondes pour des tâches appropriées. Il est en accès anticipé. Ce sont des chiffres publiés par le fournisseur, pas des garanties universelles.
| Fait Jev | Détail actuel |
|---|---|
| Développeur | TypeSafe AI |
| Modèle actuel | Jev 1.13 ; ID API jev-1.13.0 |
| Sortie | 15 septembre 2026 |
| Ce qu'il renvoie | Choix, scores ordinaux, probabilités et signaux de confiance |
| Ce qu'il ne renvoie pas | Prose ouverte, explications, code, images, audio ou vidéo |
| Capacité d'entrée | 64K tokens par requête ; état plus la question la plus longue jusqu'à 32K |
| Prix | 0,042 $ par million de tokens d'entrée ; la sortie est gratuite |
| Vitesse publiée | 70–500 ms de bout en bout pour les requêtes de type System One |
| Accès | Playground en accès anticipé et API avec SDK Python et JavaScript |
Qu'est-ce que Jev AI ?
Jev est un modèle spécialisé pour faire des jugements bornés sur du texte ou un état structuré. Au lieu de le solliciter pour « écrire un objet JSON » en espérant que la réponse générée suive le format, un développeur définit la réponse possible avant l'inférence. Jev renvoie alors l'une de ces valeurs autorisées — ou un score ou une probabilité — ainsi qu'une information sur l'incertitude.
Le modèle mental le plus simple est un classificateur très performant capable de comprendre le langage naturel, de considérer plusieurs questions à la fois et de montrer son niveau de certitude. Cette description est plus utile que de traiter Jev comme un petit chatbot. Il est conçu pour être intégré dans une application, et non pour être l'application.
Le modèle Jev
État non structuré → Jev → Choix + score + probabilité → Code de l'application
Le modèle gère le jugement sémantique. Le code contrôle toujours la règle, le seuil, les effets secondaires, la piste d'audit et le plan de secours.
Supposons qu’un système de support reçoive : « J’ai mis à jour hier, mais ma carte a été débitée deux fois et le paiement supplémentaire n’a toujours pas disparu. » Une requête Jev pourrait demander si le message concerne la facturation, à quel point il semble urgent, s’il doit être escaladé, et quelle est la probabilité qu’il contienne des informations sensibles sur le compte. Chaque question a une forme de sortie déclarée. L’application peut diriger le ticket sans analyser un paragraphe.
L’alias actuel jev-latest résout à jev-1.13.0. La plupart des lecteurs n’ont pas besoin de mémoriser cet identifiant ; il est principalement important pour des tests de production reproductibles. L’idée plus large est le produit : Jev est le premier membre d’une catégorie que TypeSafe espère capable de gérer les nombreuses petites décisions concernant les agents, la recherche, la modération, les opérations et les flux de travail client.
Pourquoi l’appeler un modèle « System One » ?
Le nom s'inspire du cadre Système 1 et Système 2 popularisé par le psychologue Daniel Kahneman. Le Système 1 décrit les jugements rapides et intuitifs ; le Système 2 décrit le raisonnement plus lent et délibéré. L'analogie n'est pas une affirmation selon laquelle Jev pense comme une personne. Elle décrit le travail pour lequel le modèle est optimisé.
Un LLM de pointe tel que GPT-6 Astra ou Claude Fable 5.1 est conçu pour un travail large et génératif : enquêter sur un problème, utiliser des outils, écrire du code, expliquer les compromis ou produire un document. Jev est intentionnellement plus restreint. Il lit l'état disponible et renvoie rapidement une petite décision.
TypeSafe dit que l'architecture utilise un échantillonneur parallèle plutôt que de générer une réponse token par token. Sa documentation indique également que les questions dans la même demande sont évaluées de manière indépendante et en parallèle. Cela signifie que l'ajout de plusieurs questions de classification ou de notation devrait avoir un impact sur la latence beaucoup plus faible que de demander à un LLM général de les traiter séquentiellement.
L'entreprise a entraîné Jev en utilisant RLCD, abréviation de Reinforcement Learning for Calibrated Decisions. L'objectif important pour l'utilisateur est l'étalonnage : pour de nombreuses prédictions similaires, une probabilité de 80 % devrait être correcte environ 80 % du temps. L'étalonnage ne promet pas qu'une réponse individuelle soit correcte. Il rend l'incertitude plus utile pour le routage et les seuils.
Choix, Score et Noul : les trois types de questions de Jev
Jev expose actuellement trois primitives. Ensemble, elles couvrent une grande part des petits jugements cachés à l'intérieur des logiciels métier.
Le choix sélectionne parmi un ensemble autorisé
Une question de type Choix donne à Jev une liste fixe de libellés : facturation, support technique, ventes, annulation ou autre. La réponse inclut le libellé sélectionné, la distribution de probabilité parmi les choix disponibles, et une valeur de confiance dérivée de cette distribution.
Cela convient pour la classification d'intention, l'acheminement dans une file d'attente, la sélection de politique, l'étiquetage de contenu, et la décision sur quel outil ou agent devrait recevoir une tâche. Les documents TypeSafe supportent jusqu'à 255 choix. Pour des ensembles de libellés très larges, la recommandation est de réduire le champ puis de prendre une seconde décision au lieu de traiter des centaines de choix quasi identiques comme un seul problème unique.
Le score place un élément sur une échelle ordonnée
Une question Score définit une plage ordonnée — par exemple, l'urgence de un à cinq ou la qualité du prospect de zéro à dix. Jev renvoie un score ainsi que la répartition des valeurs autorisées et un signal de confiance.
Les Scores sont utiles lorsque la différence entre des résultats adjacents est importante. Un score de risque de quatre est plus proche de cinq que de un ; un simple ensemble d'étiquettes non liées n'exprime pas cet ordre. Les applications peuvent convertir le résultat en niveaux de service, files de révision, seuils ou priorisation.
Noul estime la probabilité d'une déclaration
Une question Noul demande une valeur comprise entre zéro et un : quelle est la probabilité que ce passage réponde à la requête, quelle est la probabilité que la requête viole une règle, ou quelle est la probabilité que cette trace d’agent indique un échec ? Noul renvoie directement la probabilité. Contrairement à Choice et Score, la réponse Noul courante n’ajoute pas de propriété de confiance distincte.
Le nom inhabituel est moins important que le modèle. Au lieu de forcer un modèle à dire « oui » ou « non » à une limite arbitraire, l'application reçoit une probabilité et choisit elle-même la limite. Une décision de personnalisation bénigne pourrait accepter 0,65. Une action de paiement ou de sécurité à haut risque pourrait nécessiter 0,98 et une seconde vérification.
Jev a-t-il vraiment « zéro hallucination » ?
TypeSafe utilise un langage strict autour des hallucinations parce que Jev ne peut pas inventer une quatrième catégorie lorsque le schéma n'en permet que trois, renvoyer un paragraphe alors que le code attend un nombre, ou improviser un champ non reconnu. C'est une amélioration significative de la fiabilité. Le forme la réponse est limitée.
Cela ne signifie pas que le jugement est toujours vrai. Jev peut toujours choisir la mauvaise étiquette, attribuer un score trop élevé, mal comprendre une instruction indirecte ou devenir moins fiable lorsque l'entrée est hostile ou pleine de matériel non pertinent. Le propre TypeSafe Guide de dentelure Jev 1.13 documente ces faiblesses.
Une façon précise de le dire est :
- L'hallucination de schéma est limitée. La sortie doit correspondre au type de décision déclaré.
- Une erreur sémantique est toujours possible. Une étiquette valide peut toujours être la mauvaise étiquette.
- La confiance aide à gérer l'erreur. Elle peut déclencher une révision ou une solution de secours, mais ce n'est pas une preuve.
Cette distinction importe pour chaque système d'IA structuré. Le mode JSON dans un LLM général peut garantir des champs analysables tandis que les valeurs à l'intérieur de ces champs restent erronées. Jev réduit davantage le problème en spécialisant l'ensemble du modèle autour de décisions limitées, mais les équipes de production ont toujours besoin d'évaluations et de seuils sûrs.
À quel point est-ce rapide et peu coûteux Jev ?
La page de modèle actuelle de TypeSafe répertorie Jev 1.13 à 42 $ par milliard de jetons d'entrée, equivalent to 0,042 $ par million de jetons d'entrée. La sortie est gratuite car Jev ne génère pas de longue réponse. À ce rythme, un million de demandes de classification de 500 tokens utiliserait 500 millions de tokens d'entrée et entraînerait un coût de liste de modèles d'environ $21, avant toutes dépenses liées aux applications, au stockage, au réseau ou à la revue humaine.
Les rapports de lancement 70 à 500 millisecondes de bout en bout pour des tâches conçues pour System One, et revendique des accélérations de 40× à 200× par rapport aux modèles généraux utilisés dans ses comparaisons. Ces chiffres nécessitent le contexte que TypeSafe lui-même fournit :
- la plupart des tests de temps ont été réalisés depuis des ordinateurs portables sur la côte ouest des États-Unis ;
- les quatre évaluations de flux de travail ont été conçues par l'équipe TypeSafe ;
- les étiquettes de comparaison ont été dérivées de réponses de GPT-6 Astra et Claude Fable 5.1 de haut niveau plutôt que de labels humains indépendants ; et
- la société indique que la tarification initiale peut être subventionnée et ne doit pas être considérée comme permanente.
En d'autres termes, les preuves de lancement sont prometteuses, mais non concluantes. Le maximum annoncé — 193,6× plus rapide et 444,6× moins cher — représente l'extrémité favorable d'un ensemble de tâches gérées par le fournisseur, et non un facteur de conversion universel pour chaque appel LLM.
Ce que montrent réellement les premières évaluations Jev
TypeSafe publie quatre évaluations de flux de travail couvrant la classification des incidents de sécurité, l'observabilité des traces des agents, le traitement des factures et les décisions de service client. Chaque flux de travail décompose une invite générale en plusieurs questions typées, puis compare la précision, le coût et le temps avec une référence basée sur un modèle général.
Le résultat central concerne moins un classement qu’un schéma de flux de travail. Si une tâche se termine par une poignée d’étiquettes ou de nombres, un modèle spécialisé peut éviter de payer un LLM général pour composer et sérialiser une réponse qu’il n’avait jamais besoin d’écrire. Les questions parallèles peuvent également remplacer plusieurs appels séparés.
Il y a une pièce de preuve externe utile. L'ingénieur Malte Ubl a écrit qu'il avait fait fonctionner Jev contre une évaluation de classificateur existante qui avait utilisé Gemini 2.5 Flash-Lite ; dans ce test, Jev a saturé l'évaluation de la qualité et a fonctionné environ six fois plus rapidement. Ce rapport est encourageant car l'évaluation a précédé Jev, mais il s'agit toujours d'un test réalisé par un seul développeur — et non d'une large suite de tests indépendante.
Pour une explication visuelle rapide, Matija Sosic a publié un Résumé Jev de 45 secondes. Steve Krouse a également partagé un démonstration en direct de petite taille qui rend le modèle état-et-questions plus facile à ressentir qu'un tableau de référence.
Les preuves sont suffisantes pour justifier le test de Jev. Elles ne sont pas encore suffisantes pour déclarer que Jev dépasse tous les petits LLM, classificateurs, réévaluateurs ou moteurs de règles. Une évaluation équitable doit utiliser des exemples figés du produit réel, des étiquettes examinées par des humains, le même chemin réseau et une politique de seuil choisie avant de voir les résultats.
Jev vs LLMs : qu'est-ce qui est réellement différent ?
| Dimension | Jev / System One | LLM à usage général |
|---|---|---|
| Tâche principale | Choisir, scorer ou estimer une probabilité | Générer, raisonner, expliquer, coder et utiliser des outils |
| Sortie | Valeurs typées prédéfinies | Jetons ouverts, éventuellement contraints à JSON |
| Incertitude | Distributions de probabilité natives et confiance lorsqu'elles sont supportées | Généralement non exposé en tant que signal d'application calibré |
| Questions multiples | Questions indépendantes évaluées en parallèle | Souvent répondues en une seule séquence générée ou plusieurs appels |
| Meilleur pour | Décisions sémantiques étroites à volume élevé | Travail ambigu, créatif, multi-étapes ou explicatif |
| Ne peut pas faire | Écrire de la prose, du code ou des explications | Peut générer les trois |
La bonne comparaison n'est donc pas « Jev peut-il battre un modèle de pointe ? ». Il s'agit plutôt de « Pourquoi demandons-nous à un modèle de pointe de faire ce travail en particulier ? » A petit modèle général tel que GPT-5.6 Luna ou Claude Haiku 4.5 reste plus flexible. Il peut extraire un champ, réécrire un message, appeler un outil et expliquer sa réponse dans la même requête. Jev abandonne cette flexibilité en échange d'un contrat plus strict.
Jev vs sortie structurée ou mode JSON
La sortie structurée est l'alternative familière la plus proche. Un développeur donne un schéma à un LLM ; le fournisseur contraint la réponse générée pour qu'elle soit analysable. C'est excellent lorsqu'une application a besoin d'un objet riche avec des noms, des descriptions, des dates ou d'autres champs générés.
Jev est mieux adapté à un espace de sortie plus petit. Les réponses existent déjà ; le modèle se contente de les sélectionner ou de les évaluer. Il y a moins de sorties à générer, la distribution de probabilité fait partie du produit, et toute l'architecture est optimisée autour de la décision. Utilisez le mode JSON lorsque vous avez besoin de contenu généré à l'intérieur d'une structure. Envisagez Jev lorsque chaque réponse valide est déjà connue.
Jev contre un classificateur traditionnel
Un classificateur conventionnel peut être extrêmement rapide et peu coûteux après l'entraînement. Il peut être le meilleur choix pour un problème stable et à volume élevé avec suffisamment de données étiquetées. L'intérêt de Jev est d'essayer d'apporter la flexibilité du langage naturel et une configuration few-shot à ce type de travail sans demander à chaque équipe de former et d'exploiter un modèle séparé.
Le compromis est le contrôle. Un classificateur personnalisé peut être ajusté autour d’une taxonomie étroite, inspecté avec des métriques familières et déployé dans un environnement privé. Jev est actuellement un service en accès anticipé hébergé. Les équipes devraient comparer non seulement la précision et la latence, mais aussi l’emplacement des données, les besoins de réentraînement, la rotation des étiquettes et l’effort opérationnel.
Jev vs un reclassificateur
Un reclassificateur tel que Cohere Rerank 4 Fast prend une requête et des documents candidats, puis ordonne ces candidats par pertinence. Jev peut demander si un passage répond à une question ou évaluer un passage contre une grille de notation, mais il n’est pas automatiquement un modèle de reclassification prêt à l’emploi avec le même objectif d’entraînement et le même contrat spécifique à la recherche.
Pour RAG, les outils peuvent se compléter les uns les autres. La récupération trouve des candidats, un réorganisateur les classe, et Jev peut prendre une décision limitée telle que « les preuves principales sont-elles suffisantes pour répondre ? » ou « quel sujet de politique ce passage soutient-il ? » Un modèle plus grand rédige ensuite la réponse citée seulement lorsque la couche de décision indique que les preuves sont adéquates.
Où Jev pourrait être utile
1. Acheminement des demandes et travail des agents
Jev peut classifier une demande entrante, sélectionner un agent spécialiste, évaluer l’urgence et décider si une personne doit la réviser. Parce que chaque sortie est limitée, l'orchestrateur n’a pas besoin d’interpréter une réponse narrative avant de passer à l’étape suivante.
2. Ajouter des filtres de confiance aux agents d’IA
Un agent peut proposer une action tandis que Jev juge séparément si l'action correspond à l'objectif de l'utilisateur, respecte la politique ou semble complète. Les cas à faible confiance peuvent être mis en pause. Il ne s'agit pas d'une frontière de sécurité complète : le modèle peut encore être influencé par des entrées adverses, mais cela peut ajouter une vérification sémantique rapide avant que le code n'applique la règle finale.
3. Améliorer RAG et la recherche d'entreprise
Les systèmes de documents utilisent déjà des couches spécialisées : un analyseur tel que Cohere Parse ou les outils open-source dans notre Guide Docling reconstituer la structure ; les embeddings récupèrent les candidats ; les réévaluateurs les réordonnent. Jev pourrait ajouter une autre décision : si les preuves sont suffisantes, contradictoires, sensibles, obsolètes ou appropriées pour un chemin de réponse particulier.
4. Tri, évaluation et opérations
Les prospects, les tickets de support, les factures, les rapports d'incidents, les critiques et les traces d'agents contiennent tous un langage non structuré qui finit par devenir une file d'attente ou un score. Jev est conçu pour cette conversion. La valeur est la plus élevée lorsque la taxonomie change assez souvent pour qu'un classificateur personnalisé devienne peu pratique, mais que la sortie reste suffisamment limitée pour que la prose soit inutile.
5. Décisions map-reduce sur de nombreux éléments
Un flux de travail peut appliquer la même question de manière indépendante à travers des passages, des enregistrements, des messages ou des plages de traces, puis laisser le code agréger les résultats. Cela permet de garder le modèle concentré sur les jugements sémantiques locaux tandis que le code déterministe gère le comptage, les seuils et la sélection finale.
Où Jev n'est pas l'outil approprié
TypeSafe est inhabituellement direct concernant les arêtes irrégulières de Jev. Cette transparence est utile car un modèle spécialisé peut sembler largement intelligent dans une démonstration et échouer sur une tâche voisine.
- Ne l'utilisez pas pour écrire. Jev ne peut pas rédiger de réponse, d'explication, de résumé ou de ligne de code.
- Conservez l'arithmétique dans le code. Le fournisseur documente des faiblesses dans le comptage, le calcul et la précision numérique.
- Conservez la logique des dates dans le code. Comparer les dates et heures est un point faible documenté.
- Écrivez les questions littéralement. Les instructions indirectes ou imbriquées peuvent réduire la fiabilité.
- Supprimez le contexte non pertinent. De grandes quantités d'état non lié peuvent nuire à la décision même si elles rentrent dans la limite de contexte.
- Testez les entrées adverses. L'injection de prompt et les instructions contradictoires peuvent toujours influencer le modèle.
- Ne confondez pas la calibration avec la certitude. Une valeur de confiance élevée nécessite une validation sur les propres données du produit.
Une bonne règle est de laisser les faits déterministes aux systèmes déterministes. Le code doit calculer les totaux, comparer les horodatages, vérifier les permissions, appliquer les limites et exécuter des effets secondaires. Jev devrait gérer la partie qui nécessite réellement un jugement sémantique.
Une architecture pratique : utiliser Jev à côté d'un LLM.
Le design le plus convaincant est en cascade plutôt qu'en remplacement :
- Le code effectue des vérifications strictes. Valider l'authentification, les limites, les champs requis, les dates et les règles numériques.
- Jev prend la décision sémantique étroite. Classifier la demande, évaluer le risque, ou estimer si les preuves sont suffisantes.
- Le flux de travail lit l’incertitude. Accepter une décision confiante à faible risque, diriger un cas ambigu vers un modèle plus large, ou demander à une personne.
- Un LLM gère le travail génératif. Écrire la réponse, rechercher le problème, appeler les outils approuvés, ou expliquer le résultat.
- Le code est propriétaire de l'action. Enregistrez la décision et la version de la source, appliquez la politique et effectuez le changement d'état final.
Cette disposition peut réserver un raisonnement coûteux pour les cas qui en ont besoin. Elle peut également faciliter l'audit d'un agent : le registre des décisions contient la question, les réponses autorisées, la probabilité, le seuil, la route sélectionnée et la version du modèle au lieu d'un paragraphe opaque interprété par un autre composant.
Comment évaluer Jev avant de l'utiliser en production
- Commencez par une décision existante. Choisissez une tâche qui se termine déjà par une étiquette, un score ordonné ou une probabilité — pas une tâche d'écriture adaptée à une démo de classification.
- Gelez un ensemble de tests représentatif. Incluez des cas faciles, des cas ambigus, des étiquettes rares, des entrées longues, un langage contradictoire et des exemples adversaires.
- Utilisez des étiquettes examinées par des humains. Un consensus LLM peut amorcer l'exploration, mais l'exactitude en production doit être mesurée par rapport à une norme approuvée par les humains.
- Mesurer l'étalonnage, pas seulement la précision. Regroupez les prédictions par probabilité et vérifiez si la confiance correspond à l'exactitude observée.
- Définissez les seuils en fonction des conséquences. Optimisez le compromis entre faux positifs et faux négatifs pour la décision réelle. Un tag marketing et une retenue de paiement ne devraient pas partager un seuil.
- Comparer le coût total de la tâche. Incluez les tentatives répétées, les appels de secours LLM, les examens humains, la mise en réseau et l'ingénierie — pas seulement le prix du jeton.
- Épingler la version du modèle. Utiliser
jev-1.13.0pour une évaluation reproductible ; passer àjev-latestseulement avec des tests de régression. - Connectez-vous en toute sécurité. Enregistrez suffisamment pour déboguer la décision sans conserver le texte source sensible plus longtemps que nécessaire.
Jev API accès en anglais clair
Jev est disponible via l'accès anticipé API et Playground de TypeSafe. Le API utilise POST /v1/systemone, et TypeSafe fournit des SDK pour Python et JavaScript. Une requête contient l'état partagé ainsi qu'une ou plusieurs questions. La réponse contient les résultats typés.
Les limites actuelles publiées en accès anticipé sont de 250 000 jetons d'entrée par seconde et de 1 200 requêtes par minute, bien que TypeSafe indique que les limites sont dynamiques pendant que la demande se stabilise. Une requête peut contenir plusieurs questions indépendantes, de sorte qu'un flux de travail peut ne pas nécessiter un appel réseau pour chaque décision.
Les développeurs doivent garder à l'esprit deux alias. jev-latest suit la ligne de production stable et pointe actuellement vers Jev 1.13. jev-preview est destiné au dernier candidat et pointe actuellement vers la même version. Épinglez l'ID numérique lorsque un changement de comportement pourrait affecter un flux de travail réglementé ou à fort impact.
Considérations de confidentialité et d'entreprise
La politique de confidentialité de TypeSafe indique que les informations saisies par les clients ne sont pas utilisées pour entraîner ou affiner ses modèles. Elle précise également que les services sont hébergés aux États-Unis. La politique publique ne promet pas une période de rétention zéro fixe pour chaque requête API ; elle décrit la rétention des informations personnelles dans la mesure raisonnablement nécessaire aux fins indiquées.
Ce n'est pas la même chose que de dire que Jev est inadapté aux données d'entreprise. Cela signifie que les acheteurs doivent obtenir les conditions exactes de traitement des données, de rétention, de sous-traitance, de suppression, de sécurité et de localisation géographique que leur charge de travail exige. L'accès anticipé est également le moment opportun pour poser des questions sur les engagements de niveau de service, les journaux d'audit, les notifications de version de modèle, la réponse aux incidents et les garanties de capacité.
Questions fréquemment posées
Qu'est-ce que Jev ?
Jev est le premier modèle System One de TypeSafe AI. Il transforme le texte ou l'état structuré en choix, scores et probabilités prédéfinis pour le code applicatif plutôt que de générer une prose ouverte.
Jev est-il un LLM ?
TypeSafe présente Jev comme une nouvelle catégorie de modèle spécialisé plutôt qu'un LLM polyvalent. Il comprend l'état en langage naturel, mais sa mission est la prise de décision limitée, et non la génération de texte token par token.
Combien coûte Jev ?
TypeSafe liste actuellement Jev 1.13 à 0,042 $ par million de tokens d'entrée, sans frais pour les tokens de sortie. La société indique que les premiers tarifs peuvent être subventionnés, donc les acheteurs en production doivent vérifier le tarif en vigueur.
Quelle est la rapidité de Jev ?
TypeSafe rapporte une latence de 70 à 500 ms de bout en bout pour les requêtes System One appropriées. Il s'agit d'une plage rapportée par le fournisseur, et non d'un SLA universel, et la géographie, la charge, la longueur de l'entrée et la conception du flux de travail peuvent modifier le résultat.
Que sont Choice, Score et Noul ?
Choice sélectionne parmi des étiquettes prédéfinies, Score choisit une valeur sur une échelle ordonnée, et Noul renvoie une probabilité comprise entre zéro et un. Choice et Score renvoient également des distributions et une valeur de confiance ; Noul renvoie la probabilité elle-même.
Jev peut-il halluciner ?
Jev ne peut pas inventer un résultat en dehors du type déclaré, ce qui empêche des réponses mal formées ou ouvertes. Il peut néanmoins prendre une décision sémantiquement incorrecte, donc les équipes doivent évaluer la précision, la calibration, le comportement antagoniste et les seuils.
Jev peut-il remplacer GPT ou Claude ?
Non. Jev n'écrit pas, n'explique pas, ne code pas, ne navigue pas et n'utilise pas d'outils. Il peut remplacer certains appels de classification ou de notation spécifiques et peut diriger les cas difficiles vers un modèle général tel que GPT ou Claude.
Jev est-il bon pour RAG ?
Potentiellement, en tant que couche de décision. Jev peut juger si les preuves sont suffisantes, classer des passages, évaluer la pertinence des politiques ou filtrer une réponse. Il ne crée pas d'intégrations, n'analyse pas les documents, ne reclasse pas les candidats par défaut, et n'écrit pas la réponse finale citée.
Jev est-il généralement disponible ?
Non. Jev est en accès anticipé via le Playground de TypeSafe et API à partir du 17 septembre 2026.
Sources et méthodologie
Cet article a été recherché le 17 septembre 2026. La conception du produit, la vitesse, le coût et les revendications de références proviennent de TypeSafe AI lancer l'article, documentation System One, page modèle et tarification, guide de confiance, prise en main, et site d'évaluation du flux de travail. Les limitations proviennent du guide de rugosité Jev 1.13 du fournisseur ; les déclarations de traitement des données proviennent de son politique de confidentialité.
Nous étiquetons les résultats gérés par le fournisseur comme des déclarations du fournisseur. Le résultat du classificateur de Malte Ubl est inclus comme un rapport d'un praticien indépendant, et non comme une référence universelle. Nous n'avons pas exécuté Jev nous-mêmes, et nous ne convertissons pas la vitesse maximale ou le multiplicateur de coût de TypeSafe en une affirmation concernant des charges de travail non liées. Les prix, alias, accès et limites initiales peuvent changer après publication.
Le résultat net
Jev est intéressant car il remet en question une habitude qui est devenue normale dans les logiciels d'IA : envoyer chaque tâche sémantique à un modèle conçu pour écrire. De nombreuses décisions de production n'ont pas besoin d'un essai. Elles ont besoin d'une étiquette connue, d'un score ordonné ou d'une probabilité sur laquelle le code peut agir.
La première version de TypeSafe présente un argument ambitieux pour cette couche spécialisée. Le prix est minime, la latence rapportée se mesure en millisecondes, le contrat de sortie est étroit et l'incertitude est disponible pour l'application. Les évaluations de lancement et les premiers tests développeurs rendent Jev digne d'une expérimentation sérieuse.
Les limites font partie de l'idée, ce n'est pas une réflexion après coup. Jev ne peut pas s'expliquer lui-même, ne devrait pas faire de calculs arithmétiques ou de logique des dates, peut encore classifier incorrectement, et reste vulnérable à un mauvais contexte et à des instructions adverses. Il se situe entre le code déterministe et un LLM à usage général, et non au-dessus des deux.
Si cette architecture tient sur des données réelles, le « modèle System One » pourrait devenir une catégorie utile. Jev n'a pas besoin de remplacer GPT, Claude ou un classificateur entraîné pour être important. Il lui suffit de gérer suffisamment des petites décisions autour d'eux plus rapidement, à moindre coût et avec un contrat plus clair.