

- Ferramentas de IA
- Inteligência artificial
O que é Jev? Modelo System One da TypeSafe AI Explicado
Jev é um novo tipo de modelo de IA criado para retornar decisões digitadas rapidamente, em vez de prosa. Aqui está como System One funciona, quanto custa, onde se encaixa e o que suas primeiras evidências provam—e não provam.
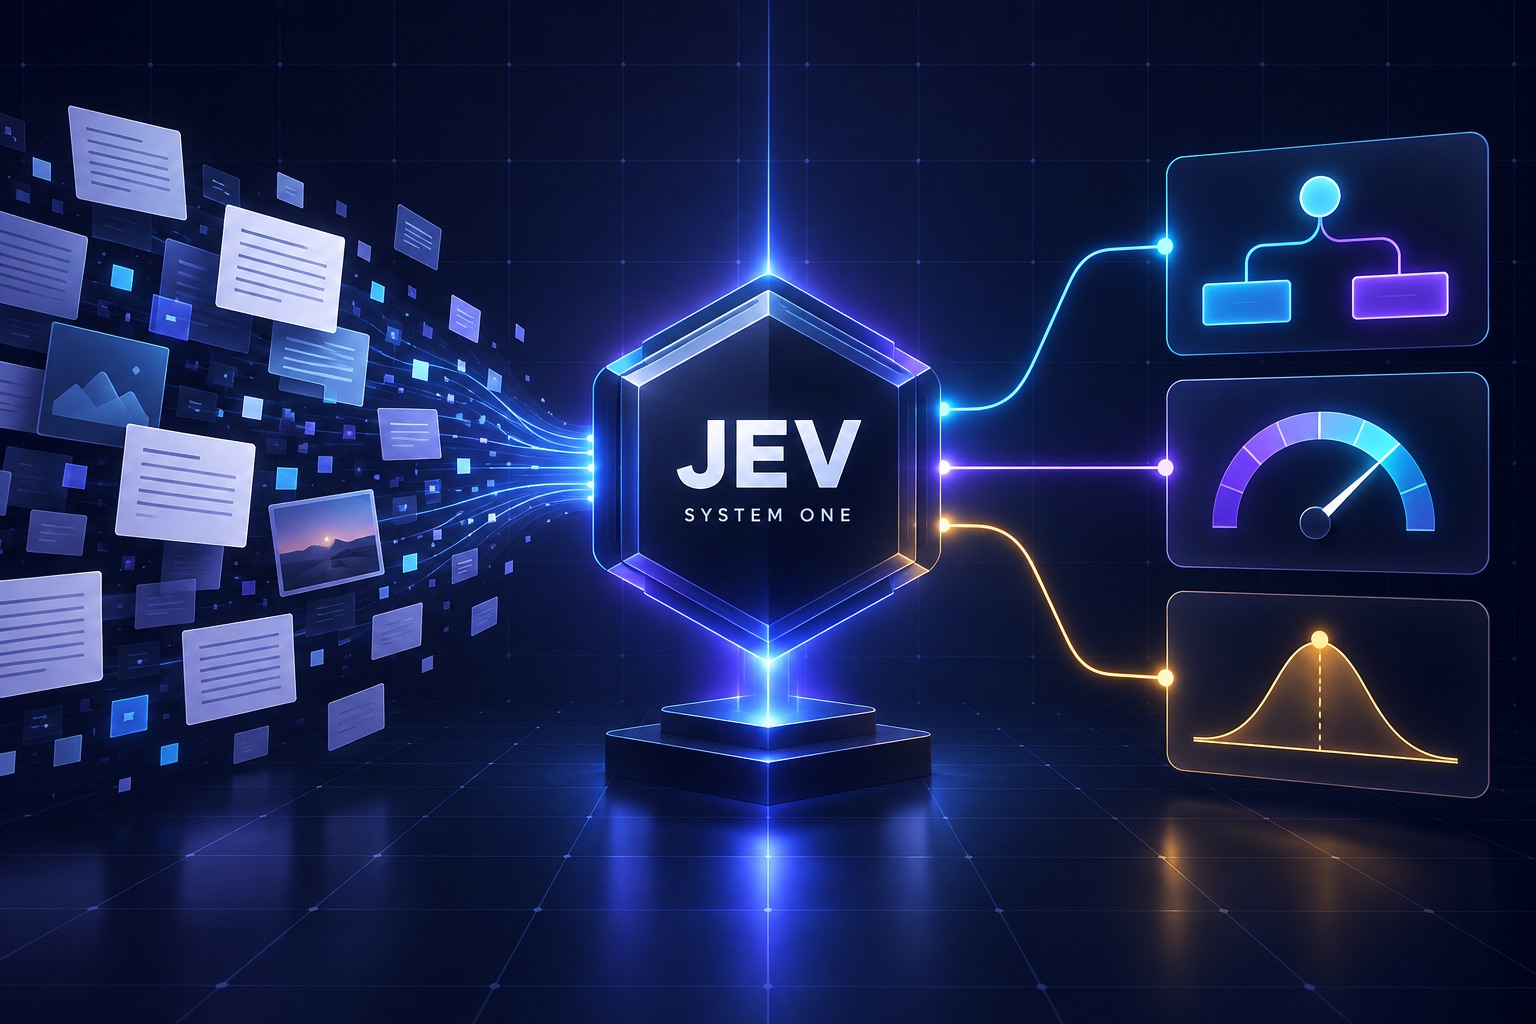
A maioria dos modelos de IA é construída para dizer algo. Jev é construído para decidir algo — e retornar a resposta em uma forma que o software possa usar imediatamente.
Uma mensagem de um cliente chega. É sobre faturamento, suporte ou vendas? Um trecho recuperado parece relevante. É forte o suficiente para enviar ao modelo de resposta? Um agente propõe uma ação. O fluxo de trabalho deve permitir, bloquear ou perguntar a uma pessoa?
Estas não são realmente tarefas de escrita. São pequenos julgamentos enterrados dentro do software. As equipes frequentemente os dão a um modelo de linguagem de uso geral porque essa é a ferramenta de IA que já possuem. O modelo lê a entrada, gera uma resposta um token de cada vez, e a aplicação analisa a resposta de volta em uma etiqueta, pontuação ou valor booleano.
TypeSafe AI apresentou Jev em 15 de setembro de 2026 como um tipo diferente de modelo. A empresa chama a categoria System One Models: um estado não estruturado entra, enquanto escolhas limitadas, pontuações, probabilidades e confiança saem. Jev não conversa, explica ou escreve código. Ele toma decisões semânticas restritas.
Isso parece uma distinção pequena. Pode ser uma importante. Se as alegações de Jev sobre velocidade, custo e calibração no início resistirem a testes mais amplos, as aplicações poderiam parar de usar um grande modelo de linguagem para cada pequeno ramo em um fluxo de trabalho. O resultado não substituiria um LLM. Ele daria ao LLM—e ao restante do software ao redor dele—uma camada de decisão mais rápida.
Este guia explica o que é Jev, o que significa “System One”, como funcionam suas questões Choice, Score e Noul, quanto custa, o que as evidências de referência mostram e onde suas limitações são relevantes. Para as especificações compactas e fontes de primeira mão, veja o Página do modelo Jev 1.13 ou navegue pelo novo Categoria de modelos de decisão de IA.
Resposta rápida — verificado em 17 de setembro de 2026
Jev 1.13 é o primeiro modelo System One do TypeSafe AI. Ele aceita texto, JSON ou arrays de texto juntamente com perguntas predefinidas, e então retorna decisões tipadas com probabilidades. O TypeSafe lista-o em $0,042 por milhão de tokens de entrada com saída gratuita e relata latência típica de ponta a ponta de 70–500 milissegundos para tarefas adequadas. Ele está em acesso inicial. Esses são números publicados pelo provedor, não garantias universais.
| Fato Jev | Detalhe atual |
|---|---|
| Desenvolvedor | TypeSafe AI |
| Modelo atual | Jev 1.13; ID API jev-1.13.0 |
| Lançamento | 15 de setembro de 2026 |
| O que ele retorna | Escolhas, pontuações ordinais, probabilidades e sinais de confiança |
| O que ele não retorna | Prosa aberta, explicações, código, imagens, áudio ou vídeo |
| Capacidade de entrada | 64K tokens por solicitação; estado mais a pergunta mais longa até 32K |
| Preço | $0,042 por milhão de tokens de entrada; a saída é gratuita |
| Velocidade publicada | 70–500 ms de ponta a ponta para consultas no formato System One |
| Acesso | Playground de acesso antecipado e API com SDKs para Python e JavaScript |
O que é o Jev AI?
Jev é um modelo especialista para fazer julgamentos limitados sobre texto ou estado estruturado. Em vez de instruí-lo a “escrever um objeto JSON” e esperar que a resposta gerada siga o formato, um desenvolvedor define a resposta possível antes da inferência. O Jev então retorna um desses valores permitidos—ou uma pontuação ou probabilidade—junto com informações sobre incerteza.
O modelo mental mais fácil é um classificador muito capaz que entende linguagem natural, considere muitas perguntas ao mesmo tempo e expõe o quão certo ela é. Essa descrição é mais útil do que tratar Jev como um chatbot minúsculo. Ela foi projetada para ficar dentro de uma aplicação, não para ser a aplicação.
O padrão Jev
Estado não estruturado → Jev → Escolha + pontuação + probabilidade → Código da aplicação
O modelo cuida do julgamento semântico. O código ainda controla a regra, o limiar, o efeito colateral, a trilha de auditoria e o respaldo.
Suponha que um sistema de suporte receba: “Fiz a atualização ontem, mas meu cartão foi cobrado duas vezes e o pagamento extra ainda não desapareceu.” Uma solicitação Jev poderia perguntar se a mensagem diz respeito a cobrança, quão urgente ela parece, se deve ser escalada e quão provável é que contenha informações sensíveis da conta. Cada pergunta tem um formato de saída declarado. O aplicativo pode direcionar o chamado sem precisar analisar um parágrafo.
O alias atual jev-latest resolve para jev-1.13.0. A maioria dos leitores não precisa memorizar esse ID; ele importa principalmente para testes de produção reproduzíveis. A ideia mais ampla é o produto: Jev é o primeiro membro de uma categoria que a TypeSafe espera que lide com as muitas pequenas decisões relacionadas a agentes, pesquisa, moderação, operações e fluxos de trabalho do cliente.
Por que chamá-lo de modelo “System One”?
O nome é inspirado na estrutura Sistema 1 e Sistema 2 popularizada pelo psicólogo Daniel Kahneman. O Sistema 1 descreve julgamentos rápidos e intuitivos; o Sistema 2 descreve um raciocínio mais lento e deliberado. A analogia não é uma afirmação de que Jev pensa como uma pessoa. Ela descreve o trabalho para o qual o modelo é otimizado.
Um LLM de fronteira, como GPT-6 Astra ou Claude Fable 5.1 é construído para trabalho amplo e generativo: investigar um problema, usar ferramentas, escrever código, explicar compensações ou produzir um documento. Jev é intencionalmente mais restrito. Ele lê o estado disponível e retorna uma pequena decisão rapidamente.
TypeSafe diz que a arquitetura usa um amostrador paralelo em vez de gerar uma resposta token por token. Sua documentação também afirma que perguntas na mesma solicitação são avaliadas de forma independente e em paralelo. Isso significa que adicionar várias perguntas de classificação ou pontuação deve ter uma penalidade de latência muito menor do que pedir a um LLM geral para processá-las sequencialmente.
A empresa treinou o Jev usando RLCD, abreviação de Reinforcement Learning for Calibrated Decisions. O objetivo importante voltado ao usuário é a calibração: em muitas previsões semelhantes, uma probabilidade de 80% deve estar correta aproximadamente 80% do tempo. A calibração não promete que uma resposta individual esteja correta. Ela torna a incerteza mais útil para roteamento e definição de limites.
Escolha, Pontuação e Noul: os três tipos de perguntas do Jev
Atualmente, o Jev expõe três primitivas. Juntas, elas cobrem uma grande parte dos pequenos julgamentos escondidos dentro do software empresarial.
Escolha seleciona a partir de um conjunto permitido
Uma pergunta de Escolha dá ao Jev uma lista fixa de rótulos: faturamento, suporte técnico, vendas, cancelamento ou outra coisa. A resposta inclui o rótulo selecionado, a distribuição de probabilidade entre as opções disponíveis e um valor de confiança derivado dessa distribuição.
Isso se aplica à classificação de intenções, roteamento de filas, seleção de políticas, marcação de conteúdo e decisão sobre qual ferramenta ou agente deve receber uma tarefa. Documentos TypeSafe suportam até 255 opções. Para conjuntos de rótulos muito grandes, sua própria recomendação é restringir o campo e então tomar uma segunda decisão, em vez de tratar centenas de escolhas quase duplicadas como um único problema plano.
Pontuação posiciona um item em uma escala ordenada
Uma pergunta de Pontuação define um intervalo ordenado — por exemplo, urgência de um a cinco ou qualidade do lead de zero a dez. Jev retorna uma pontuação junto com a distribuição sobre os valores permitidos e um sinal de confiança.
As pontuações são úteis quando a diferença entre resultados adjacentes importa. Uma pontuação de risco quatro está mais próxima de cinco do que de um; um conjunto simples de rótulos não relacionados não expressa essa ordem. Aplicações podem converter o resultado em níveis de serviço, filas de revisão, limites ou priorização.
Noul estima a probabilidade de uma afirmação.
Uma pergunta Noul solicita um valor entre zero e um: quão provável é que essa passagem responda à consulta, quão provável é que a solicitação viole uma regra, ou quão provável é que este rastreamento de agente indique uma falha? Noul retorna a probabilidade diretamente. Ao contrário de Escolha e Pontuação, a resposta atual do Noul não adiciona uma propriedade de confiança separada.
O nome estranho é menos importante do que o padrão. Em vez de forçar um modelo a dizer “sim” ou “não” em um limite arbitrário, a aplicação recebe uma probabilidade e escolhe o limite sozinha. Uma decisão de personalização inofensiva pode aceitar 0,65. Uma ação de pagamento ou segurança de alto risco pode exigir 0,98 e uma segunda verificação.
O Jev realmente tem "zero alucinações"?
TypeSafe usa uma linguagem forte em torno de alucinação porque Jev não pode inventar uma quarta categoria quando o esquema permite apenas três, retornar um parágrafo onde o código espera um número, ou improvisar um campo não reconhecido. Isso é uma melhoria significativa na confiabilidade. O forma da resposta é limitada.
Isso não significa que o julgamento seja sempre verdadeiro. Jev ainda pode escolher o rótulo errado, atribuir uma pontuação muito alta, interpretar mal uma instrução indireta ou se tornar menos confiável quando a entrada for adversarial ou cheia de material irrelevante. O próprio TypeSafe Guia de irregularidades Jev 1.13 documenta essas fraquezas.
Uma maneira precisa de dizer isso é:
- A alucinação do esquema é limitada. A saída deve se adequar ao tipo de decisão declarado.
- Erro semântico ainda é possível. Um rótulo válido ainda pode ser o rótulo errado.
- A confiança ajuda a gerenciar erros. Pode acionar revisão ou um recurso de fallback, mas não é uma prova.
Essa distinção importa para todo sistema de IA estruturado. O modo JSON em um LLM geral pode garantir campos analisáveis enquanto os valores dentro desses campos permanecem incorretos. Jev reduz ainda mais o problema ao especializar todo o modelo em torno de decisões limitadas, mas as equipes de produção ainda precisam de avaliações e limites seguros.
Quão rápido e barato é o Jev?
A página atual do modelo TypeSafe lista o Jev 1.13 em $42 por bilhão de tokens de entrada, equivalente a $0,042 por milhão de tokens de entrada. A saída é gratuita porque Jev não está gerando uma resposta longa. Nessa taxa, um milhão de solicitações de classificação de 500 tokens usaria 500 milhões de tokens de entrada e teria um custo de lista de modelos de cerca de $21, antes de quaisquer despesas com aplicação, armazenamento, rede ou revisão humana.
O post de lançamento relata 70 a 500 milissegundos de ponta a ponta para tarefas moldadas para System One, e reivindica acelerações de 40× a 200× em relação aos modelos gerais usados em suas comparações. Esses números precisam do contexto que o próprio TypeSafe fornece:
- a maioria dos testes de tempo foi realizada em laptops na Costa Oeste dos EUA;
- as quatro avaliações de fluxo de trabalho foram elaboradas pela equipe do TypeSafe;
- os rótulos de comparação foram derivados das respostas de alto nível de pensamento GPT-6 Astra e Claude Fable 5.1, em vez de rótulos dourados humanos independentes; e
- a empresa diz que os preços iniciais podem ser subsidiados e não devem ser considerados permanentes.
Em outras palavras, as evidências do lançamento são promissoras, não conclusivas. O máximo destacado—193,6× mais rápido e 444,6× mais barato—é o extremo favorável de um conjunto de tarefas conduzidas pelo fornecedor, não um fator de conversão universal para cada chamada LLM.
O que as primeiras avaliações do Jev realmente mostram
A TypeSafe publica quatro avaliações de fluxo de trabalho abrangendo classificação de incidentes de segurança, observabilidade de rastreamento de agentes, processamento de faturas e decisões de atendimento ao cliente. Cada fluxo de trabalho decompõe um comando amplo em várias perguntas tipadas e, em seguida, compara precisão, custo e tempo com uma linha de base de modelo geral.
O resultado central é menos sobre um ranking do que sobre um padrão de fluxo de trabalho. Se uma tarefa termina com um punhado de rótulos ou números, um modelo especializado pode evitar pagar um LLM geral para compor e serializar uma resposta que nunca precisou escrever. Perguntas paralelas também podem substituir várias chamadas separadas.
Há uma evidência externa útil. O engenheiro Malte Ubl escreveu que ele executou Jev contra uma avaliação de classificador existente que havia usado Gemini 2.5 Flash-Lite; nesse único teste, Jev saturou a avaliação de qualidade e rodou cerca de seis vezes mais rápido. Esse relatório é encorajador porque a avaliação ocorreu antes do Jev, mas ainda é um teste de um único desenvolvedor – não um amplo conjunto de benchmarks independentes.
Para uma explicação visual rápida, Matija Sosic publicou um Resumo de 45 segundos do Jev. Steve Krouse também compartilhou um demonstração pequena ao vivo que torna o padrão de estado e perguntas mais fácil de entender do que uma tabela de benchmarks.
As evidências são suficientes para justificar o teste do Jev. Ainda não são suficientes para declarar que o Jev supera todos os pequenos LLM, classificadores, rerankers ou motores de regras. Uma avaliação justa deve usar exemplos congelados do produto real, rótulos revisados por humanos, o mesmo caminho de rede e uma política de limiar escolhida antes de ver os resultados.
Jev vs LLMs: o que é realmente diferente?
| Dimensão | Jev / System One | LLM de uso geral |
|---|---|---|
| Principais funções | Escolher, pontuar ou estimar probabilidade | Gerar, raciocinar, explicar, programar e usar ferramentas |
| Saída | Valores tipados predefinidos | Tokens abertos, opcionalmente restritos a JSON |
| Incerteza | Distribuições de probabilidade nativas e confiança onde suportado | Normalmente não exposto como um sinal de aplicação calibrado |
| Múltiplas perguntas | Perguntas independentes avaliadas em paralelo | Frequentemente respondidas em uma sequência gerada ou várias chamadas |
| Melhor para | Decisões semânticas estreitas em grande volume | Trabalho ambíguo, criativo, de múltiplas etapas ou explicativo |
| Não pode | Escrever prosa, código ou explicações | Pode gerar todos os três |
A comparação correta, portanto, não é “O Jev pode superar um modelo de ponta?” É “Por que estamos pedindo a um modelo de ponta para fazer este trabalho em particular?” A pequeno modelo geral como GPT-5.6 Luna ou Claude Haiku 4.5 permanece mais flexível. Ele pode extrair um campo, reescrever uma mensagem, chamar uma ferramenta e explicar sua resposta na mesma solicitação. Jev abre mão dessa flexibilidade em troca de um contrato mais restrito.
Jev vs saída estruturada ou modo JSON
Saída estruturada é a alternativa familiar mais próxima. Um desenvolvedor fornece um esquema a um LLM; o provedor restringe a resposta gerada para que ela possa ser analisada. Isso é excelente quando uma aplicação precisa de um objeto rico com nomes, descrições, datas ou outros campos gerados.
Jev é mais adequado para um espaço de saída menor. As respostas já existem; o modelo apenas as seleciona ou as pontua. Há menos saída a ser gerada, a distribuição de probabilidade faz parte do produto, e toda a arquitetura é otimizada em torno da decisão. Use o modo JSON quando você precisar de conteúdo gerado dentro de uma estrutura. Considere Jev quando toda resposta válida já for conhecida.
Jev vs um classificador tradicional
Um classificador convencional pode ser extremamente rápido e barato após o treinamento. Pode ser a melhor escolha para um problema estável, de alto volume, com dados rotulados suficientes. O apelo do Jev é que ele tenta trazer a flexibilidade da linguagem natural e configuração de poucos exemplos para essa classe de trabalho sem exigir que cada equipe treine e opere um modelo separado.
O trade-off é o controle. Um classificador personalizado pode ser ajustado em torno de uma taxonomia restrita, inspecionado com métricas familiares e implantado em um ambiente privado. Jev é atualmente um serviço hospedado em acesso antecipado. As equipes devem comparar não apenas precisão e latência, mas também a localização dos dados, necessidades de re-treinamento, rotatividade de rótulos e esforço operacional.
Jev vs um reranker
Um reranker como Cohere Rerank 4 Fast pega uma consulta e documentos candidatos, e então ordena esses candidatos por relevância. Jev pode perguntar se uma passagem responde a uma pergunta ou avaliar uma passagem de acordo com um rubrica, mas não é automaticamente um modelo de reranking pronto para uso com o mesmo objetivo de treinamento e contrato específico de busca.
Para RAG, as ferramentas podem se complementar. A recuperação encontra candidatos, um reclassificador os ordena, e Jev pode tomar uma decisão limitada, como “A principal evidência é suficiente para responder?” ou “Qual tópico de política este trecho apoia?” Um modelo maior então escreve a resposta citada somente quando a camada de decisão indica que a evidência é adequada.
Onde Jev poderia ser útil
1. Roteamento de solicitações e trabalho de agentes
Jev pode classificar uma solicitação recebida, selecionar um agente especialista, avaliar a urgência e decidir se uma pessoa precisa revisá-la. Como cada saída é limitada, o orquestrador não precisa interpretar uma resposta narrativa antes de dar o próximo passo.
2. Adicionando filtros de confiança aos agentes de IA
Um agente pode propor uma ação enquanto o Jev julga separadamente se a ação corresponde ao objetivo do usuário, está dentro da política ou parece completa. Casos de baixa confiança podem ser pausados. Isso não é uma barreira de segurança completa — o modelo ainda pode ser influenciado por entradas adversariais — mas pode adicionar uma verificação semântica rápida antes que o código aplique a regra final.
3. Melhorando o RAG e a busca corporativa
Sistemas de documentos já usam camadas especializadas: um analisador como Cohere Parse ou as ferramentas de código aberto em nosso Guia Docling recuperar estrutura; embeddings recuperam candidatos; rerankers os reordenam. O Jev poderia adicionar outra decisão: se a evidência é suficiente, contraditória, sensível, desatualizada ou apropriada para um caminho de resposta específico.
4. Triagem, pontuação e operações
Leads, tíquetes de suporte, faturas, relatórios de incidentes, avaliações e rastros de agentes contêm todos linguagem não estruturada que eventualmente se transforma em uma fila ou uma pontuação. Jev foi projetado para essa conversão. O valor é maior quando a taxonomia muda frequentemente o suficiente para tornar um classificador personalizado inconveniente, mas a saída permanece limitada o suficiente para que a prosa seja desnecessária.
5. Decisões de map-reduce sobre muitos itens
Um fluxo de trabalho pode aplicar a mesma pergunta independentemente em passagens, registros, mensagens ou intervalos de rastreamento, e então deixar o código agregar os resultados. Isso mantém o modelo focado em julgamentos semânticos locais enquanto o código determinístico lida com contagem, limites e seleção final.
Onde Jev não é a ferramenta certa
TypeSafe é incomumente direto sobre os pontos irregulares do Jev. Essa transparência é útil porque um modelo especializado pode parecer amplamente inteligente em uma demonstração e falhar em uma tarefa próxima.
- Não o use para escrever. Jev não pode elaborar uma resposta, explicação, resumo ou linha de código.
- Mantenha a aritmética no código. O provedor documenta fraquezas em contagem, cálculo e precisão numérica.
- Mantenha a lógica de datas no código. Comparar datas e horários é um ponto fraco documentado.
- Faça perguntas literalmente. Instruções indiretas ou aninhadas podem reduzir a confiabilidade.
- Remova contexto irrelevante. Grandes quantidades de estado não relacionado podem prejudicar a decisão mesmo quando cabem no limite de contexto.
- Teste entradas adversariais. Injeção de prompt e instruções contraditórias ainda podem direcionar o modelo.
- Não confunda calibração com certeza. Um valor de alta confiança precisa de validação nos próprios dados do produto.
Uma boa regra é deixar fatos determinísticos para sistemas determinísticos. O código deve calcular totais, comparar carimbos de data/hora, verificar permissões, impor limites e executar efeitos colaterais. Jev deve lidar com a parte que realmente requer julgamento semântico.
Uma arquitetura prática: use Jev ao lado de um LLM.
O design mais convincente é uma cascata em vez de uma substituição:
- O código realiza verificações rigorosas. Validar autenticação, limites, campos obrigatórios, datas e regras numéricas.
- Jev toma a decisão semântica específica. Classificar a solicitação, avaliar o risco ou estimar se as evidências são suficientes.
- O fluxo de trabalho lê a incerteza. Aceitar uma decisão confiante de baixo risco, encaminhar um caso ambíguo para um modelo maior ou consultar uma pessoa.
- Um LLM lida com trabalho generativo. Escrever a resposta, pesquisar o problema, chamar ferramentas aprovadas ou explicar o resultado.
- O código possui a ação. Registre a decisão e a versão da fonte, aplique a política e faça a mudança final de estado.
Esse layout pode reservar raciocínio caro para os casos que precisam dele. Também pode tornar um agente mais fácil de auditar: o registro de decisão contém a pergunta, respostas permitidas, probabilidade, limite, rota selecionada e versão do modelo, em vez de um parágrafo opaco que outro componente interpretou.
Como avaliar o Jev antes de usá-lo em produção
- Comece com uma decisão existente. Escolha uma tarefa que já termine em um rótulo, pontuação ordenada ou probabilidade—não uma tarefa de escrita encaixada em uma demonstração de classificação.
- Congele um conjunto de teste representativo. Inclua casos fáceis, casos ambíguos, rótulos raros, entradas longas, linguagem contraditória e exemplos adversariais.
- Use rótulos revisados por humanos. Um consenso LLM pode iniciar a exploração, mas a precisão da produção deve ser medida em relação a um padrão aprovado pelas pessoas.
- Meça calibração, não apenas precisão. Agrupe previsões por probabilidade e verifique se a confiança corresponde à correção observada.
- Defina limites pelo impacto. Otimize a troca entre falso-positivo e falso-negativo para a decisão real. Uma tag de marketing e uma retenção de pagamento não devem compartilhar o mesmo limite.
- Compare o custo total da tarefa. Inclua tentativas de repetição, chamadas de fallback LLM, revisões humanas, rede e engenharia — não apenas o preço do token.
- Fixe a versão do modelo. Use
jev-1.13.0para uma avaliação reproduzível; mova parajev-latestsomente com testes de regressão. - Registre de forma segura. Registre o suficiente para depurar a decisão sem reter o texto-fonte sensível por mais tempo do que o necessário.
Acesso a Jev API em inglês simples
O Jev está disponível através do acesso antecipado API e Playground da TypeSafe. O API usa POST /v1/systemone, e o TypeSafe fornece SDKs para Python e JavaScript. Uma solicitação contém o estado compartilhado mais uma ou mais perguntas. A resposta contém os resultados tipados.
Os limites atuais de acesso antecipado publicados são 250.000 tokens de entrada por segundo e 1.200 solicitações por minuto, embora o TypeSafe diga que os limites são dinâmicos enquanto a demanda se estabiliza. Uma solicitação pode conter várias perguntas independentes, então um fluxo de trabalho pode não precisar de uma chamada de rede para cada decisão.
Os desenvolvedores devem ter em mente dois aliases. jev-latest Segue a linha estável de produção e atualmente aponta para Jev 1.13. jev-preview Destina-se ao candidato mais recente e atualmente aponta para a mesma versão. Fixe o ID numérico quando uma mudança de comportamento afetaria um fluxo de trabalho regulado ou de alto impacto.
Considerações de privacidade e empresariais
A política de privacidade da TypeSafe diz que as informações fornecidas pelos clientes não são usadas para treinar ou ajustar seus modelos. Ela também afirma que os serviços são hospedados nos Estados Unidos. A política pública não promete um prazo de retenção zero fixo para cada solicitação API; ela descreve a retenção de informações pessoais na medida do razoavelmente necessário para os fins declarados.
Isso não é o mesmo que dizer que o Jev é inadequado para dados empresariais. Significa que os compradores devem obter os termos exatos de processamento de dados, retenção, subprocessadores, exclusão, segurança e regionais que sua carga de trabalho exige. O acesso antecipado também é o momento certo para perguntar sobre compromissos de nível de serviço, registros de auditoria, avisos de versão de modelo, resposta a incidentes e garantias de capacidade.
Perguntas frequentes
O que é o Jev?
Jev é o primeiro modelo System One do TypeSafe AI. Ele transforma texto ou estado estruturado em escolhas, pontuações e probabilidades predefinidas para código de aplicação, em vez de gerar prosa aberta.
O Jev é um LLM?
A TypeSafe apresenta o Jev como uma nova categoria de modelo especializado, em vez de um LLM de uso geral. Ele entende estado em linguagem natural, mas seu trabalho é tomada de decisão limitada, não geração de texto token a token.
Quanto custa o Jev?
A TypeSafe lista atualmente o Jev 1.13 a $0,042 por milhão de tokens de entrada, sem cobrança por tokens de saída. A empresa afirma que os preços iniciais podem ser subsidiados, então compradores de produção devem verificar a taxa atual.
Quão rápido é o Jev?
A TypeSafe reporta 70–500 ms de latência de ponta a ponta para consultas adequadas ao System One. Esse é um intervalo informado pelo provedor, não um SLA universal, e geografia, carga, comprimento da entrada e design do fluxo de trabalho podem alterar o resultado.
O que são Choice, Score e Noul?
Choice seleciona entre rótulos predefinidos, Score escolhe um valor em uma escala ordenada, e Noul retorna uma probabilidade entre zero e um. Choice e Score também retornam distribuições e um valor de confiança; Noul retorna a própria probabilidade.
Jev pode alucinar?
Jev não pode inventar um resultado fora do tipo declarado, o que previne respostas malformadas ou abertas. Ainda assim, ele pode tomar uma decisão semanticamente errada, então as equipes devem avaliar precisão, calibração, comportamento adversário e limites.
Jev pode substituir o GPT ou Claude?
Não. Jev não escreve, não explica, não programa, não navega nem opera ferramentas. Ele pode substituir algumas chamadas estreitas de classificação ou pontuação e pode encaminhar casos difíceis para um modelo geral, como GPT ou Claude.
Jev é bom para RAG?
Potencialmente, como uma camada de decisão. O Jev pode avaliar se as evidências são suficientes, classificar trechos, pontuar a relevância para políticas ou autorizar uma resposta. Ele não cria embeddings, analisa documentos, reordena candidatos por padrão nem escreve a resposta final com citações.
O Jev está geralmente disponível?
Não. Jev está em acesso antecipado através do Playground da TypeSafe e API a partir de 17 de setembro de 2026.
Fontes e metodologia
Este artigo foi pesquisado em 17 de setembro de 2026. Design do produto, velocidade, custo e alegações de benchmark vêm do TypeSafe AI. lançar artigo, documentação System One, página de modelo e preços, guia de confiança, início rápido, and site de avaliação de fluxo de trabalho. As limitações vêm do guia de irregularidades Jev 1.13 do provedor; as declarações sobre o manuseio de dados vêm dele política de privacidade.
Rotulamos os resultados conduzidos pelo provedor como alegações do provedor. O resultado do classificador de Malte Ubl é incluído como um relatório de um praticante independente, não como um padrão universal. Nós não executamos o Jev nós mesmos, e não transformamos a maior velocidade ou multiplicador de custo do TypeSafe em uma alegação sobre cargas de trabalho não relacionadas. Preços, apelidos, acesso e limites iniciais podem mudar após a publicação.
O ponto principal
Jev é interessante porque questiona um hábito que se tornou normal no software de IA: enviar toda tarefa semântica para um modelo construído para escrever. Muitas decisões de produção não precisam de um ensaio. Elas precisam de um rótulo conhecido, uma pontuação ordenada ou uma probabilidade sobre a qual o código possa agir.
O primeiro lançamento do TypeSafe apresenta um caso ambicioso para essa camada especializada. O preço é pequeno, a latência reportada é medida em milissegundos, o contrato de saída é estreito, e a incerteza está disponível para a aplicação. As avaliações de lançamento e os primeiros testes de desenvolvedores fazem o Jev valer uma experimentação séria.
Os limites fazem parte da ideia, não são um detalhe posterior. O Jev não pode se explicar, não deve realizar operações aritméticas ou lógica de datas, ainda pode classificar incorretamente e continua vulnerável a contexto pobre e instruções adversárias. Ele pertence entre o código determinístico e um LLM de uso geral — e não acima de ambos.
Se essa arquitetura se mantiver em dados reais, o “modelo System One” poderia se tornar uma categoria útil. O Jev não precisa substituir o GPT, o Claude ou um classificador treinado para ser relevante. Ele só precisa lidar com um número suficiente das pequenas decisões em torno deles de forma mais rápida, mais barata e com um contrato mais limpo.