

- AIツール
- 人工知能
Jevとは何ですか?TypeSafe AIのSystem Oneモデルを解説
Jevは、散文の代わりに迅速なタイプ入力による決定を返すために作られた新しい種類のAIモデルです。ここでは、Jevがどのように機能するか、そのコスト、適合する場所、そして初期の証拠が何を示し、何を示さないかを説明します。
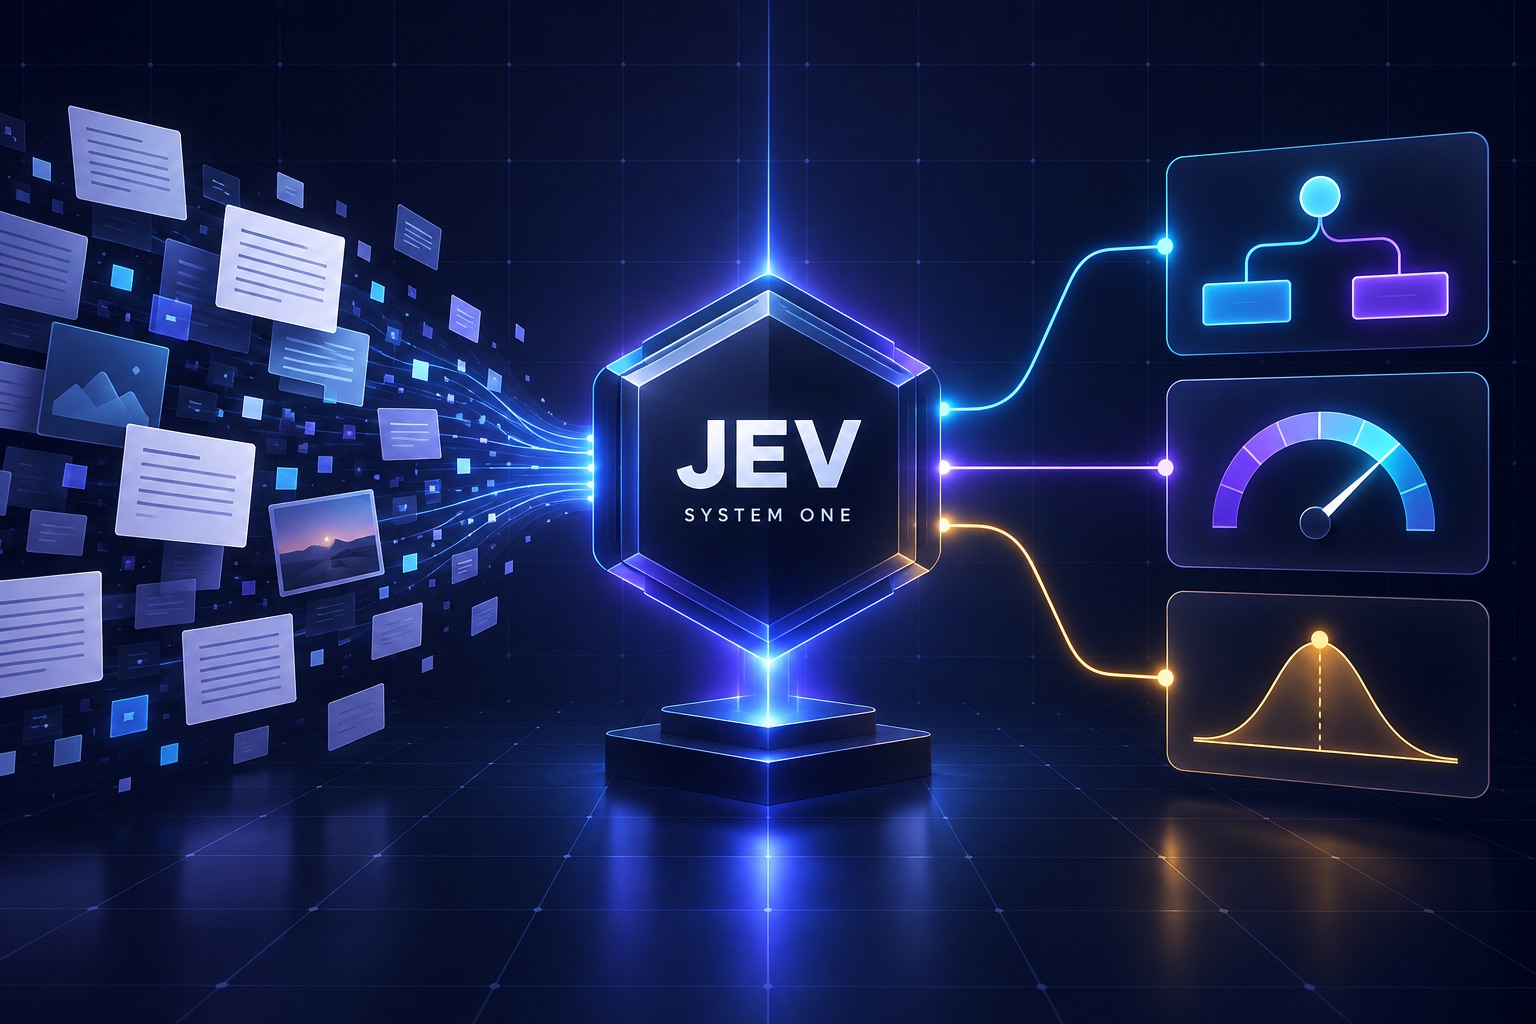
ほとんどのAIモデルは何かを言うように作られています。Jevは何かを決定し、ソフトウェアがすぐに使用できる形で答えを返すように作られています。
顧客からのメッセージが届きます。それは請求、サポート、それとも営業でしょうか?取得された文章が関連しているように見えます。それを回答モデルに送るに十分でしょうか?エージェントがアクションを提案します。そのワークフローはそれを許可すべきか、ブロックすべきか、あるいは人に確認すべきか?
これは実際には文章作成タスクではありません。それはソフトウェアの中に埋め込まれた小さな判断です。チームはしばしば、それをすでに持っている汎用言語モデルに任せます。モデルは入力を読み取り、一度に1トークンずつ応答を生成し、アプリケーションがその答えをラベル、スコア、あるいはブール値に解析します。
TypeSafe AI Jevを導入しました 2026年9月15日、異なる種類のモデルとして。この会社はそのカテゴリを呼んでいます System Oneモデル:非構造化状態が入り、制限された選択肢、スコア、確率、自信が出てきます。Jevチャットも説明もコードも書くことはありません。狭い意味の判断を下します。
それは小さな違いのように聞こえます。しかし重要な区別かもしれません。Jevの初期の速度、コスト、キャリブレーションの主張がより広範なテストを通過すれば、アプリケーションはワークフローのあらゆる小さな枝分かれに対して大規模な言語モデルを使うのをやめることができるでしょう。その結果、LLMに取って代わるものではありません。それはLLMやその周囲のソフトウェア全体に、より速い意思決定層を与えることになります。
このガイドでは、Jevとは何か、「System One」とは何か、選択、スコア、Noulの問題の仕組み、費用、ベンチマークの証拠が示す内容、そしてその制限が重要な点について説明しています。コンパクト仕様書およびファーストパーティの情報源については、 Jev 1.13 モデルページ または新しいものを閲覧することもできます AI意思決定モデルのカテゴリー.
簡単な回答 — 2026年9月17日確認済み
Jev 1.13はTypeSafe AIの最初のSystem Oneモデルです。テキスト、JSON、またはテキストと事前定義された質問の配列を受け取り、確率付きの型付けされた決定を返します。TypeSafeはこれを次のようにリストしています 入力トークン100万あたり0.042ドル 無料の出力で、典型的なエンドツーエンドの遅延を報告する 70–500 milliseconds 適したタスク向けです。これは早期アクセス版です。これらは提供者が公開した数値であり、普遍的な保証ではありません。
| Jev fact | 現在の詳細 |
|---|---|
| 開発者 | TypeSafe AI |
| 現在のモデル | Jev 1.13; API ID jev-1.13.0 |
| リリース | 2026年9月15日 |
| What it returns | 選択肢、順序付きスコア、確率、そして信頼度の信号 |
| それが返さないもの | 自由形式の散文、説明、コード、画像、音声、または動画 |
| Input capacity | 1リクエストあたり64Kトークン;状態と最長の質問を合わせて32Kまで |
| Price | 入力トークン1百万あたり$0.042;出力は無料 |
| Published speed | System One形クエリの場合、エンドツーエンドで70〜500ミリ秒 |
| Access | 早期アクセスのプレイグラウンドとAPI、PythonおよびJavaScript SDK |
What is Jev AI?
Jevは、テキストや構造化された状態に関して境界付きの判断を行うための専門的なモデルです。「JSONオブジェクトを書け」とプロンプトして、生成された応答がその形式に従うことを期待する代わりに、開発者は推論の前に可能な応答を定義します。その後、Jevはその許可された値のいずれか、またはスコアや確率を、不確実性に関する情報とともに返します。
最も簡単なメンタルモデルは、自然言語を理解し、多くの質問を同時に考慮し、どれくらい確信しているかを示すことができる非常に有能な分類器です。その説明は、Jevを小さなチャットボットとして扱うよりも有用です。それはアプリケーションの中に置かれるように設計されており、アプリケーション自体であることを目的としていません。
Jevパターン
非構造化状態 → Jev → 選択 + スコア + 確率 → アプリケーションコード
モデルは意味的判断を処理します。コードは依然としてルール、閾値、副作用、監査トレイル、フォールバックを制御します。
サポートシステムが次のようなメッセージを受け取ったとします:「昨日アップグレードしましたが、カードが二重に請求され、余分に支払った分がまだ消えていません。」1つのJevリクエストは、このメッセージが請求に関するものか、どの程度緊急か、エスカレーションすべきか、敏感なアカウント情報を含む可能性がどのくらいあるかを尋ねることができます。それぞれの質問には指定された出力形式があります。アプリケーションは段落を解析せずにチケットを振り分けることができます。
現在のエイリアス jev-latest ~に決意する jev-1.13.0. ほとんどの読者はそのIDを覚える必要はありません。そのIDが重要になるのは、主に再現可能な生産テストの場合です。より広い視点での考え方は、製品そのものです:Jevは、TypeSafeがエージェント、検索、モデレーション、運用、および顧客ワークフローに関する多くの小さな判断を処理できることを望むカテゴリの最初のメンバーです。
なぜそれを「System One」モデルと呼ぶのでしょうか?
この名前は、心理学者ダニエル・カーネマンによって普及したシステム1とシステム2のフレームワークから借用されています。システム1は迅速で直感的な判断を説明し、システム2はより遅く、熟慮された推論を説明します。この類推は、Jevが人間のように考えると主張しているわけではありません。それは、モデルが最適化されて行う仕事を説明しています。
LLMのようなフロンティア GPT-6 Astra or Claude Fable 5.1 幅広く生成的な作業のために構築されています:問題を調査し、ツールを使用し、コードを書き、トレードオフを説明したり、文書を作成したりします。Jev は意図的に範囲が狭くなっています。利用可能な状態を読み取り、小さな決定を迅速に返します。
TypeSafe はそのアーキテクチャが使用することを述べています 並列サンプラー 回答をトークンごとに生成するのではなく、そのドキュメントには、同じリクエスト内の質問は独立して並列に評価されるとも書かれています。つまり、いくつかの分類やスコアリングの質問を追加することは、一般的な LLM に順番に処理させる場合よりも遅延ペナルティがずっと小さいはずです。
その会社はJevを使用して訓練しました RLCDReinforcement Learning for Calibrated Decisionsの略です。重要なユーザー向けの目標はキャリブレーションです:多くの類似した予測の中で、80%の確率はおおよそ80%の確率で正しいはずです。キャリブレーションは個々の答えが正しいことを保証するものではありません。それは、不確実性をルーティングやしきい値に対してより有用にします。
選択、スコア、そして Noul: Jev の三つの質問タイプ
Jev は現在三つのプリミティブを公開しています。これらは一緒に、ビジネスソフトウェアの中に隠された小さな判断の大部分をカバーします。
選択は許可されたセットから選ぶ
Choice(選択)質問はJevに固定されたラベルリストを与えます:請求、技術サポート、販売、解約、またはその他。応答には選択されたラベル、利用可能な選択肢全体での確率分布、およびその分布から導かれる信頼値が含まれます。
これは意図の分類、キューの振り分け、ポリシー選択、コンテンツのタグ付け、どのツールや担当者がタスクを受け取るべきかを決定することに適しています。TypeSafeドキュメントは最大255個の選択肢までのサポートを記載しています。非常に大きなラベルセットの場合、公式のガイダンスとしては、フィールドを絞り込み、次に二次的な決定を行うことが推奨されており、数百のほぼ重複する選択肢を1つのフラットな問題として扱うべきではありません。
Score(スコア)はアイテムを順序付きのスケール上に配置します
Scoreの質問は順序付きの範囲を定義します。例えば、緊急度を1から5まで、またはリードの質を0から10まで設定する場合です。Jevは、許可された値の分布と信頼度の信号とともにスコアを返します。
スコアは、隣接する結果の差が重要な場合に有用です。リスクスコアが4であれば、1よりも5に近いことになります。単純な無関係のラベルのセットでは、その順序を表すことはできません。アプリケーションは、結果をサービスレベル、レビューキュー、閾値、または優先順位に変換することができます。
Noulは、ある文の確率を推定する
Noulの質問は、ゼロと一の間の値を求めます:この文章が質問に答える可能性はどのくらいか、リクエストが規則に違反する可能性はどのくらいか、またこのエージェントトレースが失敗を示す可能性はどのくらいか。Noulは確率を直接返します。ChoiceおよびScoreとは異なり、現在のNoulの応答には別の信頼度プロパティは追加されません。
その奇妙な名前はパターンほど重要ではありません。モデルに任意の境界で「はい」か「いいえ」と答えさせる代わりに、アプリケーションは確率を受け取り、境界を自分で選択します。無害なパーソナライズの判断では0.65を受け入れることがあります。高リスクの支払いまたはセキュリティ操作では0.98と二重チェックが必要な場合があります。
Jevは本当に「幻覚ゼロ」を実現しているのでしょうか?
TypeSafeは幻覚について強い言葉を使います。というのも、Jevはスキーマが三つしか許さない場合に四つ目のカテゴリを作ることも、コードが数値を期待する段落に文字列を返すことも、認識されないフィールドを即興で作ることもできないからです。それは意味のある信頼性の向上です。 形 応答の範囲は制限されています。
しかし、その判断が常に正しいとは限りません。Jev、誤ったラベルを選んだり、高すぎるスコアを付けたり、間接的な指示を誤解したり、対立的だったり無関係な内容で満たされた入力で信頼性が低下したりすることがあります。TypeSafe自身 Jev 1.13ギザギザ度ガイド その弱点を記録しています。
正確に言えば、次の通りです:
- スキーマ幻覚は制約されています。 出力は宣言された意思決定タイプに適合しなければなりません。
- 意味誤りはまだ起こり得ます。 有効なラベルでも間違ったラベルになり得ます。
- 自信はミスの管理に役立ちます。 それは審査やバックアップを引き起こすこともありますが、証拠にはなりません。
この区別はすべての構造化されたAIシステムにとって重要です。一般的なLLMのJSONモードは、解析可能なフィールドを保証し、その中の値は誤りのままです。Jev、モデル全体を有界の意思決定に特化させることで問題をさらに軽減しますが、生産チームは依然として評価と安全な閾値を必要とします。
Jevはどれくらい速くて安価ですか?
TypeSafeの現在のモデルページにはJev 1.13が記載されています。 入力トークンあたり42ドル、 に相当します。 100万入力トークンあたり0.042ドル.出力は無料です。なぜならJev長いレスポンスを生成しないためです。この速度なら、100万個の500トークン分類リクエストは5億個の入力トークンを使い、モデルリストコストは約 $21、アプリケーション、ストレージ、ネットワーク、または人間のレビュー費用の前に。
発射ポストの報告 70~500ミリ秒 System One向けに設計されたタスクに対するエンドツーエンドの処理で、比較に使用された一般的なモデルに対して40倍から200倍の高速化を主張しています。これらの数字は、TypeSafe自体が提供するコンテキストが必要です:
- ほとんどのタイミングテストは米国西海岸のノートパソコンで実施されました。
- 4つのワークフロー評価はTypeSafeチームによって設計されました。
- 比較ラベルは独立した人間のゴールドラベルではなく、高度な思考を行うGPT-6 AstraおよびClaude Fable 5.1の応答から導出されました。
- そして、同社は初期価格が補助される可能性があり、永続的なものとして想定すべきではないと述べています。
言い換えれば、公開時の証拠は有望ですが、決定的なものではありません。見出しの最大値—193.6倍速く、444.6倍安い—は、ベンダーが実施した一連の好ましいタスクでの結果であり、すべてのLLM呼び出しにおける普遍的な変換係数ではありません。
初期のJev評価が実際に示していること
TypeSafeは、セキュリティインシデントの分類、エージェントトレースの可観測性、請求書処理、カスタマーサービスの意思決定に関する4つのワークフロー評価を公開しています。それぞれのワークフローは、1つの広範なプロンプトをいくつかの型付き質問に分解し、精度、コスト、時間を汎用モデルのベースラインと比較します。
中心的な結果は、リーダーボードというよりもワークフローパターンに関するものです。タスクが少数のラベルや数値で終わる場合、専門モデルは、本来書く必要のなかった回答を作成して直列化するために汎用LLMのコストを支払う必要がありません。並列の質問は、いくつかの個別の呼び出しを置き換えることもできます。
ここで有用な外部の証拠が1つあります。エンジニアのMalte Ublは、既存の分類器評価に対してJevを実行したと書いています。この評価は以前にGemini 2.5 Flash-Liteを使用していました。その1回のテストでは、Jevは品質評価で飽和し、約6倍速く実行されました。 その報告書 評価はJevよりも前に行われたため励みになりますが、それでも単独開発者のテストであり、広範な独立したベンチマークスイートではありません。
簡単な視覚的説明として、マティヤ・ソシッチは以下の文書を発表しました。 45秒のJev要約.スティーブ・クラウスも 小さなライブデモ これにより、状態と質問のパターンがベンチマーク表よりも感じやすいのです。
証拠はJevテストを正当化するのに十分です。しかし、すべての小さなLLM、分類器、リランクャー、ルールエンジンJevすべてを上回っていると宣言するにはまだ十分ではありません。公正な評価は、実際の製品からの凍結例、人間によるレビュー済みラベル、同じネットワーク経路、そして結果を見る前に選択した閾値ポリシーを用いるべきです。
JevとLLM:実際に何が違うのか?
| 寸法 | Jev / System One | 汎用LLM |
|---|---|---|
| 主な仕事 | 確率を選び、スコアをつけ、または推定してください | ツールを作成し、推論し、説明し、コーディングし、使う |
| 出力 | あらかじめ定義された型付き価値 | 自由型トークン、任意でJSONに制限される |
| 不確実性 | 支持されるネイティブ確率分布と信頼度 | 通常は校正された応用信号として露出しません |
| 複数の質問があります | 独立した問題が並行して評価される | しばしば一つのシーケンスまたは複数の通話で応答されます |
| 最高に | 大量かつ狭義の意味的決定 | 曖昧で創造的、多段階的、または説明的な作業 |
| 無理だ | 散文、コード、説明を書く | 3つすべてを生成できます |
したがって、正しい比較は「Jevフロンティアモデルに勝てるか?」ではなく、「なぜフロンティアモデルにこの特定の仕事を任せているのか?」です。A GPT-5.6 Lunaのような小型汎用モデル or クロード俳句 4.5 より柔軟なままです。フィールドを抽出し、メッセージを書き換え、ツールを呼び出し、同じリクエストで答えを説明できます。Jevその柔軟性を放棄し、より厳しい契約と引き換えにします。
Jev vs 構造化出力またはJSONモード
構造化出力が最も近い代替手段です。開発者はLLMにスキーマを与え、プロバイダーは生成された応答を制約し、解析を行います。これは、名前、記述、日付、その他の生成フィールドを含むリッチなオブジェクトを必要とするアプリケーションにとって非常に役立ちます。
Jevは、より小さい出力空間に適しています。答えはすでに存在しており、モデルはそれを選択するか評価するだけです。生成する出力が少なく、確率分布が製品の一部であり、全体のアーキテクチャがその決定に基づいて最適化されています。構造の中で生成されたコンテンツが必要な場合はJSONモードを使用してください。すべての有効な答えがすでに知られている場合はJevを考慮してください。
Jevと従来の分類器
従来の分類器は、トレーニング後は非常に高速で低コストになることがあります。十分なラベル付きデータがある安定した高ボリュームの問題には最適な選択肢となるかもしれません。Jevの魅力は、各チームが個別のモデルをトレーニングして運用することを求めずに、そのクラスの作業に自然言語の柔軟性と少数ショット設定をもたらそうとする点にあります。
トレードオフは制御です。カスタム分類器は、狭い分類体系に合わせて調整でき、なじみのある指標で検査でき、プライベート環境に展開することができます。Jevは現在、ホストされた早期アクセスサービスです。チームは、精度や遅延だけでなく、データの場所、再学習の必要性、ラベルの変動、運用の手間も比較するべきです。
Jev とリランカー
リランカーの例として Cohere リランキング 4 高速 クエリと候補文書を受け取り、これらの候補を関連性の順に並べます。Jevは、ある文章が質問に答えているかどうかを尋ねたり、ルーブリックに対して文章を評価したりすることができますが、同じトレーニング目的や検索に特化した契約を持つ自動的なリランキングモデルとしては機能しません。
RAGでは、ツールは互いに補完することができます。リトリーバルは候補を見つけ、リランカーがそれらを順序付け、Jevは「上位の証拠で十分に答えられるか?」や「この文章はどの政策トピックを支持しているか?」といった制限された判断を下すことができます。その後、大きなモデルは、判断層が証拠が十分であると示した場合にのみ、引用された回答を書きます。
Jevが有用である可能性のある場所:
1. リクエストやエージェント作業のルーティング
Jevは、受信リクエストを分類し、専門エージェントを選択し、緊急度を評価し、人間が確認する必要があるかどうかを判断することができます。各出力が制限されているため、オーケストレーターは次のステップを実行する前に、物語形式の回答を解釈する必要はありません。
2. AIエージェントに信頼度ゲートを追加すること
エージェントは行動を提案することができ、Jevは別途、その行動がユーザーの目標に合っているか、ポリシー内であるか、完了しているように見えるかを判断します。自信の低い場合は一時停止することができます。これは完全なセキュリティ境界ではありません—モデルは依然として敵対的入力によって影響を受ける可能性があります—しかし、コードが最終的なルールを適用する前に高速なセマンティックチェックを追加することができます。
3. RAG とエンタープライズ検索の改善
ドキュメントシステムはすでに専門のレイヤーを使用しています:例えばパーサーのような Cohere Parse または私たちのオープンソースツールで ドクリングガイド 構造を回復する;埋め込みは候補を取得する;再ランキングはそれらの順序を並べ替える。Jev は別の判断を加えることができる:証拠が十分か、矛盾しているか、機密か、古いか、あるいは特定の回答パスに適しているか。
4. トリアージ、スコアリング、および操作
リード、サポートチケット、請求書、インシデントレポート、レビュー、エージェントトレースはすべて、最終的にキューやスコアとなる非構造化言語を含みます。Jevはその変換のために設計されています。タクソノミーが頻繁に変更されてカスタム分類器が不便になるほど頻繁に変わるが、出力が十分に制限されているため散文が不要になる場合、価値は最高になります。
5. 多くの項目に対するマップリ約の決定
ワークフローは同じ質問を、パッセージ、記録、メッセージ、またはトレーススパンに独立して適用し、その後コードが結果を集約します。これによりモデルは局所的な意味判断に焦点を当て、決定論的コードがカウント、閾値、最終選択を処理します。
適切な道具でないJev
TypeSafeはJevのギザギザしたエッジについて異例に率直に指摘しています。この透明性は有用です。なぜなら、専門モデルが一つのデモでは広く知的であって、隣接するタスクでは失敗することがあるからです。
- 書くために使用しないでください。 Jevは、返信、説明、要約、またはコードの行を作成することはできません。
- 算術演算はコード内に保持してください。 提供者は、計数、計算、数値精度の弱点を文書化しています。
- 日付のロジックはコード内に保持してください。 日付と時刻の比較は文書化された弱点です。
- 質問は文字通りに書いてください。 間接的または入れ子の指示は信頼性を低下させる可能性があります。
- 無関係なコンテキストを削除してください。 大量の無関係な状態は、コンテキスト制限に収まる場合でも意思決定に悪影響を与えることがあります。
- 敵対的な入力をテストしてください。 プロンプトインジェクションや矛盾する指示は、依然としてモデルを誘導する可能性があります。
- 校正と確実性を混同しないでください。 高い信頼度の値は、製品自身のデータで検証する必要があります。
良いルールは、決定論的な事実は決定論的なシステムに任せることです。コードは合計を計算し、タイムスタンプを比較し、権限をチェックし、制限を強制し、副作用を実行すべきです。Jevは、本当に意味的な判断を必要とする部分を扱うべきです。
実用的なアーキテクチャ:LLMのそばでJevを使用する
最も説得力のある設計は、置き換えではなくカスケードです:
- コードは厳密なチェックを行います。 認証、制限、必須フィールド、日付、数値ルールを検証します。
- Jevは限定的な意味的判断を下します。 リクエストを分類し、リスクを評価し、証拠が十分かどうかを見積もります。
- ワークフローは不確実性を読み取ります。 自信のある低リスクな判断を受け入れ、あいまいなケースはより大規模なモデルに回すか、人に確認します。
- 生成作業はLLMが担当します。 返信を書き、問題を調査し、承認されたツールを呼び出すか、結果を説明します。
- コードはその行動を所有する。 決定とソースバージョンを記録し、ポリシーを実施し、最終的な状態の変更を行います。
このレイアウトは、高価な推論をそれを必要とするケースに予約することができます。また、エージェントを監査しやすくすることもできます:意思決定の記録には、質問、許可された回答、確率、閾値、選択されたルート、およびモデルのバージョンが含まれ、他のコンポーネントが解釈した不透明な段落の代わりになります。
Jevを本番環境で使用する前に評価する方法
- 既存の決定から始める。 すでにラベル、順序付けられたスコア、または確率で終わるタスクを選んでください。分類デモに無理やり押し込まれた文章作成タスクではありません。
- 代表的なテストセットを固定する。 簡単なケース、あいまいなケース、稀なラベル、長い入力、矛盾する言語、そして敵対的な例を含める。
- 人間がレビューしたラベルを使用してください。 LLMのコンセンサスは探索をブートストラップすることができますが、生産精度は人々が承認した基準と比較して測定されるべきです。
- 精度だけでなく、較正を測定してください。 予測を確率ごとにグループ化し、信頼度が実際の正確さと一致しているか確認してください。
- 結果に基づいて閾値を設定してください。 実際の意思決定に対して、偽陽性と偽陰性のトレードオフを最適化してください。マーケティングタグと支払い保留は同じ閾値を共有すべきではありません。
- タスクの全コストを比較してください。 再試行、フォールバック LLM コール、人間によるレビュー、ネットワーキング、エンジニアリングを含めてください—トークン価格だけではありません。
- モデル版をピン留め。 使用
jev-1.13.0再現可能な評価のために;に移動しますjev-latest回帰テストのみで。 - Log safely. 必要以上に機密のソーステキストを保持せずに、意思決定をデバッグするのに十分な記録を残す。
Jev API 平易な英語でのアクセス
JevはTypeSafeの早期アクセスAPIとPlaygroundを通じて利用可能です。API用途 POST /v1/systemoneTypeSafeはPythonおよびJavaScriptのSDKも提供しています。リクエストは共有状態と1つ以上の質問を含みます。レスポンスには型付きの結果が含まれます。
現在公開されている早期アクセスの制限は、1秒あたり250,000入力トークンおよび1分あたり1,200リクエストですが、TypeSafeによれば制限は需要が落ち着くまで動的です。1つのリクエストにいくつかの独立した質問を含めることができるため、ワークフローごとに必ずしもネットワーク呼び出しが必要なわけではありません。
開発者は2つのエイリアスを念頭に置くべきです。 jev-latest - 安定したプロダクションラインに従い、現在はJev 1.13を指しています。 jev-preview - 最新候補用で、現在は同じバージョンを指しています。規制対象や影響の大きいワークフローに変化が影響する場合は、数値IDを固定してください。
プライバシーおよび企業上の考慮事項
TypeSafeのプライバシーポリシーによると、顧客の入力はモデルのトレーニングや微調整に使用されません。また、サービスはアメリカ合衆国でホストされていると記載されています。公開ポリシーでは、すべてのAPIリクエストに対して固定のゼロ保持期間を約束しているわけではなく、記載された目的のために個人情報を合理的に必要な範囲で保持することを説明しています。
それは、Jevが企業データに適さないと言っているのと同じことではありません。つまり、購入者は自分のワークロードが必要とする正確なデータ処理、保持、サブプロセッサ、削除、セキュリティ、および地域に関する条件を取得すべきだということです。早期アクセスはまた、サービスレベルのコミットメント、監査ログ、モデルバージョン通知、インシデント対応、キャパシティ保証について質問する適切な時期でもあります。
よくある質問
Jevとは何ですか?
Jevは、TypeSafe AIの最初のSystem Oneモデルです。これは、オープンエンドの文章を生成する代わりに、テキストや構造化された状態を、アプリケーションコード用の事前定義された選択肢、スコア、および確率に変換します。
JevはLLMですか?
TypeSafeは、Jevを汎用LLMではなく、新しい専門モデルのカテゴリーとして紹介します。Jevは自然言語の状態を理解しますが、その役割は逐語的なテキスト生成ではなく、制限された意思決定にあります。
Jevはいくらですか?
TypeSafeは現在、Jev 1.13を100万入力トークンあたり0.042ドルでリストしており、出力トークンの料金はかかりません。同社は初期の価格は補助金が出ている可能性があるとしているため、本番利用者は実際の料金を確認するべきです。
Jevはどれくらい高速ですか?
TypeSafeは、適切なSystem Oneクエリに対して70〜500ミリ秒のエンドツーエンドのレイテンシを報告しています。これはプロバイダーが報告した範囲であり、普遍的なSLAではなく、地理、負荷、入力の長さ、ワークフローの設計によって結果が変わる可能性があります。
Choice、Score、Noulとは何ですか?
Choiceは事前に定義されたラベルから選択し、Scoreは順序付きスケールで値を選び、Noulは0から1の間の確率を返します。ChoiceとScoreは分布と信頼度も返します;Noulは確率そのものを返します。
Jevは幻覚を起こすことがありますか?
Jevは宣言された型の外の出力を生成することはできないため、形式が壊れた応答や自由回答は防げます。それでも意味的に誤った判断をする可能性はあるため、チームは精度、校正、敵対的な振る舞い、閾値を評価する必要があります。
JevはGPTやClaudeの代わりになりますか?
いいえ。Jevは文章を書くことも説明することも、コードを書くことも、ブラウジングすることも、ツールを操作することもできません。一部の狭い分類やスコアリングの呼び出しの代わりにはなり得ますが、困難なケースはGPTやClaudeのような一般モデルにルーティングすることができます。
JevはRAGに適していますか?
場合によっては、意思決定層として。Jevは証拠が十分かどうかを判断し、文章を分類し、政策的関連性を評価し、回答をゲート化することができます。埋め込みの作成、文書の解析、候補者のデフォルトでのランク付け、最終的な引用回答の作成は行いません。
Jev一般的に利用可能ですか?
いいえ。Jev は TypeSafe の Playground を通じて早期アクセス可能であり、API は 2026 年 9 月 17 日時点で利用可能です。
情報源と方法論
この記事の調査は2026年9月17日に行われました。製品のデザイン、速度、コスト、およびベンチマークの主張はTypeSafe AIからのものです。 launch article, System One のドキュメント, モデルと価格ページ, confidence guide, quickstart, and ワークフロー評価サイト. 制限はプロバイダーのJev 1.13ジャギーガイドによるものであり、データ処理に関する声明はそのガイドから出ています privacy policy.
私たちは、プロバイダー運営の結果をプロバイダーの主張としてラベル付けします。Malte Ublの分類器の結果は、普遍的なベンチマークとしてではなく、独立した実務者のレポートの1つとして含まれています。私たちはJevを自分で実行しておらず、TypeSafeの最高速度やコスト乗数を無関係のワークロードに関する主張に変換することはありません。価格、別名、アクセス、および初期制限は、公開後に変更される可能性があります。
The bottom line
Jevは興味深いです。なぜなら、それはAIソフトウェアで当たり前になってしまった習慣、つまりすべての意味的なタスクを文章生成用に作られたモデルに送るという習慣に疑問を投げかけるからです。多くの実運用上の判断は、エッセイを必要としません。それらは、既知のラベル、順序付けされたスコア、またはコードが作動できる確率を必要とします。
TypeSafeの最初のリリースは、その専門層に対して野心的な主張をしています。価格は非常に低く、報告されている遅延はミリ秒単位で測定され、出力の契約は限定的であり、不確実性はアプリケーション側で利用可能です。ローンチ評価と初期の開発者テストにより、Jevは真剣な実験に値します。
制限はアイデアの一部であり、後付けではありません。Jevは自分自身を説明できず、算術や日付の論理を行うべきではなく、誤分類する可能性があり、文脈の不足や攻撃的な指示に対して脆弱なままです。それは決定論的コードと汎用のLLMの間に位置するものであり、どちらの上でもありません。
もしそのアーキテクチャが実データでも持つなら、「System Oneモデル」は有用なカテゴリーになる可能性があります。Jevは、GPT、Claude、または訓練済み分類器を置き換える必要はありません。それが重要になるためには、周囲の小さな意思決定のいくつかをより速く、より安く、より明確な契約で処理できるだけで十分です。