

- KI-Tools
- Künstliche Intelligenz
Was ist Jev? Das System One Modell von TypeSafe AI erklärt
Jev ist eine neue Art von KI-Modell, die darauf ausgelegt ist, schnelle, getippte Entscheidungen statt Prosa zu liefern. So funktioniert System One, was es kostet, wo es hingehört und was die frühen Beweise beweisen – und was nicht.
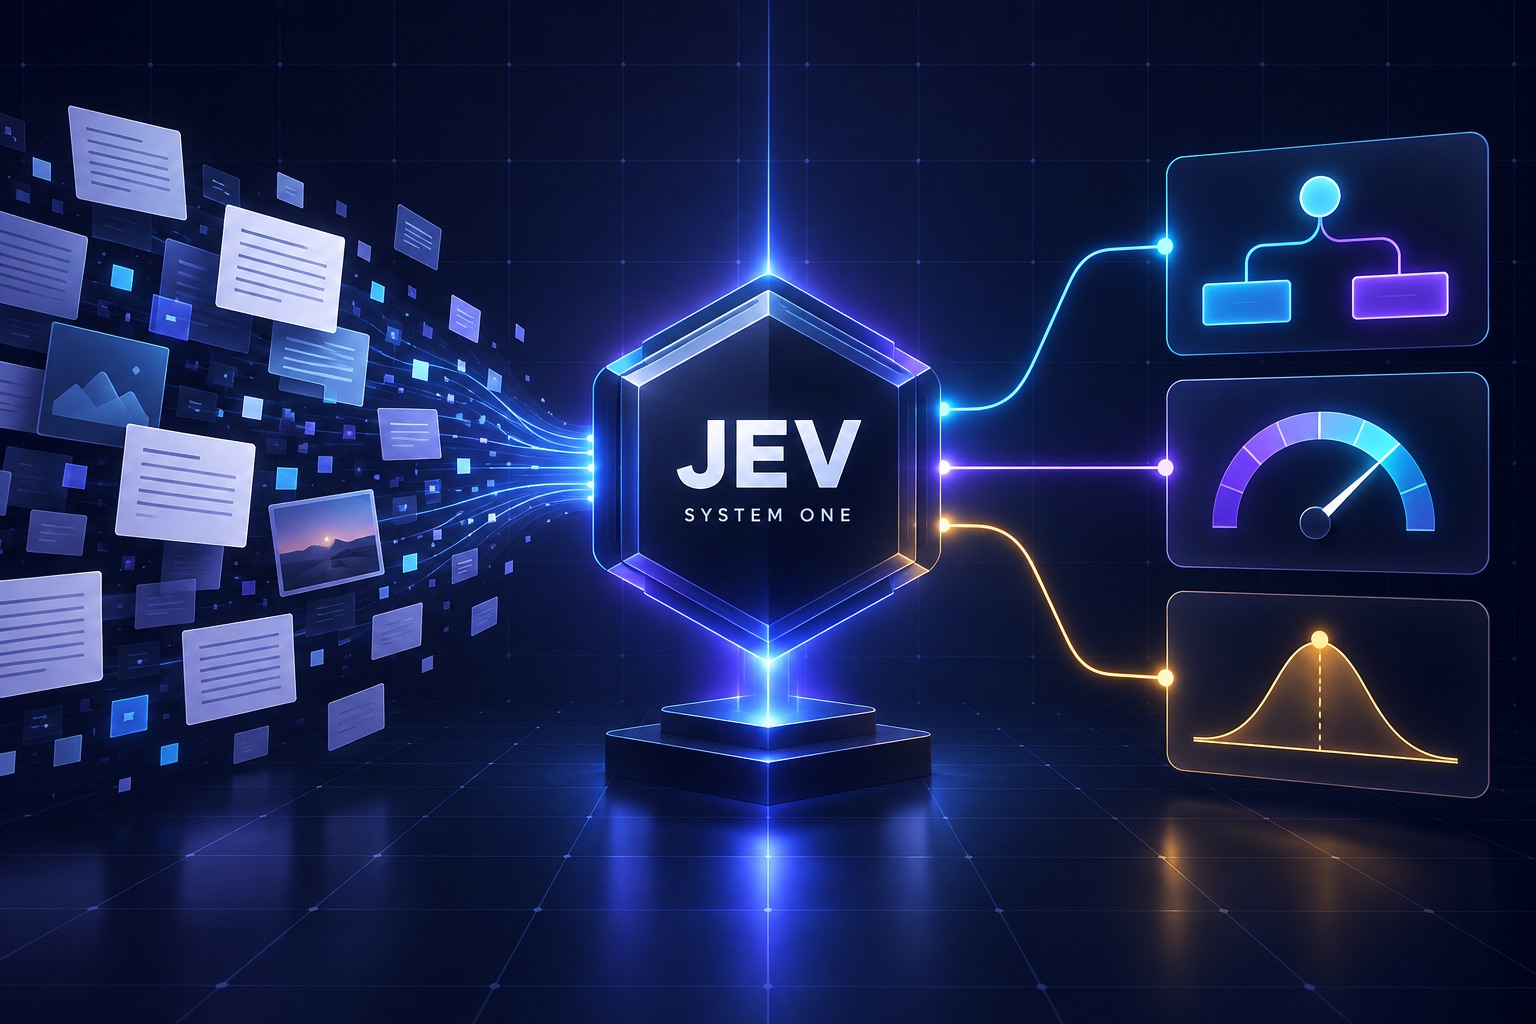
Die meisten KI-Modelle sind darauf ausgelegt, etwas zu sagen. Jev ist darauf ausgelegt, etwas zu entscheiden – und die Antwort in einer Form zurückzugeben, die Software sofort verwenden kann.
Eine Kundenanfrage kommt an. Geht es um Abrechnung, Support oder Verkauf? Ein abgerufener Abschnitt scheint relevant zu sein. Ist er stark genug, um an das Antwortmodell gesendet zu werden? Ein Agent schlägt eine Aktion vor. Sollte der Workflow dies erlauben, blockieren oder eine Person fragen?
Dies sind eigentlich keine Schreibaufgaben. Es sind kleine Urteile, die in Software eingebettet sind. Teams übergeben sie oft einem allgemeinen Sprachmodell, weil dies das KI-Tool ist, das sie bereits haben. Das Modell liest die Eingabe, erzeugt eine Antwort Token für Token, und die Anwendung analysiert die Antwort zurück in ein Label, einen Wert oder ein Boolean.
TypeSafe AI stellte Jev vor am 15. September 2026 als eine andere Art von Modell. Das Unternehmen nennt die Kategorie System One-Modelle: unstrukturierter Zustand geht hinein, während begrenzte Auswahlmöglichkeiten, Bewertungen, Wahrscheinlichkeiten und Vertrauen herauskommen. Jev chattet nicht, erklärt nicht und schreibt keinen Code. Es trifft enge semantische Entscheidungen.
Das klingt wie ein kleiner Unterschied. Es könnte ein wichtiger sein. Wenn die frühen Angaben von Jev zu Geschwindigkeit, Kosten und Kalibrierung breiteren Tests standhalten, könnten Anwendungen aufhören, ein großes Sprachmodell für jeden kleinen Zweig eines Workflows zu verwenden. Das Ergebnis würde ein LLM nicht ersetzen. Es würde dem LLM – und der übrigen umgebenden Software – eine schnellere Entscheidungsebene bieten.
Dieser Leitfaden erklärt, was Jev ist, was „System One“ bedeutet, wie seine Choice-, Score- und Noul-Fragen funktionieren, wie viel es kostet, was die Benchmark-Beweise zeigen und wo seine Einschränkungen relevant sind. Für die kompakten Spezifikationen und Quellen aus erster Hand siehe die Jev 1.13-Modellseite oder durchsuchen Sie die neue Kategorie von KI-Entscheidungsmodellen.
Schnelle Antwort — überprüft am 17. September 2026
Jev 1.13 ist TypeSafe AIs erstes System One-Modell. Es akzeptiert Text, JSON oder Arrays aus Text plus vordefinierte Fragen und gibt dann typisierte Entscheidungen mit Wahrscheinlichkeiten zurück. TypeSafe listet es auf 0,042 $ pro Million Eingabetokens mit kostenlosem Output und meldet typische End-to-End-Latenz von 70–500 Millisekunden für geeignete Aufgaben. Es befindet sich im Early Access. Dies sind vom Anbieter veröffentlichte Zahlen, keine universellen Garantien.
| Jev-Fakt | Aktuelle Details |
|---|---|
| Entwickler | TypeSafe AI |
| Aktuelles Modell | Jev 1.13; API-ID jev-1.13.0 |
| Veröffentlichung | 15. September 2026 |
| Was es zurückgibt | Auswahlmöglichkeiten, ordinal Punktzahlen, Wahrscheinlichkeiten und Vertrauenssignale |
| Was es nicht zurückgibt | Offenen Prosa, Erklärungen, Code, Bilder, Audio oder Video |
| Eingabekapazität | 64K Tokens pro Anfrage; Zustand plus die längste Frage bis zu 32K |
| Preis | 0,042 $ pro Million Eingabetokens; Ausgabe ist kostenlos |
| Veröffentlichungsgeschwindigkeit | 70–500 ms End-to-End für System One-förmige Abfragen |
| Zugang | Frühzugang Playground und API mit Python- und JavaScript-SDKs |
Was ist Jev AI?
Jev ist ein Spezialistenmodell für die Abgabe begrenzter Beurteilungen über Text oder strukturierten Zustand. Anstatt es aufzufordern, ein „JSON-Objekt zu schreiben“ und zu hoffen, dass die generierte Antwort dem Format folgt, definiert ein Entwickler die mögliche Antwort vor der Inferenz. Jev gibt dann einen dieser erlaubten Werte – oder eine Punktzahl bzw. Wahrscheinlichkeit – zusammen mit Informationen über die Unsicherheit zurück.
Das einfachste mentale Modell ist ein sehr fähiger Klassifizierer, der natürliche Sprache verstehen, viele Fragen gleichzeitig berücksichtigen und seine Sicherheit zeigen kann. Diese Beschreibung ist nützlicher, als Jev als kleinen Chatbot zu betrachten. Es ist dafür entwickelt, innerhalb einer Anwendung zu arbeiten, nicht die Anwendung selbst zu sein.
Das Jev-Muster
Unstrukturierter Zustand → Jev → Auswahl + Punktzahl + Wahrscheinlichkeit → Anwendungscode
Das Modell übernimmt das semantische Urteil. Der Code steuert weiterhin die Regel, den Schwellenwert, die Nebenwirkung, die Prüfspuren und die Rückfalloption.
Angenommen, ein Support-System erhält: „Ich habe gestern ein Upgrade durchgeführt, aber meine Karte wurde zweimal belastet und die zusätzliche Zahlung ist immer noch nicht verschwunden.“ Eine Jev-Anfrage könnte fragen, ob die Nachricht die Abrechnung betrifft, wie dringend sie erscheint, ob sie eskaliert werden sollte und wie wahrscheinlich es ist, dass sie sensible Kontoinformationen enthält. Jede Frage hat eine deklarierte Ausgabeform. Die Anwendung kann das Ticket weiterleiten, ohne einen Absatz zu analysieren.
Der aktuelle Alias jev-latest löst sich auf jev-1.13.0. Die meisten Leser müssen sich diese ID nicht merken; sie ist hauptsächlich für reproduzierbare Produktionstests von Bedeutung. Die breitere Idee ist das Produkt: Jev ist das erste Mitglied einer Kategorie, von der TypeSafe hofft, dass sie die vielen kleinen Entscheidungen rund um Agenten, Suche, Moderation, Betrieb und Kunden-Workflows übernehmen wird.
Warum wird es ein „System One“-Modell genannt?
Der Name leitet sich von der System-1- und System-2-Darstellung ab, die vom Psychologen Daniel Kahneman populär gemacht wurde. System 1 beschreibt schnelle, intuitive Urteile; System 2 beschreibt langsamere, überlegte Schlussfolgerungen. Die Analogie ist keine Behauptung, dass Jev wie ein Mensch denkt. Sie beschreibt die Aufgabe, für die das Modell optimiert ist.
Ein frontier LLM wie GPT-6 Astra oder Claude Fable 5.1 wird für breite, generative Arbeit entwickelt: ein Problem untersuchen, Werkzeuge verwenden, Code schreiben, Abwägungen erklären oder ein Dokument erstellen. Jev ist absichtlich enger gefasst. Es liest den verfügbaren Zustand und gibt schnell eine kleine Entscheidung zurück.
TypeSafe sagt, dass die Architektur eine paralleler Sampler anstatt eine Antwort Token für Token zu erzeugen. In seiner Dokumentation wird auch gesagt, dass Fragen in derselben Anfrage unabhängig und parallel ausgewertet werden. Das bedeutet, dass das Hinzufügen mehrerer Klassifizierungs- oder Bewertungsfragen eine viel kleinere Latenzstrafe haben sollte, als wenn man eine allgemeine LLM nacheinander bearbeiten lässt.
Das Unternehmen hat Jev trainiert unter Verwendung von RLCD, kurz für Reinforcement Learning for Calibrated Decisions. Das wichtige benutzerorientierte Ziel ist die Kalibrierung: Bei vielen ähnlichen Vorhersagen sollte eine 80%-Wahrscheinlichkeit ungefähr 80% der Zeit korrekt sein. Kalibrierung verspricht nicht, dass eine einzelne Antwort korrekt ist. Sie macht die Unsicherheit nützlicher für Routing und Schwellenwerte.
Choice, Score und Noul: die drei Fragetypen von Jev
Jev bietet derzeit drei Primitive. Gemeinsam decken sie einen großen Teil der kleinen Urteile ab, die in Geschäftsanwendungen verborgen sind.
Auswahl wählt aus einer erlaubten Menge aus
Eine Choice-Frage gibt Jev eine feste Liste von Labels: Abrechnung, technischer Support, Verkauf, Stornierung oder etwas anderes. Die Antwort enthält das ausgewählte Label, die Wahrscheinlichkeitsverteilung über die verfügbaren Optionen und einen aus dieser Verteilung abgeleiteten Vertrauenswert.
Dies passt zur Intent-Klassifizierung, zur Warteschlangen-Zuweisung, zur Richtlinienauswahl, zur Inhaltskennzeichnung und zur Entscheidung, welches Tool oder welcher Agent eine Aufgabe erhalten soll. TypeSafe-Dokumente unterstützen bis zu 255 Auswahlmöglichkeiten. Für sehr große Label-Mengen lautet die eigene Empfehlung, das Feld einzugrenzen und dann eine zweite Entscheidung zu treffen, anstatt Hunderte von nahezu identischen Auswahlmöglichkeiten als ein flaches Problem zu behandeln.
Score platziert ein Element auf einer geordneten Skala
Eine Score-Frage definiert einen geordneten Bereich – zum Beispiel Dringlichkeit von eins bis fünf oder Lead-Qualität von null bis zehn. Jev liefert einen Score zusammen mit der Verteilung über die erlaubten Werte und einem Vertrauenssignal.
Scores sind nützlich, wenn der Unterschied zwischen benachbarten Ergebnissen von Bedeutung ist. Ein Risikowert von vier ist näher an fünf als an eins; eine einfache Menge von nicht zusammenhängenden Labels drückt diese Reihenfolge nicht aus. Anwendungen können das Ergebnis in Servicelevels, Überprüfungsschlangen, Schwellenwerte oder Priorisierungen umwandeln.
Noul schätzt die Wahrscheinlichkeit einer Aussage.
Eine Noul-Frage verlangt einen Wert zwischen null und eins: wie wahrscheinlich ist es, dass dieser Abschnitt die Anfrage beantwortet, wie wahrscheinlich ist es, dass die Anfrage eine Regel verletzt, oder wie wahrscheinlich ist es, dass diese Agenten-Spur auf einen Fehler hinweist? Noul liefert die Wahrscheinlichkeit direkt. Anders als bei Choice und Score fügt die aktuelle Noul-Antwort keine separate Vertrauenseigenschaft hinzu.
Der seltsame Name ist weniger wichtig als das Muster. Anstatt ein Modell zu zwingen, an einer beliebigen Grenze „ja“ oder „nein“ zu sagen, erhält die Anwendung eine Wahrscheinlichkeit und wählt die Grenze selbst aus. Eine harmlose Personalisierungsentscheidung könnte 0,65 akzeptieren. Eine hochriskante Zahlungs- oder Sicherheitsmaßnahme könnte 0,98 und eine zweite Prüfung erfordern.
Hat Jev wirklich „null Halluzinationen“?
TypeSafe verwendet strenge Formulierungen in Bezug auf Halluzinationen, weil Jev keine vierte Kategorie erfinden kann, wenn das Schema nur drei zulässt, keinen Absatz zurückgeben kann, wenn der Code eine Zahl erwartet, oder ein nicht erkennbares Feld improvisieren kann. Das ist eine bedeutsame Verbesserung der Zuverlässigkeit. Die Form der Antwort beschränkt ist.
Das bedeutet nicht, dass das Urteil immer wahr ist. Jev kann immer noch das falsche Etikett wählen, eine zu hohe Punktzahl vergeben, eine indirekte Anweisung missverstehen oder weniger zuverlässig werden, wenn die Eingabe feindlich oder voller irrelevanter Inhalte ist. TypeSafe's eigene Jev 1.13 Rauheit Leitfaden dokumentiert diese Schwächen.
Eine präzise Art, es zu sagen, ist:
- Schematische Halluzination ist eingeschränkt. Die Ausgabe muss dem deklarierten Entscheidungstyp entsprechen.
- Semantische Fehler sind weiterhin möglich. Ein gültiges Label kann immer noch das falsche Label sein.
- Vertrauen hilft, Fehler zu bewältigen. Es kann eine Überprüfung oder einen Rückgriff auslösen, aber es ist kein Beweis.
Diese Unterscheidung ist für jedes strukturierte KI-System wichtig. Der JSON-Modus in einem allgemeinen LLM kann parsebare Felder garantieren, während die Werte innerhalb dieser Felder weiterhin fehlerhaft bleiben. Jev verringert das Problem weiter, indem das gesamte Modell auf begrenzte Entscheidungen spezialisiert wird, aber Produktionsteams benötigen dennoch Bewertungen und sichere Schwellenwerte.
Wie schnell und kostengünstig ist Jev?
Die aktuelle Modellseite von TypeSafe listet Jev 1.13 bei 42 Dollar pro Milliarde Eingabetoken, gleichbedeutend mit 0,042 $ pro Million Eingabetokens. Die Ausgabe ist kostenlos, da Jev keine lange Antwort generiert. Bei dieser Rate würden eine Million 500-Token-Klassifizierungsanfragen 500 Millionen Eingabetoken verwenden und Kosten für die Modellliste von etwa $21, vor jeglichen Anwendungs-, Speicher-, Netzwerk- oder menschlichen Überprüfungsaufwendungen verursachen.
Der Startbeitrag berichtet 70 bis 500 Millisekunden End-to-End für Aufgaben, die für System One gestaltet sind, und behauptet 40× bis 200× Geschwindigkeitssteigerungen gegenüber den allgemeinen Modellen, die in den Vergleichen verwendet werden. Diese Zahlen benötigen den Kontext, den TypeSafe selbst bietet:
- Die meisten Zeitmessungstests wurden von Laptops an der US-Westküste durchgeführt;
- Die vier Workflow-Bewertungen wurden vom TypeSafe-Team entworfen;
- Die Vergleichsetiketten wurden aus den hochdenkenden GPT-6 Astra- und Claude Fable 5.1-Antworten abgeleitet und nicht aus unabhängigen menschlichen Goldetiketten; und
- Das Unternehmen sagt, dass frühe Preise subventioniert sein könnten und nicht als dauerhaft angenommen werden sollten.
Mit anderen Worten, die Startnachweise sind vielversprechend, aber nicht schlüssig. Das Schlagzeilenmaximum – 193,6× schneller und 444,6× günstiger – ist das günstige Ende einer Reihe von vom Anbieter durchgeführten Aufgaben, nicht ein universeller Umrechnungsfaktor für jeden LLM-Aufruf.
Was die frühen Jev-Bewertungen tatsächlich zeigen
TypeSafe veröffentlicht vier Workflow-Evaluationen, die Sicherheitsvorfallklassifikation, Agenten-Trace-Observabilität, Rechnungsverarbeitung und Kundenservice-Entscheidungen abdecken. Jeder Workflow zerlegt eine breite Eingabeaufforderung in mehrere getippte Fragen und vergleicht dann Genauigkeit, Kosten und Zeit mit einer allgemeinen Modellbasislinie.
Das zentrale Ergebnis ist weniger eine Bestenliste als vielmehr ein Workflow-Muster. Wenn eine Aufgabe mit wenigen Labels oder Zahlen endet, kann ein Spezialistenmodell vermeiden, eine allgemeine LLM zu zahlen, um eine Antwort zu verfassen und zu serialisieren, die es nie hätte schreiben müssen. Parallele Fragen können auch mehrere separate Aufrufe ersetzen.
Es gibt ein nützliches Stück externer Beweise. Ingenieur Malte Ubl schrieb, dass er Jev gegen eine bestehende Klassifikatorbewertung laufen ließ, die Gemini 2.5 Flash-Lite verwendet hatte; in diesem einen Test sättigte Jev die Qualitätsbewertung und lief etwa sechsmal schneller. Dieser Bericht ist ermutigend, weil die Bewertung vor Jev durchgeführt wurde, aber es ist immer noch ein Test eines einzelnen Entwicklers – keine umfassende unabhängige Benchmark-Suite.
Für eine schnelle visuelle Erklärung veröffentlichte Matija Sosic eine 45-Sekunden Jev-Zusammenfassung. Steve Krouse teilte auch eine kleine Live-Demo , die es einfacher macht, das Muster von Zustand und Fragen zu erfassen als eine Benchmark-Tabelle.
Die Beweise sind ausreichend, um Tests von Jev zu rechtfertigen. Sie sind jedoch noch nicht ausreichend, um zu erklären, dass Jev jeden kleinen LLM, Klassifikator, Rangierer oder Regel-Engine übertrifft. Eine faire Bewertung sollte gefrorene Beispiele aus dem tatsächlichen Produkt, menschlich überprüfte Labels, denselben Netzwerkpfad und eine vor der Ergebniserhebung gewählte Schwellenrichtlinie verwenden.
Jev vs LLMs: was ist tatsächlich anders?
| Dimension | Jev / System One | Allzweck-LLM |
|---|---|---|
| Hauptaufgabe | Auswählen, bewerten oder Wahrscheinlichkeit schätzen | Generieren, begründen, erklären, programmieren und Werkzeuge verwenden |
| Ausgabe | Vordefinierte typisierte Werte | Offene Token, optional eingeschränkt auf JSON |
| Unsicherheit | Native Wahrscheinlichkeitsverteilungen und Vertrauen, sofern unterstützt | Normalerweise nicht als kalibriertes Anwendungssignal sichtbar |
| Mehrere Fragen | Unabhängige Fragen werden parallel bewertet | Oft in einer generierten Sequenz oder mehreren Aufrufen beantwortet |
| Am besten geeignet für | Hochvolumige, eng gefasste semantische Entscheidungen | Mehrdeutige, kreative, mehrstufige oder erklärende Arbeiten |
| Kann nicht | Prosa, Code oder Erklärungen schreiben | Kann alle drei generieren |
Der richtige Vergleich lautet daher nicht „Kann Jev ein Spitzenmodell schlagen?“ Sondern „Warum bitten wir ein Spitzenmodell, diese bestimmte Aufgabe zu erledigen?“ A kleines generelles Modell wie GPT-5.6 Luna oder Claude Haiku 4.5 bleibt flexibler. Es kann ein Feld extrahieren, eine Nachricht umschreiben, ein Werkzeug aufrufen und seine Antwort in derselben Anfrage erklären. Jev gibt diese Flexibilität im Austausch für einen engeren Vertrag auf.
Jev vs strukturiertes Ausgabe- oder JSON-Modus
Strukturierte Ausgabe ist die nächstliegende vertraute Alternative. Ein Entwickler gibt einem LLM ein Schema vor; der Anbieter begrenzt die generierte Antwort so, dass sie geparst werden kann. Dies ist hervorragend, wenn eine Anwendung ein reichhaltiges Objekt mit Namen, Beschreibungen, Daten oder anderen generierten Feldern benötigt.
Jev ist besser auf einen kleineren Ausgaberaum abgestimmt. Die Antworten existieren bereits; das Modell wählt sie nur aus oder bewertet sie. Es gibt weniger auszugeben, die Wahrscheinlichkeitsverteilung ist Teil des Produkts, und die gesamte Architektur ist auf die Entscheidung optimiert. Verwenden Sie den JSON-Modus, wenn Sie generierte Inhalte innerhalb einer Struktur benötigen. Ziehen Sie Jev in Betracht, wenn jede gültige Antwort bereits bekannt ist.
Jev vs. ein traditioneller Klassifikator
Ein herkömmlicher Klassifikator kann nach dem Training extrem schnell und kostengünstig sein. Er kann die beste Wahl für ein stabiles, volumenstarkes Problem mit genügend gekennzeichneten Daten sein. Der Reiz von Jev liegt darin, dass er versucht, natürliche Sprachflexibilität und Few-Shot-Setup in diese Art von Arbeit zu bringen, ohne dass jedes Team ein separates Modell trainieren und betreiben muss.
Der Kompromiss ist Kontrolle. Ein benutzerdefinierter Klassifikator kann auf eine enge Taxonomie abgestimmt, mit bekannten Metriken überprüft und in einer privaten Umgebung eingesetzt werden. Jev ist derzeit ein gehosteter Early-Access-Dienst. Teams sollten nicht nur Genauigkeit und Latenz vergleichen, sondern auch den Standort der Daten, den Bedarf an Nachschulungen, die Fluktuation von Labels und den Betriebsaufwand.
Jev vs. ein Reranker
Ein Reranker wie Cohere Rerank 4 Fast nimmt eine Abfrage und Kandidatendokumente und ordnet diese Kandidaten dann nach Relevanz. Jev kann fragen, ob ein Absatz eine Frage beantwortet, oder einen Absatz anhand einer Bewertungsrichtlinie bewerten, aber es ist nicht automatisch ein sofort einsetzbares Reranking-Modell mit demselben Trainingsziel und vertragsbezogenen Suchverhalten.
Für RAG können die Werkzeuge einander ergänzen. Retrieval findet Kandidaten, ein Reranker ordnet sie, und Jev kann eine begrenzte Entscheidung treffen, wie zum Beispiel „Reichen die besten Beweise aus, um zu antworten?“ oder „Welches politische Thema unterstützt dieser Abschnitt?“ Ein größeres Modell schreibt dann die zitierte Antwort nur, wenn die Entscheidungsschicht sagt, dass die Beweise ausreichend sind.
Wo Jev nützlich sein könnte
1. Weiterleitung von Anfragen und Agentenarbeit
Jev kann eine eingehende Anfrage klassifizieren, einen Spezialagenten auswählen, die Dringlichkeit bewerten und entscheiden, ob eine Person sie überprüfen muss. Da jede Ausgabe begrenzt ist, muss der Orchestrator eine narrative Antwort nicht interpretieren, bevor er den nächsten Schritt unternimmt.
2. Hinzufügen von Vertrauenssperren zu KI-Agenten
Ein Agent kann eine Handlung vorschlagen, während Jev separat beurteilt, ob die Handlung mit dem Ziel des Benutzers übereinstimmt, innerhalb der Richtlinien liegt oder vollständig erscheint. Fälle mit geringer Zuverlässigkeit können pausiert werden. Dies ist keine vollständige Sicherheitsgrenze – das Modell kann immer noch durch feindliche Eingaben beeinflusst werden – aber es kann eine schnelle semantische Prüfung hinzufügen, bevor Code die endgültige Regel durchsetzt.
3. Verbesserung von RAG und der Unternehmenssuche
Dokumentensysteme verwenden bereits spezialisierte Schichten: einen Parser wie Cohere Parse oder die Open-Source-Tools in unserem Docling-Anleitung strukturelle Wiederherstellung; Einbettungen rufen Kandidaten ab; Rangierer ordnen sie neu. Jev könnte eine weitere Entscheidung hinzufügen: ob die Beweise ausreichend, widersprüchlich, sensibel, veraltet oder für einen bestimmten Antwortpfad geeignet sind.
4. Triage, Bewertung und Betrieb
Leads, Support-Tickets, Rechnungen, Vorfallberichte, Bewertungen und Agenten-Traces enthalten alle unstrukturierte Sprache, die letztendlich zu einer Warteschlange oder einer Punktzahl wird. Jev ist für diese Umwandlung konzipiert. Der Nutzen ist am größten, wenn sich die Taxonomie oft genug ändert, um einen benutzerdefinierten Klassifikator unpraktisch zu machen, die Ausgabe jedoch begrenzt genug bleibt, dass Prosa nicht erforderlich ist.
5. Map-Reduce-Entscheidungen über viele Elemente
Ein Arbeitsablauf kann dieselbe Frage unabhängig über Passagen, Datensätze, Nachrichten oder Trace-Spans anwenden und dann den Code die Ergebnisse aggregieren lassen. Dies hält das Modell auf lokale semantische Bewertungen fokussiert, während deterministischer Code Zählen, Schwellenwerte und die Endauswahl übernimmt.
Wo Jev nicht das richtige Werkzeug ist
TypeSafe ist ungewöhnlich direkt bezüglich der unregelmäßigen Kanten von Jev. Diese Transparenz ist nützlich, weil ein spezialisiertes Modell in einer Demo breit intelligent erscheinen kann und bei einer benachbarten Aufgabe versagt.
- Verwenden Sie es nicht zum Schreiben. Jev kann keine Antwort, Erklärung, Zusammenfassung oder Codezeile entwerfen.
- Halten Sie die Arithmetik im Code. Der Anbieter dokumentiert Schwächen beim Zählen, Rechnen und bei der numerischen Genauigkeit.
- Halten Sie die Datumslogik im Code. Der Vergleich von Daten und Zeiten ist ein dokumentierter Schwachpunkt.
- Schreiben Sie Fragen wörtlich. Indirekte oder verschachtelte Anweisungen können die Zuverlässigkeit verringern.
- Entfernen Sie irrelevanten Kontext. Große Mengen an nicht zusammenhängendem Zustand können die Entscheidung beeinträchtigen, auch wenn sie in das Kontextlimit passen.
- Testen Sie feindliche Eingaben. Prompt-Injektion und widersprüchliche Anweisungen können das Modell weiterhin steuern.
- Kalibrierung nicht mit Sicherheit verwechseln. Ein hoher Vertrauenswert muss auf den eigenen Daten des Produkts validiert werden.
Eine gute Regel ist, deterministische Fakten deterministischen Systemen zu überlassen. Code sollte Summen berechnen, Zeitstempel vergleichen, Berechtigungen prüfen, Limits durchsetzen und Nebeneffekte ausführen. Jev sollte den Teil übernehmen, der wirklich semantisches Urteilsvermögen erfordert.
Eine praxisnahe Architektur: Verwenden Sie Jev neben einem LLM.
Das überzeugendste Design ist eine Kaskade statt eines Ersatzes:
- Der Code führt harte Prüfungen durch. Überprüfen Sie Authentifizierung, Limits, erforderliche Felder, Daten und numerische Regeln.
- Jev trifft die enge semantische Entscheidung. Klassifizieren Sie die Anfrage, bewerten Sie das Risiko oder schätzen Sie ein, ob die Beweise ausreichend sind.
- Der Workflow liest Unsicherheit. Akzeptieren Sie eine zuversichtliche Niedrigrisikoeinschätzung, leiten Sie einen zweideutigen Fall an ein größeres Modell weiter oder fragen Sie eine Person.
- Ein LLM übernimmt generative Arbeit. Schreiben Sie die Antwort, recherchieren Sie das Problem, rufen Sie genehmigte Werkzeuge auf oder erklären Sie das Ergebnis.
- Der Code übernimmt die Aktion. Protokollieren Sie die Entscheidung und die Quellversion, setzen Sie die Richtlinie durch und führen Sie die endgültige Zustandsänderung durch.
Dieses Layout kann teures Nachdenken für die Fälle vorbehalten, die es benötigen. Es kann auch einen Agenten leichter überprüfbar machen: der Entscheidungsdatensatz enthält die Frage, erlaubte Antworten, Wahrscheinlichkeit, Schwellenwert, ausgewählten Pfad und Modellversion anstelle eines undurchsichtigen Absatzes, den eine andere Komponente interpretiert hat.
Wie man Jev bewertet, bevor man es in der Produktion einsetzt:
- Beginnen Sie mit einer bestehenden Entscheidung. Wählen Sie eine Aufgabe, die bereits in einem Label, einem geordneten Score oder einer Wahrscheinlichkeit endet – keine Schreibaufgabe, die in eine Klassifikations-Demo gepresst wurde.
- Frieren Sie einen repräsentativen Testdatensatz ein. Beziehen Sie einfache Fälle, mehrdeutige Fälle, seltene Labels, lange Eingaben, widersprüchliche Sprache und adversarielle Beispiele ein.
- Verwenden Sie von Menschen geprüfte Etiketten. Ein LLM-Konsens kann die Exploration anstoßen, aber die Produktionsgenauigkeit sollte anhand eines Standards gemessen werden, den Menschen genehmigt haben.
- Kalibrierung messen, nicht nur Genauigkeit. Gruppieren Sie Vorhersagen nach Wahrscheinlichkeit und überprüfen Sie, ob das Vertrauen mit der beobachteten Richtigkeit übereinstimmt.
- Schwellenwerte nach den Konsequenzen festlegen. Optimieren Sie den Kompromiss zwischen falsch-positiven und falsch-negativen Ergebnissen für die tatsächliche Entscheidung. Ein Marketing-Tag und eine Zahlungsblockierung sollten keinen gemeinsamen Schwellenwert haben.
- Vergleiche die Gesamtkosten der Aufgabe. Beinhaltet Wiederholungen, Ausweichaufrufe LLM, menschliche Überprüfungen, Netzwerke und Technik – nicht nur den Tokenpreis.
- Verankere die Modellversion. Verwenden
jev-1.13.0für eine reproduzierbare Bewertung; wechseln zujev-latestnur mit Regressionstests. - Sicher protokollieren. Zeichnen Sie genug auf, um die Entscheidung zu debuggen, ohne sensible Quelltexte länger als nötig zu speichern.
Jev API Zugriff in klarem Englisch
Jev ist über den Early-Access API und Playground von TypeSafe verfügbar. Der API verwendet POST /v1/systemone, und TypeSafe bietet Python- und JavaScript-SDKs. Eine Anfrage enthält den gemeinsamen Zustand sowie eine oder mehrere Fragen. Die Antwort enthält die typisierten Ergebnisse.
Die derzeit veröffentlichten Early-Access-Limits betragen 250.000 Eingabetokens pro Sekunde und 1.200 Anfragen pro Minute, obwohl TypeSafe angibt, dass die Limits dynamisch sind, während sich die Nachfrage einpendelt. Eine Anfrage kann mehrere unabhängige Fragen enthalten, sodass ein Workflow möglicherweise nicht für jede Entscheidung einen eigenen Netzwerkaufruf benötigt.
Entwickler sollten zwei Aliase im Hinterkopf behalten. jev-latest folgt der stabilen Produktionslinie und zeigt derzeit auf Jev 1.13. jev-preview ist für den neuesten Kandidaten gedacht und zeigt derzeit auf dieselbe Version. Fixieren Sie die numerische ID, wenn eine Verhaltensänderung einen regulierten oder hochrelevanten Workflow beeinflussen würde.
Datenschutz- und Unternehmensüberlegungen
Die Datenschutzrichtlinie von TypeSafe besagt, dass Kundeneingaben nicht zur Schulung oder Feinabstimmung ihrer Modelle verwendet werden. Es wird auch angegeben, dass die Dienste in den Vereinigten Staaten gehostet werden. Die öffentliche Richtlinie verspricht nicht eine feste Null-Aufbewahrungsfrist für jede API-Anfrage; sie beschreibt die Aufbewahrung personenbezogener Daten nur so lange, wie es für die angegebenen Zwecke angemessen ist.
Das bedeutet nicht, dass Jev für Unternehmensdaten ungeeignet ist. Es bedeutet, dass Käufer die genauen Bedingungen für Datenverarbeitung, Aufbewahrung, Unterauftragsverarbeiter, Löschung, Sicherheit und regionale Anforderungen einholen sollten, die ihre Arbeitslast erfordert. Der frühe Zugang ist auch der richtige Zeitpunkt, um nach Service-Level-Vereinbarungen, Audit-Protokollen, Modellversionsbenachrichtigungen, Vorfallreaktionen und Kapazitätsgarantien zu fragen.
Häufig gestellte Fragen
Was ist Jev?
Jev ist das erste System One-Modell von TypeSafe AI. Es wandelt Text oder strukturierten Zustand in vordefinierte Optionen, Punktzahlen und Wahrscheinlichkeiten für Anwendungscode um, anstatt frei formulierten Text zu generieren.
Ist Jev ein LLM?
TypeSafe präsentiert Jev als eine neue Kategorie spezialisierter Modelle statt eines universell einsetzbaren LLM. Es versteht Zustände in natürlicher Sprache, aber seine Aufgabe ist begrenztes Entscheidungsfinden, nicht die schrittweise Textgenerierung.
Wie viel kostet Jev?
TypeSafe listet Jev 1.13 derzeit mit 0,042 $ pro Million Eingabe-Token, ohne Ausgabe-Token-Gebühr. Das Unternehmen sagt, dass die frühen Preise subventioniert sein könnten, daher sollten Produktionskäufer den aktuellen Preis überprüfen.
Wie schnell ist Jev?
TypeSafe berichtet von 70–500 ms End-to-End-Latenz für geeignete System One-Anfragen. Dies ist ein vom Anbieter gemeldeter Bereich, kein universeller SLA, und Geographie, Last, Eingabelänge und Workflow-Design können das Ergebnis verändern.
Was sind Choice, Score und Noul?
Choice wählt aus vordefinierten Labels, Score wählt einen Wert auf einer geordneten Skala, und Noul liefert eine Wahrscheinlichkeit zwischen null und eins. Choice und Score geben auch Verteilungen und einen Vertrauenswert zurück; Noul liefert die Wahrscheinlichkeit selbst.
Kann Jev halluzinieren?
Jev kann keine Ausgabe außerhalb des deklarierten Typs erfinden, was fehlerhafte oder unbestimmte Antworten verhindert. Es kann trotzdem eine semantisch falsche Entscheidung treffen, daher müssen Teams Genauigkeit, Kalibrierung, adversariales Verhalten und Schwellenwerte bewerten.
Kann Jev GPT oder Claude ersetzen?
Nein. Jev schreibt nicht, erklärt nicht, programmiert nicht, durchsucht nicht und bedient keine Werkzeuge. Es kann einige enge Klassifizierungs- oder Bewertungsaufgaben ersetzen und schwierige Fälle an ein allgemeines Modell wie GPT oder Claude weiterleiten.
Ist Jev gut für RAG?
Potentiell, als Entscheidungsebene. Jev kann beurteilen, ob Beweise ausreichend sind, Abschnitte klassifizieren, die Relevanz von Richtlinien bewerten oder eine Antwort steuern. Es erstellt standardmäßig keine Einbettungen, analysiert keine Dokumente, sortiert Kandidaten nicht neu oder verfasst die endgültige zitierte Antwort.
Ist Jev allgemein verfügbar?
Nein. Jev befindet sich im Frühzugang über TypeSafe's Playground und API ab dem 17. September 2026.
Quellen und Methodik
Dieser Artikel wurde am 17. September 2026 recherchiert. Produktdesign, Geschwindigkeit, Kosten und Benchmark-Aussagen stammen von TypeSafe AI. Artikel starten, System One Dokumentation, Modell- und Preisseite, Vertrauensleitfaden, Schnellstart, und Workflow-Bewertungsseite. Einschränkungen stammen aus dem Jev 1.13-Rauheitsleitfaden des Anbieters; Aussagen zur Datenverarbeitung stammen von seinem Datenschutzrichtlinie.
Wir kennzeichnen von Anbietern erstellte Ergebnisse als Anbieterangaben. Das Klassifizierergebnis von Malte Ubl wird als ein Bericht eines unabhängigen Praktikers aufgenommen, nicht als universeller Benchmark. Wir haben Jev selbst nicht ausgeführt und wir wandeln auch den höchsten Geschwindigkeits- oder Kostenmultiplikator von TypeSafe nicht in eine Aussage über nicht verwandte Arbeitslasten um. Preise, Aliase, Zugriff und frühe Begrenzungen können sich nach der Veröffentlichung ändern.
Der entscheidende Punkt
Jev ist interessant, weil es eine Gewohnheit in der KI-Software infrage stellt, die normal geworden ist: jede semantische Aufgabe an ein Modell zu senden, das zum Schreiben gebaut wurde. Viele Produktionsentscheidungen benötigen keinen Aufsatz. Sie benötigen ein bekanntes Label, eine geordnete Bewertung oder eine Wahrscheinlichkeit, auf die der Code reagieren kann.
Die erste Veröffentlichung von TypeSafe macht ein ehrgeiziges Argument für diese spezialisierte Schicht geltend. Der Preis ist gering, die berichtete Latenz wird in Millisekunden gemessen, der Ausgabevertrag ist eng, und Unsicherheit steht der Anwendung zur Verfügung. Die Launch-Bewertungen und frühen Entwickler-Tests machen Jev eine ernsthafte Erprobung wert.
Die Grenzen sind Teil der Idee, nicht ein nachträglicher Gedanke. Jev kann sich nicht selbst erklären, sollte keine Arithmetik oder Datumslogik durchführen, kann immer noch falsch klassifizieren und bleibt anfällig für schlechten Kontext und adversariale Anweisungen. Es gehört zwischen deterministischen Code und ein universelles LLM – nicht über beide.
Wenn diese Architektur bei realen Daten funktioniert, könnte das „System One-Modell“ zu einer nützlichen Kategorie werden. Jev muss GPT, Claude oder einen trainierten Klassifikator nicht ersetzen, um von Bedeutung zu sein. Es muss nur genügend der kleinen Entscheidungen um sie herum schneller, kostengünstiger und mit einem klareren Vertrag bewältigen.