

- أدوات الذكاء الاصطناعي
- الذكاء الاصطناعي
ما هو Jev؟ شرح نموذج System One لـ TypeSafe AI
Jev هو نوع جديد من نماذج الذكاء الاصطناعي تم إنشاؤه لإرجاع قرارات مكتوبة بسرعة بدلاً من النثر. إليك كيف يعمل System One، وما تكلفته، وأين يناسب، وما قد تثبته الأدلة المبكرة—وما لا تثبته.
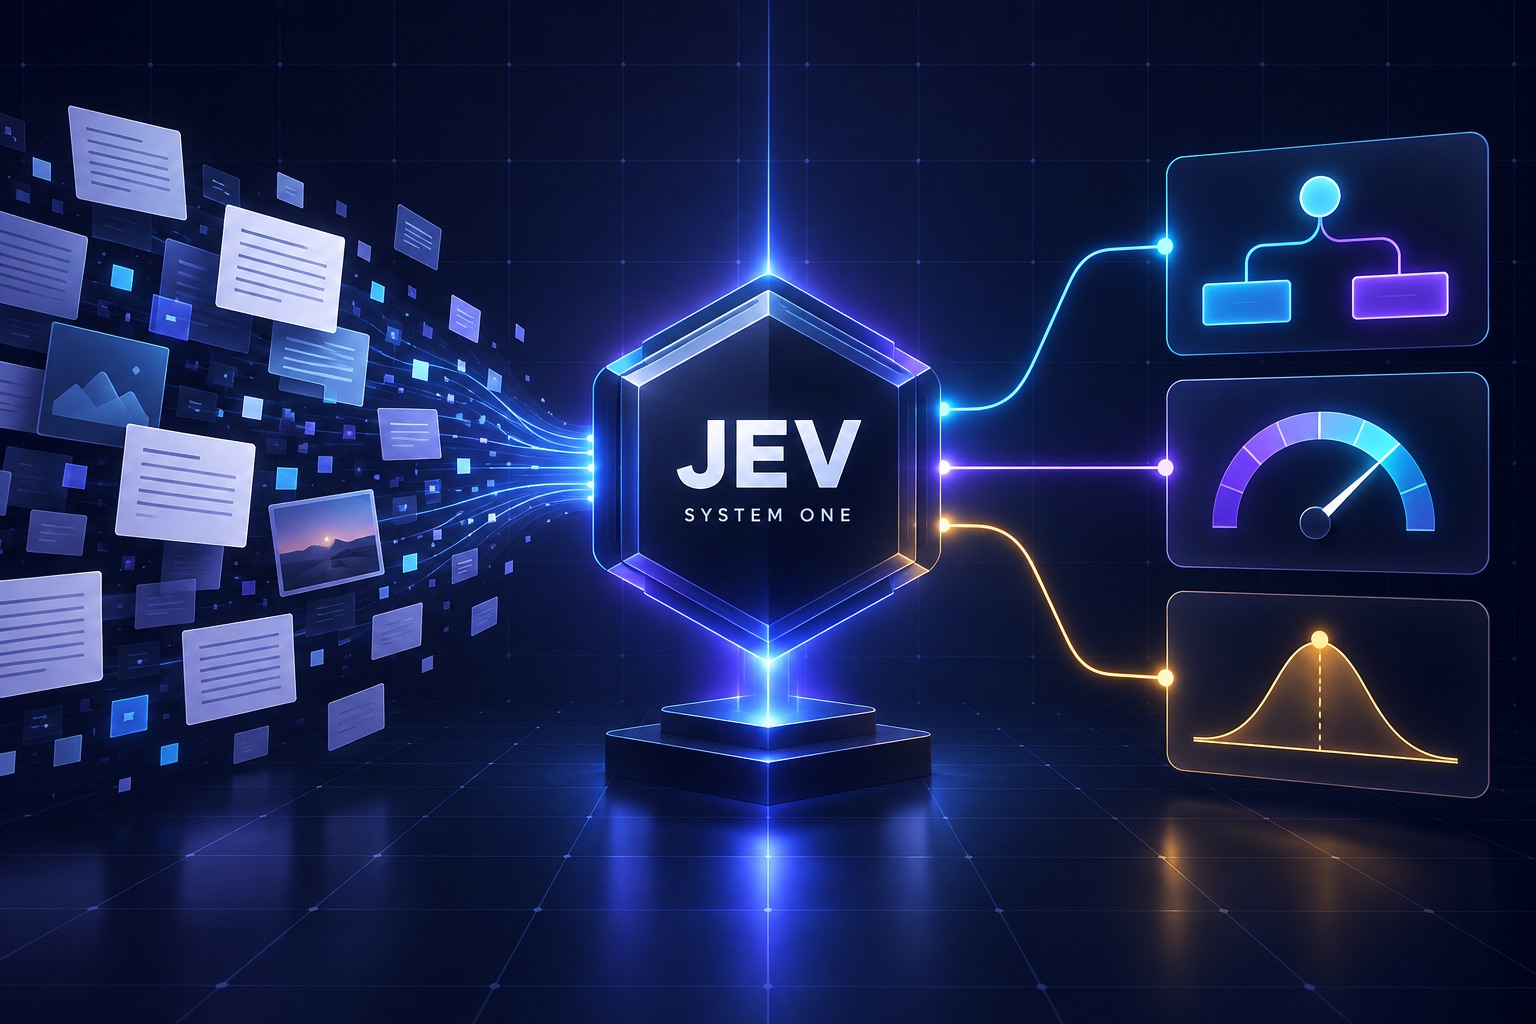
معظم نماذج الذكاء الاصطناعي تم بناؤها لتقول شيئًا ما. نموذج Jev تم بناؤه لاتخاذ قرار بشيء ما—وعرض الإجابة في شكل يمكن للبرمجيات استخدامه على الفور.
تصل رسالة من العملاء. هل هي فواتير، دعم، أم مبيعات؟ يبدو أن المقطع المسترجع ذا صلة. هل هو قوي بما يكفي لإرساله إلى نموذج الإجابة؟ يقترح وكيل إجراءً ما. هل يجب أن يسمح سير العمل بذلك، يمنعه، أم يطلب من شخص ما؟
هذه ليست مهام كتابة حقًا. إنها أحكام صغيرة مدفونة داخل البرمجيات. غالبًا ما تسند الفرق هذه المهام إلى نموذج لغوي عام الغرض لأنه أداة الذكاء الاصطناعي التي يمتلكونها بالفعل. النموذج يقرأ المدخلات، يولد ردًا على شكل رمز واحد في كل مرة، والتطبيق يقوم بتحليل الإجابة إلى تصنيف، تقييم، أو قيمة منطقية.
TypeSafe AI تم تقديمها Jev في 15 سبتمبر 2026 كنموذج من نوع مختلف. تسمي الشركة هذه الفئة System One موديلات: الحالة غير المنظمة تدخل، بينما تخرج الخيارات المحدودة، والدرجات، والاحتمالات، والثقة. Jev لا يتحدث أو يشرح أو يكتب الكود. يتخذ قرارات دلالية ضيقة.
يبدو هذا فرقا صغيرا. قد يكون فارقا مهما. إذا استمرت ادعاءات Jev المبكرة من السرعة والتكلفة والمعايرة من اختبارات أوسع، فقد تتوقف التطبيقات عن استخدام نموذج لغوي كبير لكل فرع صغير في سير العمل. النتيجة لن تحل محل LLM. بل ستمنح LLM — وبقية البرمجيات المحيطة بها — طبقة قرار أسرع.
يشرح هذا الدليل ما هو Jev، وما معنى "System One"، وكيف تعمل أسئلة الاختيار والدرجة وأسئلة Noul، وكم تكلفته، وما الذي تظهره أدلة المعيار، وأين تهم حدوده. للاطلاع على المواصفات المدمجة والمصادر الأولى، انظر صفحة Jev 1.13 النموذج أو تصفح الجديد فئة نماذج اتخاذ القرار بالذكاء الاصطناعي.
إجابة سريعة — تم التحقق في 17 سبتمبر 2026
Jev 1.13 هو أول نموذج System One من TypeSafe AI. يقبل النصوص، JSON، أو مصفوفات من النصوص مع أسئلة محددة مسبقًا، ثم يعيد قرارات مكتوبة مع الاحتمالات. تدرجه TypeSafe عند 0.042 دولار لكل مليون رمز إدخال مع إخراج مجاني وتقرير عن الكمون المعتاد من البداية إلى النهاية 70–500 مللي ثانية للمهام المناسبة. هو في الوصول المبكر. هذه الأرقام منشورة من قبل المزود، وليست ضمانات عامة.
| حقيقة Jev | التفاصيل الحالية |
|---|---|
| المطور | TypeSafe AI |
| النموذج الحالي | Jev 1.13; API المعرف jev-1.13.0 |
| الإصدار | 15 سبتمبر 2026 |
| ما يُرجع | الخيارات، الدرجات الترتيبية، الاحتمالات، وإشارات الثقة |
| ما لا يُرجع | النصوص المفتوحة، الشروحات، الأكواد، الصور، الصوت، أو الفيديو |
| سعة الإدخال | 64 ألف رمز لكل طلب؛ الحالة بالإضافة إلى أطول سؤال حتى 32 ألف رمز |
| السعر | 0.042 دولار لكل مليون رمز مدخل؛ الإخراج مجاني |
| سرعة النشر | من 70 إلى 500 مللي ثانية من البداية للنهاية لاستعلامات على شكل System One |
| وصول | الوصول المبكر لـ Playground وAPI مع SDKs للبايثون وجافا سكريبت |
ما هو ذكاء Jev الصناعي؟
Jev هو نموذج متخصص لإصدار أحكام محدودة على النص أو الحالة المنظمة. بدلاً من توجيهه لـ "كتابة كائن JSON" وأمل أن يتبع الرد الناتج الصيغة، يُحدد المطور الإجابة الممكنة قبل الاستدلال. ثم يُرجع Jev إحدى تلك القيم المسموح بها — أو درجة أو احتمال — مع معلومات عن عدم اليقين.
أسهل نموذج ذهني هو مصنف قادر جدًا يمكنه فهم اللغة الطبيعية، والنظر في العديد من الأسئلة في وقت واحد، وكشف مدى يقينه. هذا الوصف أكثر فائدة من التعامل مع Jev كمحادثة صغيرة. فهو مصمم ليجلس داخل التطبيق، لا ليكون التطبيق نفسه.
نمط Jev
الحالة غير المنظمة → Jev → الخيار + النتيجة + الاحتمالية → رمز التطبيق
النموذج يتعامل مع الحكم الدلالي. الشيفرة لا تزال تتحكم في القاعدة، العتبة، التأثير الجانبي، سجل التدقيق، وخطة الطوارئ.
افترض أن نظام الدعم يتلقى: "قمت بالترقية أمس، ولكن تم خصم بطاقتي مرتين وما زال الدفع الإضافي لم يختفِ." يمكن لطلب واحد من نوع Jev أن يسأل عما إذا كانت الرسالة تتعلق بالفواتير، ومدى استعجالها، وما إذا كان يجب تصعيدها، وما مدى احتمالية احتوائها على معلومات حساسة للحساب. كل سؤال له شكل إخراج محدد. يمكن للتطبيق توجيه التذكرة دون تحليل الفقرة.
الاسم المستعار الحالي jev-latest يتم حله إلى jev-1.13.0. معظم القراء لا يحتاجون إلى حفظ هذا المعرف؛ فهو مهم بشكل رئيسي للاختبارات الإنتاجية القابلة لإعادة الإنتاج. الفكرة الأوسع هي المنتج: Jev هو العضو الأول في فئة تتوقع TypeSafe أن تتعامل مع العديد من القرارات الصغيرة المتعلقة بالوكلاء، والبحث، والإشراف، والعمليات، وتدفقات عمل العملاء.
لماذا يُطلق عليه نموذج "System One"؟
يستعير الاسم من الإطار المعروف للنظام 1 والنظام 2 الذي شاع بواسطة عالم النفس دانيال كانيمان. يصف النظام 1 الأحكام السريعة والحدسية؛ بينما يصف النظام 2 التفكير الأبطأ والمتعمد. التشبيه ليس ادعاءً بأن Jev يفكر مثل الإنسان. إنه يصف الوظيفة التي تم تحسين النموذج لأدائها.
نموذج LLM الرائد مثل GPT-6 Astra أو Claude Fable 5.1 تم تصميمه للعمل الواسع والتوليدي: التحقيق في مشكلة، استخدام الأدوات، كتابة الكود، شرح المقايضات، أو إنتاج مستند. Jev محدد بشكل متعمد. يقرأ الحالة المتاحة ويعيد قرارًا صغيرًا بسرعة.
تقول TypeSafe إن البنية تستخدم parallel sampler بدلاً من توليد إجابة رمزًا رمزًا. تقول وثائقها أيضًا أن الأسئلة في نفس الطلب تُقيَّم بشكل مستقل وبالتوازي. هذا يعني أن إضافة عدة أسئلة تصنيف أو تقييم يجب أن يكون لها عقوبة زمنية أقل بكثير مقارنة بطلب LLM العام لمعالجتها بشكل متسلسل.
درّبت الشركة Jev باستخدام RLCD، اختصارًا لـ Reinforcement Learning for Calibrated Decisions. الهدف المهم للمستخدم النهائي هو المعايرة: عبر العديد من التنبؤات المماثلة، يجب أن تكون احتمالية 80٪ صحيحة تقريبًا 80٪ من الوقت. المعايرة لا تعد بأن تكون الإجابة الفردية صحيحة. إنها تجعل عدم اليقين أكثر فائدة للتوجيه وتحديد العتبات.
الاختيار، النتيجة، وNoul: أنواع الأسئلة الثلاثة لـ Jev
يُعرّض Jev حاليًا ثلاثة عناصر أساسية. معًا، تغطي حصة كبيرة من الأحكام الصغيرة المخفية داخل برامج الأعمال.
الاختيار يحدد من مجموعة مسموح بها
يسمح سؤال الاختيار لـ Jev بقائمة ثابتة من التصنيفات: الفوترة، الدعم الفني، المبيعات، الإلغاء، أو شيء آخر. تتضمن الاستجابة التصنيف المختار، وتوزيع الاحتمالات عبر الخيارات المتاحة، وقيمة الثقة المستمدة من هذا التوزيع.
يناسب هذا تصنيف النوايا، توجيه الطوابير، اختيار السياسات، ووسم المحتوى، وتحديد الأداة أو الوكيل الذي يجب أن يستلم مهمة. توثيق TypeSafe يدعم ما يصل إلى 255 خيارًا. بالنسبة لمجموعات التصنيفات الكبيرة جدًا، فإن إرشاداته الخاصة هي تضييق المجال ثم اتخاذ قرار ثانٍ بدلاً من التعامل مع مئات الخيارات المتشابهة تقريبًا كمشكلة واحدة مسطحة.
التقدير يضع عنصرًا على مقياس مرتب
سؤال النتيجة يحدد نطاقًا مرتبًا — على سبيل المثال، الإلحاح من واحد إلى خمسة أو جودة العميل المحتمل من صفر إلى عشرة. تعيد Jev نتيجة مع التوزيع على القيم المسموح بها وإشارة الثقة.
تكون الدرجات مفيدة عندما يكون الفرق بين النتائج المجاورة مهمًا. درجة المخاطرة أربعة أقرب إلى خمسة منها إلى واحد؛ مجموعة بسيطة من التسميات غير المرتبطة لا تعبر عن هذا الترتيب. يمكن للتطبيقات تحويل النتيجة إلى مستويات خدمة، قوائم مراجعة، حدود، أو أولويات.
تقدر Noul احتمال صحة بيان معين.
سؤال Noul يطلب قيمة بين صفر وواحد: ما مدى احتمال أن يجيب هذا المقطع على الاستعلام، ما مدى احتمال أن ينتهك الطلب قاعدة ما، أو ما مدى احتمال أن يشير أثر هذا الوكيل إلى فشل؟ تعيد Noul الاحتمال مباشرة. على عكس Choice و Score، لا تضيف الاستجابة الحالية لـ Noul خاصية ثقة منفصلة.
الاسم الغريب أقل أهمية من النمط. بدلاً من إجبار النموذج على قول “نعم” أو “لا” عند حد تعسفي، تتلقى التطبيق احتمالية ويختار الحد نفسه. قد يقبل قرار تخصيص غير ضار 0.65. قد تتطلب عملية دفع عالية المخاطر أو إجراء أمني 0.98 وفحصًا ثانيًا.
هل لدى Jev حقًا “صفر الهلوسات”؟
تستخدم TypeSafe لغة قوية حول الهلوسة لأن Jev لا يمكنه اختراع فئة رابعة عندما يسمح المخطط بثلاث فقط، أو إعادة فقرة حيث يتوقع الكود رقمًا، أو الارتجال بحقل غير معروف. هذه هي تحسين موثوقية معنوي. للإستجابة محدود. الشكل
هذا لا يعني أن الحكم دائما صحيح. لا يزال بإمكان Jev اختيار تسمية خاطئة، أو منح درجة عالية جدا، أو فهم أمر غير مباشر، أو أن يصبح أقل موثوقية عندما يكون المدخل معاديا أو مليئا بمواد غير ذات صلة. TypeSafe الخاص دليل خشونة Jev 1.13 توثّق تلك النقائص.
طريقة دقيقة لقول ذلك هي:
- هلوسة المخطط مقيدة. يجب أن يتوافق الناتج مع نوع القرار المعلن.
- الخطأ الدلالي لا يزال ممكنًا. يمكن أن يكون التصنيف الصحيح لا يزال تصنيفًا خاطئًا.
- الثقة تساعد في إدارة الأخطاء. يمكن أن يؤدي إلى المراجعة أو الاسترجاع الاحتياطي، لكنه ليس دليلاً.
هذا التمييز مهم لكل نظام ذكاء اصطناعي منظم. يمكن لوضع JSON في LLM عام أن يضمن حقولًا قابلة للتحليل بينما تظل القيم داخل تلك الحقول خاطئة. يقلل Jev المشكلة أكثر من خلال تخصيص النموذج بالكامل حول القرارات المحدودة، ولكن فرق الإنتاج لا تزال بحاجة إلى التقييمات والحدود الآمنة.
ما مدى سرعة Jev وتكلفته المنخفضة؟
تدرج صفحة النموذج الحالية لـ TypeSafe Jev 1.13 عند 42 دولارًا لكل مليار رمز إدخال، وهو ما يعادل 0.042 دولار لكل مليون رمز إدخال. الإخراج مجاني لأن Jev لا يولد استجابة طويلة. بهذه الوتيرة، ستستخدم مليون طلب تصنيف من 500 رمزًا 500 مليون رمز إدخال وستتحمل تكلفة قائمة النماذج حوالي $21، قبل أي نفقات للتطبيق أو التخزين أو الشبكة أو مراجعة الإنسان.
تقرير منشور الإطلاق ٧٠ إلى ٥٠٠ ميلي ثانية من البداية إلى النهاية للمهام المصممة لـ System One، وتدعي تحقيق سرعات أسرع بمقدار 40× إلى 200× مقارنة بالنماذج العامة المستخدمة في المقارنات الخاصة بها. هذه الأرقام تحتاج إلى السياق الذي يقدمه TypeSafe نفسه:
- تم تشغيل معظم اختبارات التوقيت من أجهزة الكمبيوتر المحمولة على الساحل الغربي للولايات المتحدة؛
- تم تصميم تقييمات سير العمل الأربعة بواسطة فريق TypeSafe؛
- تم اشتقاق تسميات المقارنة من استجابات GPT-6 Astra و Claude Fable 5.1 عالية التفكير بدلاً من تسميات الذهب البشرية المستقلة؛ و
- تقول الشركة إن التسعير المبكر قد يكون مدعومًا ولا يجب افتراض أنه دائم.
بعبارة أخرى، الأدلة على الإطلاق واعدة، لكنها ليست حاسمة. الحد الأقصى المعلن—193.6× أسرع و444.6× أرخص—يمثل الطرف المفضل لمجموعة من المهام التي يديرها المزود، وليس عامل تحويل عالمي لكل مكالمة LLM.
ما الذي تظهره تقييمات Jev المبكرة في الواقع
تنشر TypeSafe أربع تقييمات سير عمل تغطي تصنيف الحوادث الأمنية، ومراقبة أثر الوكيل، ومعالجة الفواتير، وقرارات خدمة العملاء. كل سير عمل يقوم بتفكيك موجه واسع إلى عدة أسئلة محددة النوع، ثم يقارن الدقة والتكلفة والوقت مع معيار نموذج عام.
النتيجة المركزية أقل ما يكون عن لوحة الصدارة وأكثر عن نمط سير العمل. إذا انتهت مهمة إلى مجموعة صغيرة من التصنيفات أو الأرقام، يمكن لنموذج متخصص أن يتجنب دفع LLM لتكوين وتسلسل إجابة لم يكن بحاجة لكتابتها. يمكن للأسئلة المتوازية أيضًا أن تحل محل عدة استدعاءات منفصلة.
هناك دليل مفيد واحد من خارج السياق. كتب المهندس مالتي أوبل أنه أجرى Jev مقابل تقييم مصنف موجود كان قد استخدم Gemini 2.5 Flash-Lite؛ في هذا الاختبار الواحد، أشبع Jev تقييم الجودة وعمل أسرع بحوالي ست مرات. ذاك التقرير يشجّع لأن التقييم سبق Jev، لكنه لا يزال اختبار مطور واحد فقط—ليس مجموعة معيارية مستقلة واسعة.
لشرح بصري سريع، نشر ماتيا سوسيتش ملخص Jev لمدة 45 ثانية. كما شارك ستيف كروز demo صغير حي مما يجعل نمط الحالة والأسئلة أسهل للفهم مقارنة بجدول المعايير.
الدلائل كافية لتبرير اختبار Jev. لكنها ليست كافية بعد للإعلان بأن Jev يتفوق على كل LLM صغيرة، المصنّفات، المعاد ترتيبها، أو محركات القواعد. يجب أن يستخدم التقييم العادل أمثلة مجمّدة من المنتج الفعلي، علامات مراجعة بشرية، نفس مسار الشبكة، وسياسة الحد الأقصى المختارة قبل رؤية النتائج.
Jev مقابل LLMs: ما المختلف فعلياً؟
| البُعد | Jev / System One | LLM متعدد الأغراض |
|---|---|---|
| الوظيفة الرئيسية | اختيار، تقييم، أو تقدير الاحتمالية | التوليد، الاستدلال، الشرح، البرمجة، واستخدام الأدوات |
| الإخراج | قيم مكتوبة محددة مسبقًا | رموز مفتوحة النهاية، يمكن تقييدها اختياريًا بـ JSON |
| عدم اليقين | توزيعات الاحتمالات الأصلية والثقة حيثما كان مدعومًا | عادة لا يتم كشفها كإشارة تطبيقية معايرة |
| أسئلة متعددة | أسئلة مستقلة يتم تقييمها بالتوازي | غالبًا ما يتم الرد عليها في تسلسل واحد مولد أو عدة استدعاءات |
| أفضل في | قرارات معنوية ضيقة عالية الحجم | العمل الغامض أو الإبداعي أو متعدد الخطوات أو الشارح |
| لا يمكنه القيام بـ | كتابة النثر أو الأكواد أو الشروحات | يمكنه توليد الثلاثة جميعًا |
لذا، المقارنة الصحيحة ليست "هل يمكن لـ Jev التغلب على نموذج متطور؟" بل هي "لماذا نطلب من نموذج متطور القيام بهذه المهمة المحددة؟" يظل A أكثر مرونة. يمكنه استخراج حقل، إعادة كتابة رسالة، استدعاء أداة، وشرح إجابته في نفس الطلب. يضحّي Jev بهذه المرونة مقابل عقد أكثر صرامة. نموذج عام صغير مثل GPT-5.6 Luna أو Claude Haiku 4.5
Jev مقابل الإخراج الهيكلي أو وضع JSON
الإخراج الهيكلي هو أقرب بديل مألوف. يعطي المطور لـ LLM مخططًا؛ يقيّد المزود الاستجابة المولدة بحيث تكون قابلة للتحليل. هذا مفيد جدًا عندما يحتاج التطبيق إلى كائن غني بالأسماء والوصف والتواريخ أو الحقول المولدة الأخرى.
Jev يتوافق بشكل أفضل مع مساحة مخرجات أصغر. الإجابات موجودة بالفعل؛ النموذج يختارها أو يقيمها فقط. هناك نتائج أقل لتوليدها، وتوزيع الاحتمالات جزء من المنتج، والهندسة بالكامل مُحسّنة حول قرار الاختيار. استخدم وضع JSON عندما تحتاج إلى محتوى مولَّد داخل هيكل. اعتبر استخدام Jev عندما تكون كل إجابة صالحة معروفة بالفعل.
Jev مقابل المصنف التقليدي
يمكن أن يكون المصنف التقليدي سريعًا جدًا وغير مكلف بعد التدريب. قد يكون الخيار الأفضل لمشكلة مستقرة ذات حجم كبير ومع وجود بيانات مصنفة كافية. جاذبية Jev هي أنها تحاول دمج مرونة اللغة الطبيعية وإعدادات الإرشاد القليل (few-shot) في هذا النوع من العمل دون مطالبة كل فريق بتدريب وتشغيل نموذج منفصل.
المقايضة هي التحكم. يمكن ضبط مصنف مخصص حول تصنيف ضيق، وفحصه باستخدام مقاييس مألوفة، ونشره في بيئة خاصة. Jev هو حالياً خدمة وصول مبكر مستضافة. يجب على الفرق مقارنة ليس فقط الدقة والزمن المستغرق، بل أيضاً موقع البيانات، واحتياجات إعادة التدريب، وتغير التصنيفات، وجهد التشغيل.
Jev مقابل إعادة الترتيب
إعادة الترتيب مثل Cohere إعادة الترتيب 4 سريع يأخذ استعلامًا ومجموعة من الوثائق المرشحة، ثم يرتب هذه المرشحات حسب الصلة. يمكن لـ Jev أن يسأل ما إذا كانت فقرة تجيب عن سؤال أو تقييم فقرة مقابل معيار، لكنه ليس نموذج إعادة ترتيب تلقائي يمكن استبداله بنفس هدف التدريب وعقد البحث المخصص.
بالنسبة لـ RAG، يمكن للأدوات أن تكمل بعضها البعض. يقوم الاسترجاع بالعثور على المرشحين، ويقوم إعادة الترتيب بترتيبهم، ويمكن لـ Jev اتخاذ قرار محدود مثل "هل الدليل الأعلى كافٍ للإجابة؟" أو "أي موضوع سياسي يدعمه هذا المقطع؟" ثم يقوم نموذج أكبر بكتابة الإجابة المذكورة فقط عندما يقول طبقة القرار إن الدليل كافٍ.
أين يمكن أن يكون Jev مفيدًا
1. توجيه الطلبات وعمل الوكلاء
يمكن لـ Jev تصنيف الطلب الوارد، اختيار وكيل متخصص، تقييم الاستعجال، واتخاذ قرار بشأن ما إذا كان يجب على شخص ما مراجعته. نظرًا لأن كل مخرج محدود، لا يحتاج المنسق إلى تفسير إجابة سردية قبل اتخاذ الخطوة التالية.
2. إضافة بوابات الثقة إلى وكلاء الذكاء الاصطناعي
يمكن للوكيل اقتراح إجراء في حين يقوم Jev بشكل منفصل بتقييم ما إذا كان الإجراء يتوافق مع هدف المستخدم، أو يقع ضمن السياسة، أو يبدو مكتملًا. يمكن أن تتوقف الحالات منخفضة الثقة. هذا ليس حدودًا أمنية كاملة—لا يزال من الممكن التأثير على النموذج بواسطة مدخلات خبيثة—لكن يمكن أن يضيف فحصًا دلاليًا سريعًا قبل أن يطبق الكود القاعدة النهائية.
3. تحسين RAG والبحث في المؤسسات
تستخدم أنظمة المستندات بالفعل طبقات متخصصة: محلل مثل Cohere Parse أو الأدوات مفتوحة المصدر في دليل Docling استعادة البنية؛ تسترجع التضمينات المرشحين؛ تعيد ترتيبهم أدوات إعادة الترتيب. يمكن لـ Jev إضافة قرار آخر: ما إذا كانت الأدلة كافية، متناقضة، حساسة، قديمة، أو مناسبة لمسار إجابة معين.
4. الفرز، التقييم، والعمليات
العملاء المحتملون، تذاكر الدعم، الفواتير، تقارير الحوادث، المراجعات، وتتبع الوكلاء كلها تحتوي على لغة غير منظمة تتحول في النهاية إلى قائمة انتظار أو درجة. تم تصميم Jev لهذا التحويل. تكون القيمة الأعلى عندما يتغير التصنيف بشكل متكرر بما يكفي لجعل المصنف المخصص غير مريح ولكن يظل الناتج محدودًا بما يكفي بحيث لا تكون الغة النثرية ضرورية.
5. اتخاذ قرارات التجميع والتقليل عبر العديد من العناصر
يمكن لسير العمل تطبيق نفس السؤال بشكل مستقل عبر المقاطع، والسجلات، والرسائل، أو نطاقات التتبع، ثم السماح للشفرة بتجميع النتائج. هذا يحافظ على تركيز النموذج على الأحكام الدلالية المحلية بينما تتعامل الشفرة الحتمية مع العد، والحدود، والاختيار النهائي.
حيث لا يكون Jev الأداة المناسبة
TypeSafe صريح على نحو غير معتاد حول الحواف الوعرة لـ Jev. تلك الشفافية مفيدة لأن نموذج متخصص يمكن أن يبدو ذكياً بشكل واسع في عرض تجريبي واحد ويفشل في مهمة مجاورة.
- لا تستخدمه للكتابة. لا يستطيع Jev صياغة رد أو شرح أو ملخص أو سطر من التعليمات البرمجية.
- احتفظ بالحساب في الكود. يوثق المزود نقاط الضعف في العد والحساب والدقة العددية.
- احتفظ بمنطق التاريخ في الشفرة. مقارنة التواريخ والأوقات هي نقطة ضعف موثقة.
- اكتب الأسئلة حرفيًا. يمكن للتعليمات غير المباشرة أو المتداخلة أن تقلل من الموثوقية.
- قم بإزالة السياق غير ذي الصلة. يمكن أن تؤذي كميات كبيرة من الحالة غير المتعلقة القرار حتى عندما تتناسب مع حد السياق.
- اختبار الإدخال العدائي. لا يزال بإمكان حقن التعليمات والتعليمات المتناقضة توجيه النموذج.
- لا تخلط بين المعايرة واليقين. قيمة الثقة العالية تحتاج إلى التحقق على بيانات المنتج الخاصة.
قاعدة جيدة هي ترك الحقائق الحتمية للأنظمة الحتمية. يجب على الكود حساب الإجماليات، مقارنة الطوابع الزمنية، التحقق من الأذونات، فرض الحدود، وتنفيذ التأثيرات الجانبية. يجب على Jev التعامل مع الجزء الذي يتطلب بالفعل حكمًا دلاليًا.
هندسة عملية: استخدم Jev بجانب LLM
أقوى تصميم مقنع هو التسلسل المتدرج بدلاً من الاستبدال:
- يقوم الكود بإجراء فحوصات صارمة. تحقق من المصادقة والحدود والحقول المطلوبة والتواريخ والقواعد الرقمية.
- يقوم Jev باتخاذ القرار الدلالي الضيق. صنّف الطلب، قدّر المخاطر، أو قيّم ما إذا كانت الأدلة كافية.
- تقرأ سير العمل حالة عدم اليقين. اقبل قرارًا واثقًا منخفض المخاطر، أو وجه حالة غامضة إلى نموذج أكبر، أو اسأل شخصًا.
- يتعامل LLM مع العمل التوليدي. اكتب الرد، وابحث في القضية، واستخدم الأدوات المعتمدة، أو اشرح النتيجة.
- الشفرة هي المسؤولة عن الإجراء. سجل القرار وإصدار المصدر، وطبق السياسة، وقم بإجراء تغيير الحالة النهائي.
يمكن لهذا التخطيط الاحتفاظ بالاستدلال المكلف للحالات التي تحتاجه. يمكنه أيضًا جعل التدقيق على الوكيل أسهل: يحتوي سجل القرار على السؤال، والإجابات المسموح بها، والاحتمالية، والحد، والمسار المحدد، وإصدار النموذج بدلاً من فقرة غامضة قد فسرها مكون آخر.
كيفية تقييم Jev قبل استخدامه في الإنتاج:
- ابدأ بقرار موجود بالفعل. اختر مهمة تنتهي بالفعل بتسمية، أو درجة مرتبة، أو احتمال — وليس مهمة كتابة مضغوطة في عرض تصنيف.
- جمد مجموعة اختبار تمثلية. قم بتضمين الحالات السهلة، والحالات الغامضة، والتسميات النادرة، والمدخلات الطويلة، واللغة المتناقضة، والأمثلة العدائية.
- استخدم تسميات مراجع عليها من قبل البشر. يمكن للاتفاق على LLM أن يعزز الاستكشاف، لكن يجب قياس دقة الإنتاج مقابل معيار وافق عليه الأشخاص.
- قم بمعايرة القياس، وليس الدقة فقط. قم بتجميع التنبؤات حسب الاحتمالية وتحقق مما إذا كانت الثقة تتوافق مع الصحة الملحوظة.
- حدد العتبات حسب العواقب. تحسين الموازنة بين الإيجابيات الكاذبة والسلبيات الكاذبة للقرار الفعلي. لا يجب أن يشترك وسم التسويق واحتجاز الدفع في نفس العتبة.
- قارن تكلفة المهمة كاملة. تضمّن إعادة المحاولات، مكالمات LLM الاحتياطية، المراجعات البشرية، الشبكات، والهندسة—ليس فقط سعر الرمز.
- ثبت إصدار النموذج. استخدم
jev-1.13.0لتقييم يمكن تكراره؛ الانتقال إلىjev-latestفقط مع اختبارات الانحدار. - Log safely. سجّل ما يكفي لتصحيح القرار دون الاحتفاظ بالنص المصدر الحساس لفترة أطول من اللازم.
الوصول إلى Jev API باللغة الإنجليزية البسيطة
يُتاح Jev من خلال الوصول المبكر لـ TypeSafe إلى API و Playground. يستخدم API POST /v1/systemone، ويوفر TypeSafe حزم تطوير برمجيات (SDKs) للبايثون وجافا سكريبت. يحتوي الطلب على الحالة المشتركة بالإضافة إلى سؤال واحد أو أكثر. يحتوي الرد على النتائج المكتوبة بالنوع.
حدود الوصول المبكر المنشورة حالياً هي 250,000 رمز إدخال في الثانية و1,200 طلب في الدقيقة، على الرغم من أن TypeSafe تقول إن الحدود ديناميكية بينما يستقر الطلب. يمكن أن يحتوي الطلب الواحد على عدة أسئلة مستقلة، لذا قد لا تحتاج سير العمل إلى طلب شبكة واحد لكل قرار.
يجب على المطورين أن يحتفظوا باسمين مستعارين في أذهانهم. jev-latest يتبع خط الإنتاج المستقر ويشير حالياً إلى Jev 1.13. jev-preview مخصص لأحدث مرشح ويشير حالياً إلى نفس الإصدار. قم بتثبيت المعرف الرقمي عندما يؤثر تغيير في السلوك على سير عمل منظم أو عالي التأثير.
الخصوصية واعتبارات الشركات
تنص سياسة الخصوصية الخاصة بـ TypeSafe على أن مدخلات العملاء لا تُستخدم لتدريب أو تحسين نماذجها. كما تشير إلى أن الخدمات مستضافة في الولايات المتحدة. لا تعد السياسة العامة بتحديد فترة احتفاظ ثابتة لكل طلب API؛ بل تصف الاحتفاظ بالمعلومات الشخصية بالقدر الضروري المعقول للأغراض المعلنة.
هذا لا يعني بالضرورة أن Jev غير مناسب لبيانات الشركات. بل يعني أن على المشترين الحصول على شروط معالجة البيانات والاحتفاظ بها والعمليات الفرعية والحذف والأمن والموقع الإقليمي الدقيقة التي تتطلبها أحمال عملهم. الوصول المبكر هو أيضًا الوقت المناسب لطرح الأسئلة حول التزامات مستوى الخدمة، وسجلات التدقيق، وإشعارات إصدارات النماذج، والاستجابة للحوادث، وضمانات السعة.
الأسئلة المتكررة
ما هو Jev؟
Jev هو أول نموذج System One من TypeSafe AI. يقوم بتحويل النص أو الحالة المهيكلة إلى خيارات محددة مسبقًا، أو درجات، أو احتمالات لشيفرة التطبيق بدلاً من توليد النصوص المفتوحة.
هل Jev نموذج LLM؟
تقدم TypeSafe نموذج Jev كفئة نموذج متخصص جديدة بدلاً من LLM العام الغرض. إنه يفهم حالة اللغة الطبيعية، لكن عمله يقتصر على اتخاذ القرارات المحدودة، وليس توليد النص حرفًا بحرف.
كم سعر Jev؟
تسرد TypeSafe حاليًا Jev 1.13 بسعر 0.042 دولار لكل مليون رمز إدخال، دون أي رسوم على رموز الإخراج. وتقول الشركة إن التسعير المبكر قد يكون مدعومًا، لذا يجب على المشترين في مرحلة الإنتاج التحقق من السعر الحالي.
ما مدى سرعة Jev؟
تفيد TypeSafe بوجود زمن استجابة شامل يتراوح بين 70–500 مللي ثانية للاستعلامات المناسبة من نوع System One. هذا هو نطاق أبلغ عنه المزود، وليس اتفاقية مستوى خدمة عامة، ويمكن أن تؤثر الجغرافيا والحمل وطول الإدخال وتصميم سير العمل على النتيجة.
ما هي Choice و Score و Noul؟
يختار Choice من بين العلامات المحددة مسبقًا، ويختار Score قيمة على مقياس مرتب، وتُرجع Noul احتمالًا بين صفر وواحد. كما تُرجع Choice وScore التوزيعات وقيمة الثقة؛ وتُرجع Noul الاحتمال نفسه.
هل يمكن لـ Jev الهلوسة؟
لا يمكن لـ Jev اختراع نتيجة خارج النوع المعلن، مما يمنع الاستجابات غير الصحيحة أو المفتوحة. ومع ذلك، لا يزال بإمكانه اتخاذ قرار خاطئ دلاليًا، لذلك يجب على الفرق تقييم الدقة والمعايرة والسلوك العدائي والعتبات.
هل يمكن أن تحل Jev محل GPT أو Claude؟
لا. لا يكتب Jev أو يشرح أو يبرمج أو يتصفح أو يشغّل الأدوات. يمكنه استبدال بعض المكالمات الضيقة للتصنيف أو التقييم، ويمكنه توجيه الحالات الصعبة إلى نموذج عام مثل GPT أو Claude.
هل Jev جيد لـ RAG؟
من المحتمل، كطبقة قرار. يمكن لـ Jev تحديد ما إذا كانت الأدلة كافية، تصنيف المقاطع، تقييم مدى ملاءمة السياسات، أو التحكم في إجابة. لكنه لا ينشئ التضمينات، أو يحلل المستندات، أو يعيد ترتيب المرشحين بشكل افتراضي، أو يكتب الرد النهائي مع الاستشهادات.
هل Jev متاح عمومًا؟
لا. Jev متاح في الوصول المبكر من خلال ملعب TypeSafe و API اعتبارًا من 17 سبتمبر 2026.
المصادر والمنهجية
تمت دراسة هذا المقال في 17 سبتمبر 2026. تأتي تصميم المنتج والسرعة والتكلفة والمطالبات المعيارية من TypeSafe AI. إطلاق المقالة, توثيق System One, صفحة الطراز والتسعير, دليل الثقة, بدء سريع، و موقع تقييم سير العملالقيود تأتي من دليل Jev 1.13 المتعرج المزود؛ وبيانات معالجة البيانات تأتي من سياسة الخصوصية.
نصنّف النتائج التي يديرها المزود على أنها مطالبات المزود. نتيجة مصنّف Malte Ubl مدرجة كواحدة من تقارير الممارس المستقل، وليست كمعيار عالمي. نحن لم نجري اختبار Jev بأنفسنا، ولا نقوم بتحويل أعلى سرعة أو مضاعف تكلفة لـ TypeSafe إلى مطالبة حول أحمال العمل غير المتعلقة. يمكن أن تتغير الأسعار والأسماء المستعارة والوصول والحدود المبكرة بعد النشر.
الخلاصة
Jev مثير للاهتمام لأنه يشكك في عادة أصبحت طبيعية في برمجيات الذكاء الاصطناعي: إرسال كل مهمة دلالية إلى نموذج مصمم للكتابة. العديد من قرارات الإنتاج لا تحتاج إلى مقال. إنها تحتاج إلى تصنيف معروف، أو نتيجة مرتبة، أو احتمال يمكن للشفرة التعامل معه.
الإصدار الأول من TypeSafe يقدم حالة طموحة لتلك الطبقة المتخصصة. السعر ضئيل، والزمن المتأخر المبلغ عنه يُقاس بالمللي ثانية، وعقد المخرجات ضيق، وعدم اليقين متاح للتطبيق. التقييمات عند الإطلاق والاختبارات الأولية للمطور تجعل Jev جديرًا بالتجربة الجادة.
الحدود هي جزء من الفكرة، وليست فكرة لاحقة. Jev لا يمكنه شرح نفسه، ولا ينبغي له القيام بالعمليات الحسابية أو منطق التواريخ، ولا يزال يمكن أن يخطئ في التصنيف، ويبقى عرضة لسوء السياق والتعليمات العدائية. إنه ينتمي إلى الوسط بين الكود الحتمي وLLM العام الاستخدام — وليس فوق كليهما.
إذا ثبتت صحة هذه البنية على البيانات الحقيقية، فإن "نموذج System One" قد يصبح فئة مفيدة. Jev لا يحتاج إلى استبدال GPT أو Claude أو المصنف المدرب ليكون ذا أهمية. يحتاج فقط إلى التعامل مع عدد كافٍ من القرارات الصغيرة حولهم بشكل أسرع، وبأقل تكلفة، ومع عقد أنظف.